智能体编程陷阱
对认知债务与技能退化的持续警惕
“AI 负责写代码,而处在循环中的人类是编排者(orchestrator)”
这是目前业界正在大肆炒作的观点:传统的编程方式已基本死亡,“规范驱动开发”(Spec Driven Development, SDD)才是未来。你生成一个计划,然后就可以完全脱离写代码的过程了。智能体(Agents)比你更懂,它们会包揽所有的实现工作。而你作为专家,只需提供“良好的品味”,审查输出结果,并不断引导智能体去执行你精心制定的计划。
目前,这种工作流有多种表现形式,但总体而言,它的过程是:某人定义项目的需求(同时在微观和宏观层面上),生成一个计划,然后一遍又一遍地拉动老虎机的拉杆,通常使用多个智能体实例进行反复迭代,直到任务完成。在这个过程中,“编排者”与正在生成和提交的代码之间的距离被拉得越来越远。
编程智能体(Coding Agents)很有用,也很强大,但在量化层面已经出现了一些必须被讨论的权衡与妥协(trade-offs):
- 周边系统复杂性的增加,以缓解 AI 非确定性所带来的更高的模糊性。
- 大量人群面临技能退化(Atrophying skills)。
- 个人和整个团队的供应商锁定(Vendor lock-in)(此前 Claude Code 的宕机已经让整个团队陷入停滞)。
- 使用这些工具的成本不断波动且日益增加。员工的成本是固定的;而 Token 的消耗却是一个不断移动的靶子。
要想成功应用这种编程智能体的方法,取决于一个相当关键的要素:只有一位具备批判性思维、且能游刃有余地在架构层面思考的熟练开发者,才能在成千上万行生成的代码成为问题之前,敏锐地发现其中的隐患。
然而,命运却开了一个讽刺的玩笑:现在已有证明,AI 工具恰恰会对个人的批判性思维能力和认知清晰度产生负面影响。
这不仅仅是另一种“抽象”
我们在社区经常听到一种陈词滥调:程序员只是在“技术栈上往上走”,进入了另一种类型的抽象。且不说这些工具到底算不算是一个抽象层,这本身就还没有定论;更高的模糊性,并不等于更高层次的抽象。
退一步讲,程序员确实倾向于对新语言和新的编程方式保持警惕。当 FORTRAN 发布时,程序员们也曾对它持怀疑态度。他们当时的论调很相似:它可能会引入更多的 Bug 和不稳定性,直接写汇编效率更高。后来,围绕编译器引入了太多“魔法”的讨论也曾甚嚣尘上。这些都是基于规范性(normative)的论证,源于对接受这些新技术可能会失去什么的恐惧。
今天正在发生的事情与以往不同之处在于,过去的恐惧是推测性和理论性的。而在 AI 工具问世短短几年内,我们已经看到了重大的影响。受到影响的不仅仅是初级开发者,甚至包括那些拥有十年(或更久)经验的人:
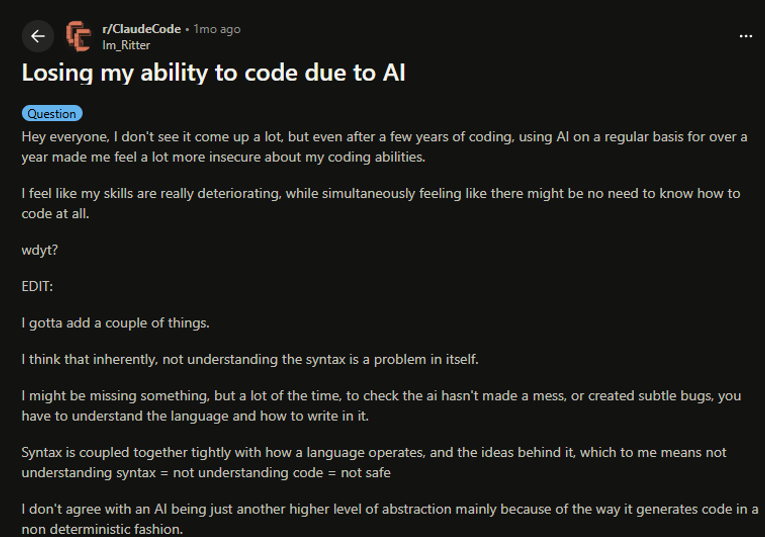
(图:编程智能体悖论)
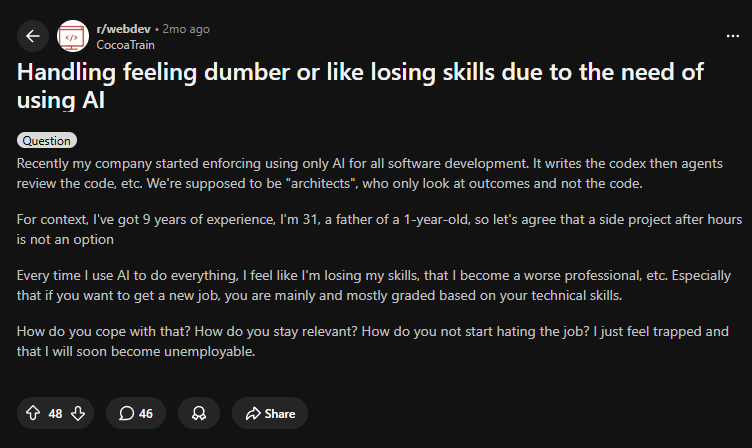
(图:编程智能体悖论)
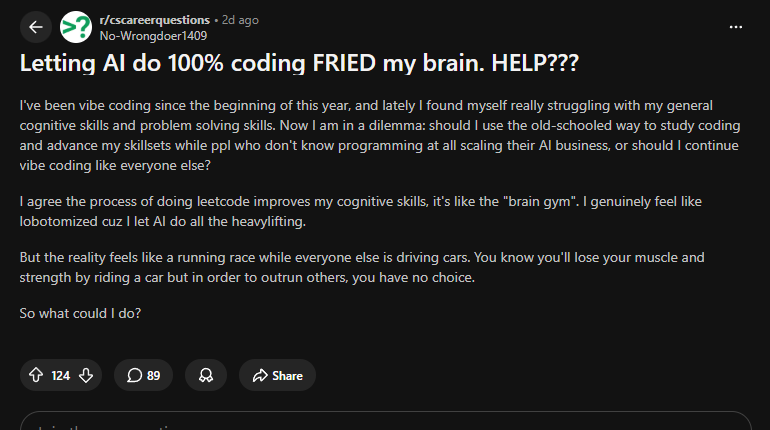
(图:编程智能体悖论)
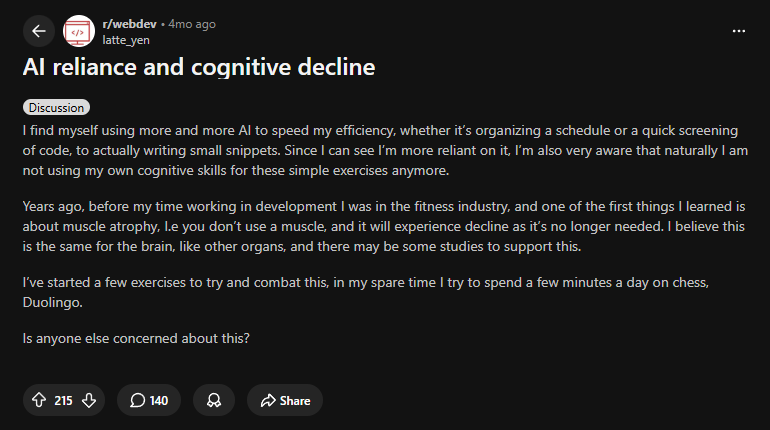
(图:编程智能体悖论)
对于初级开发者来说,他们面临的攀登之路变得更加陡峭。因为我们切断了他们直接处理代码的能力,取而代之的是让他们去审查生成的代码。审查代码固然重要,但它最多只占学习过程的 50%。如果没有直接与代码打交道所带来的摩擦和挑战,他们的学习能力将大打折扣。
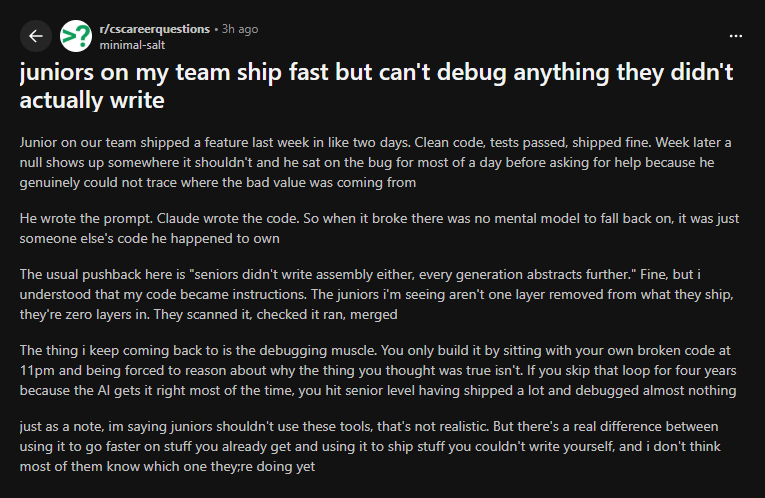
(图:编程智能体悖论)
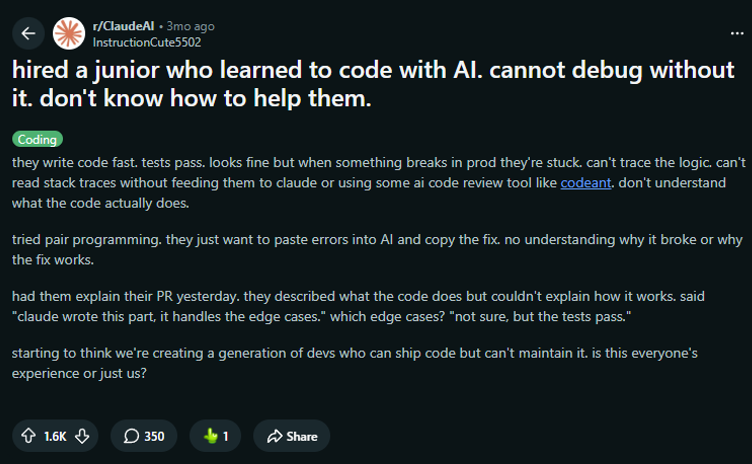
(图:编程智能体悖论)
研究这种现象需要时间,因此收集轶事证据(anecdotal evidence)以获得对现状的实时视角非常重要。但这确实已经被研究过了,并且有众多的报告在强化这一观点:这是一个真实存在的现象。
这次真的不一样了。
当一个 C++ 开发者转向 Java 或 Python 时,他们不会抱怨脑雾(brain fog)。当一个系统管理员转向 AWS 时,他们不会觉得自己在丧失理解网络底层原理的能力。
随着高级工程师晋升到管理岗位,写代码的时间变少,他们逐渐失去写代码的敏锐度并变得“生疏”,这并不是什么新现象。这是专业技能的自然发展过程:一个积累了几十年编码经验、经历了无数摩擦的工程师,已经有了足够的时间和经验来巩固这些技能与智慧。当他们的工作重点不再是语法,而是更高层次的架构决策时,他们可以运用这种智慧。这样的人不仅极其稀有,而且如果我们所有人都放弃了编写、解决问题和调试代码所带来的摩擦,那么下一波高级工程师将后继无人。
现在正在发生的一种趋势是:那些从未经历过漫长岁月、没有经历过带来深刻理解的 30 多年代码摩擦的开发者,正被推向更高层次的工作流中。而要管理这些 AI 智能体,他们所需要的技能,正是高级工程师花了数十年才掌握的。
然而,高级工程师也无法免疫。拥有近 30 年开发经验的 Simon Willison 曾报告说,他发现自己不再拥有*“对应用程序能做什么以及它们如何运作的坚实心智模型,这意味着每一个新增的功能都变得更加难以推理。”*
“熟练”编排者的问题
在 Anthropic 最近的一项研究中,隐藏着一个极其坦诚的时刻。在谈到频繁使用编程智能体的风险时,报告指出:
编码技能退化之所以令人担忧,原因之一在于“监督悖论(paradox of supervision)”……有效地使用 Claude 需要监督,而监督 Claude 恰恰需要那些可能因过度依赖 AI 而退化的编码技能。
监督 50 名工程师的领英软件工程总监 Sandor Nyako 注意到,这种现象正在整个组织内蔓延,他要求他的团队不要将 AI 用于*“需要批判性思维或解决问题的任务。”*
他说:“为了提升技能,人们必须经历磨难。他们需要培养思考问题的肌肉。如果某人没有批判性思维,他们又怎么会去质疑 AI 是否准确呢?”
这里还存在一个什么构成“过度使用”的问题。我们已经有证据,无论是数据驱动的还是传闻的证据都表明,这些技能可能会相当迅速地退化和消散(在某些情况下只需几个月)。
这是一个让许多 AI 吹捧者自相矛盾的点:使用编程智能体,正积极地削弱了有效管理编程智能体所必需的技能。
大语言模型加速了错误的部分。
与目前被大肆宣扬的叙事相反,我们并不一定需要以更快的速度写代码。尤其是那些我们没有完全理解的代码,特别是在合理的时间范围内我们根本无法审查的海量代码。
在 AI 之前,一个(优秀的)开发者的优先级列表可能是这样的:
- 理解代码及其与整个代码库的关系
- 代码是否符合已记录的且高效的标准
- 用尽可能少的代码行数实现目标(同时保持可读性)
- 交付周转时间
而由智能体主导的编程,或者说普遍的 LLM,完全颠覆了这个列表。
它们的能力和使用场景倾向于专注于速度,即在特定时间范围内增加可生成的代码量。速度应该是高能力的自然副产品。当速度是被强行催生出来时,它总是会导致准确率的下降。这些工具的整合通常并不怎么关注更深层的理解或代码的简洁性。
它们能被用作辅助理解和精简代码吗?是的,只要下定决心,它们当然可以。
但人们真的在这么用吗?不,并没有;跨组织的强制命令和对 Token 使用量的炒作已经证明了这一点。
写代码 === 做计划
在开发者之间存在一种很少被强调的分歧:我们中的一些人,通过写代码能更好地做计划和思考。在代码中思考和工作不仅仅是无意义的苦差事;它迫使你在技术层面思考问题,这涉及从安全性、性能、用户体验到可维护性的方方面面。
在最近一次讨论“规范驱动开发(SDD)”的采访中,OpenCode*(没错,就是那个开源编程智能体)*的创造者 Dax 被引述说道:
“当我在做一个新东西或有挑战性的东西时,我敲代码的过程,其实就是我弄清楚我们到底应该做什么的过程。
让我干坐在那里,写一份庞大的、关于这个功能到底该如何运作的详尽规范,对我来说真的非常困难。
我喜欢写下类型定义。我喜欢写下几个函数可能会如何交互。我喜欢摆弄文件夹结构,看看不同的概念应该怎么归类。我认为大多数人——大多数程序员——一直以来都是这么做的。我个人真的看不出有什么好理由让我停止这样做,因为这就是我弄清楚该怎么做的方式。”
你说的往往不是你真正想表达的意思,而 LLM 会用假设(或幻觉)来填补这些模糊地带,这将导致:更多的审查,更多的智能体修改,更多被烧掉的 Token,以及与正在创造的东西产生更多的脱节。反之,你也可以为你写出的有史以来最优美、最明确、结构最完美的提示词(prompt)惊叹不已,但 LLM 依然可能会输出一个产生幻觉的方法,因为它本质上是一个“下一个 Token 预测(next-token-prediction)”引擎,而不是一个编译器。你不可能用一个概率性系统取代一个确定性系统,还能期望得到零模糊性。
就连对 AI 最狂热的资深开发者们也开始意识到,这种“脱节”正成为一个迫在眉睫且不断扩大的问题。
供应商锁定(Vendor Lock-In)
前阵子 Claude 发生宕机时,我在浏览领英,注意到许多帖子指出,某些开发者和工程团队陷入了停滞。他们的工作流、他们自己的编码能力,已经到了严重依赖这些供应商的地步。一项过去只需要键盘和文本编辑器就能执行的技能,突然之间变成需要订阅一家 AI 模型提供商才能完成了。
你无法预测你的 Token 成本。
模型提供商目前享有巨额补贴,而模型本身则是建立在流沙之上的。每一个新模型的发布都遵循着同样的模式:超高的基准测试跑分,紧接着是铺天盖地的炒作,然后是实际使用的现实——每个人都在抱怨它们被“削弱(nerfed)”了,需要烧掉 2 到 3 倍的 Token 才能完成同样的工作。
你知道你员工的成本是多少;但你根本不知道你每天、每月、每年的 Token 成本会是多少。如果你的整个团队都把智能体编程作为默认方式,你的开支账户将需要保持极高的灵活性。正如 Primeagen 最近所说:“当你使用这些全自动的智能体工作流时,模型提供商基本上就拥有了你。”
顺着这个模式往下推演并不离谱:我们正在创造这样一个行业环境,你必须为 Token 的消耗付费,才能完成那些过去依靠你自身的批判性思维和解决问题能力就能做到的事情。这就像是一种“供应商锁定”,但这针对的是整个行业的技能组合(我确信模型提供商们正满怀期待地搓着双手)。财务和智力上的“抽地毯(rug-pull)”随时可能发生,而本地 LLM 远远没有准备好去扩展并吸收那样级别的用量。
这不是理论上的猜想;它现在正被报道。甚至模型提供商自己也在将其公之于众。Anthropic 的另一项研究显示,开发者的调试技能出现了 47% 的急剧下降:
“将 AI 激进地引入工作场所——尤其是在软件工程领域——不可避免地伴随着权衡与妥协……开发者可能会依赖 AI 来提供快速的结果,而代价是牺牲构建关键技能的机会——最显著的,就是当事情出错时进行调试的能力。”
当然,我们有办法避免这一切。LLM 是一项强大的技术进步,如果负责任地使用,它们可以成为极佳的学习和提升技能的工具。它们使我能够更深更广地探究概念和技术,扩展理解能力,并探索那些过去实验起来既费时又费力的新想法。我认为,这才是它们能为行业提供最长期价值的地方。
我的方法:降低 AI 的角色比重
我绝对不是在提倡要一行行地手动敲代码。程序员一直在寻找创造代码而无需手动编写代码的方法。这正是我们当初发明 Emmet、自动补全和代码片段(snippets)的原因。甚至 COBOL 的设计初衷,就是通过使用类似于英语的词汇(如 MOVE 和 WRITE),以更少的书写来封装更多的指令。jQuery 的口号就是“写得更少,做得更多(write less, do more)”。LLM 只是这种代码生成工具阵列中的新成员。
但我所提倡的是,将 LLM 和编程智能体作为**辅助流程(secondary processes)**来利用。以一种不把个人技能当作提升生产力祭品的方式来使用。你可以反转脚本,在规划阶段依靠它们进行头脑风暴,但在整个实现过程中保持积极参与,仅在必要时才将任务委托给它们。这样,你既能利用它带来的生产力提升,又能减轻理解债务。
我的日常工作流:
- 我使用 LLM 来帮助生成规范和计划,同时由我主导实现。这是对“编排(orchestration)”工作流的逆转;根据任务的不同,我仍然会手动编写 20% 到 100% 不等的代码。
- 当我与模型互动时,我经常会写伪代码,以此拉近需求与生成代码之间的距离。
- 我将模型作为委托工具,用于生成临时代码和交互式文档,也作为研究工具,这样我可以不断提问、迭代、重构,并对我的实现方法获得清晰的认知。
- 我生成的代码量,绝不超过我坐下来一次能审查完的量。如果代码太多无法审查,我就会放慢速度,把任务拆分,在需要的地方手动重构,以确保对最终结果有全面的理解。
- 我绝不会要求 LLM 或智能体去实现一些我以前从未做过或我自己无法独立完成的东西,除非纯粹是为了教育或教程目的(并且通常事后会被丢弃)。
如果非要给这个列表写个 TL;DR(太长不看版),那就是:把它们当成星际迷航里的“舰载计算机”来用,而不是当成“Data”少校来用。
(星际迷航粉丝应该懂这个梗)
我没有变快,但我做出了更高质量的工作。
这些模型带来的生产力提升是真实的,频繁且切实地参与工作所带来的摩擦与理解也是真实的。
尽管过去有无数次试图在不理解编码的情况下实现“编码民主化”的失败尝试,但我们面临的现实依然是:如果不去实践代码,你无法真正理解它。而且情况已经很明显了,如果你不坚持去敲打、去编写代码,你会失去那种理解力,而这反过来会让你从一开始就变成一个能力低下的“编排者”,使得 AI 编程的现阶段成为一段怪异且徒增压力的插曲。
也许我是杞人忧天,但历史是有教训的。
不过,这一切感觉似曾相识,就像是我们正在自己身上进行的另一场大型实验。在引入社交媒体时,我们也经历过一段类似的时期,当时我们并不了解它的长期影响,而现在我们正面临着大规模的注意力缺失(以及许多其他问题)。
这一次,我们下的赌注风险大得多。
“现在全力押注 AI 智能体的人,正在为自己的被淘汰打包票。如果你把所有的思考都外包给计算机,你就会停止技能提升、停止学习、停止变得更能胜任工作。”
– Jeremy Howard,fast.ai 创始人