智能体运行框架的演进
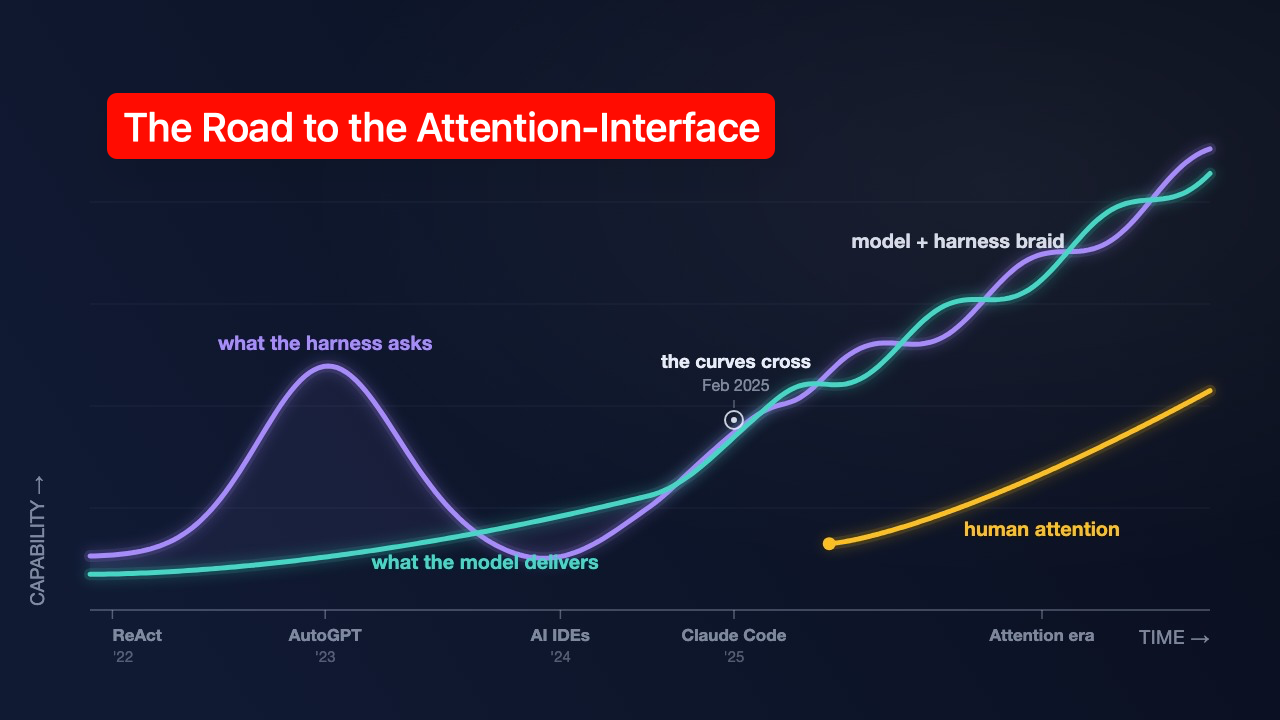
图中文字译注:横轴为时间,纵轴为能力;紫色曲线表示运行框架对模型的要求,青色曲线表示模型实际能做到的事,黄色曲线表示人类注意力。图中标出ReAct(2022年)、AutoGPT(2023年)、AI IDE(2024年)、Claude Code(2025年)和注意力时代;两条曲线于2025年2月相交,随后模型与运行框架交织。
2025年圣诞节前后,AI工程师注意到智能体发生了变化。它们开始管用了!确切原因很难说清。也许我们终于有了假期的空闲时间,可以用最新的模型试试最新的智能体。也许模型跨过了某个能力门槛。也许模型周围的封装层已经成熟。
我在本文要论证的是,原因在于后两者的汇合。模型和运行框架(harness)一起进步,两条进步曲线随后在恰当的时刻相交。这种动态也有助于解释接下来会发生什么:模型不断把运行框架吸收到自己的权重中,工程师不断删去已经被吸收的部分,剩下的将是服务于人类注意力的运行框架,而非服务于模型的运行框架。
Transformer的发明者之一Lukasz Kaiser在6月的《Unsupervised Learning》节目中说:
“去年冬天、去年圣诞节发生的变化——有点难说清。我的意思是,运行框架变了,后训练也发生了一点变化,然后新的预训练模型又来了……但感觉那是一次大跃进,要说清究竟是什么带来了它,并不容易。”
“发生了什么?” 的答案并不只在模型权重中。答案在围绕这些权重成长起来的系统中。
答案在智能体运行框架中。
回想2022年11月,当时ChatGPT是最先进的AI工具。它拥有的能力只有预测下一个词元(next-token prediction),以及一些来自人类反馈的强化学习(Reinforcement Learning from Human Feedback,RLHF),让它表现得像一个乐于助人的助手。没有工具,没有搜索,也没有推理。
最初的ChatGPT被限制在训练数据和你发给它的提示词里。不多,也不少。它就是一个缸中之脑。
智能体运行框架让大语言模型(LLM)能够摆脱这种限制,与真实的数字信息空间交互。
运行框架究竟是什么
智能体运行框架是模型权重之外,让智能体能够运转的一切。 它包括围绕模型的环境、工具、上下文和护栏(guardrails)。没有运行框架,模型就是缸中之脑。它可以采取认知层面的行动,但需要运行框架在真实的数字空间中落实这个决定。
运行框架就像给模型的心智装上了一个身体。 有了运行框架,模型就能感知(上下文)、行动(工具)、持久保存信息(记忆和上下文压缩〔compaction〕),以及执行自身的边界约束(权限和护栏)。
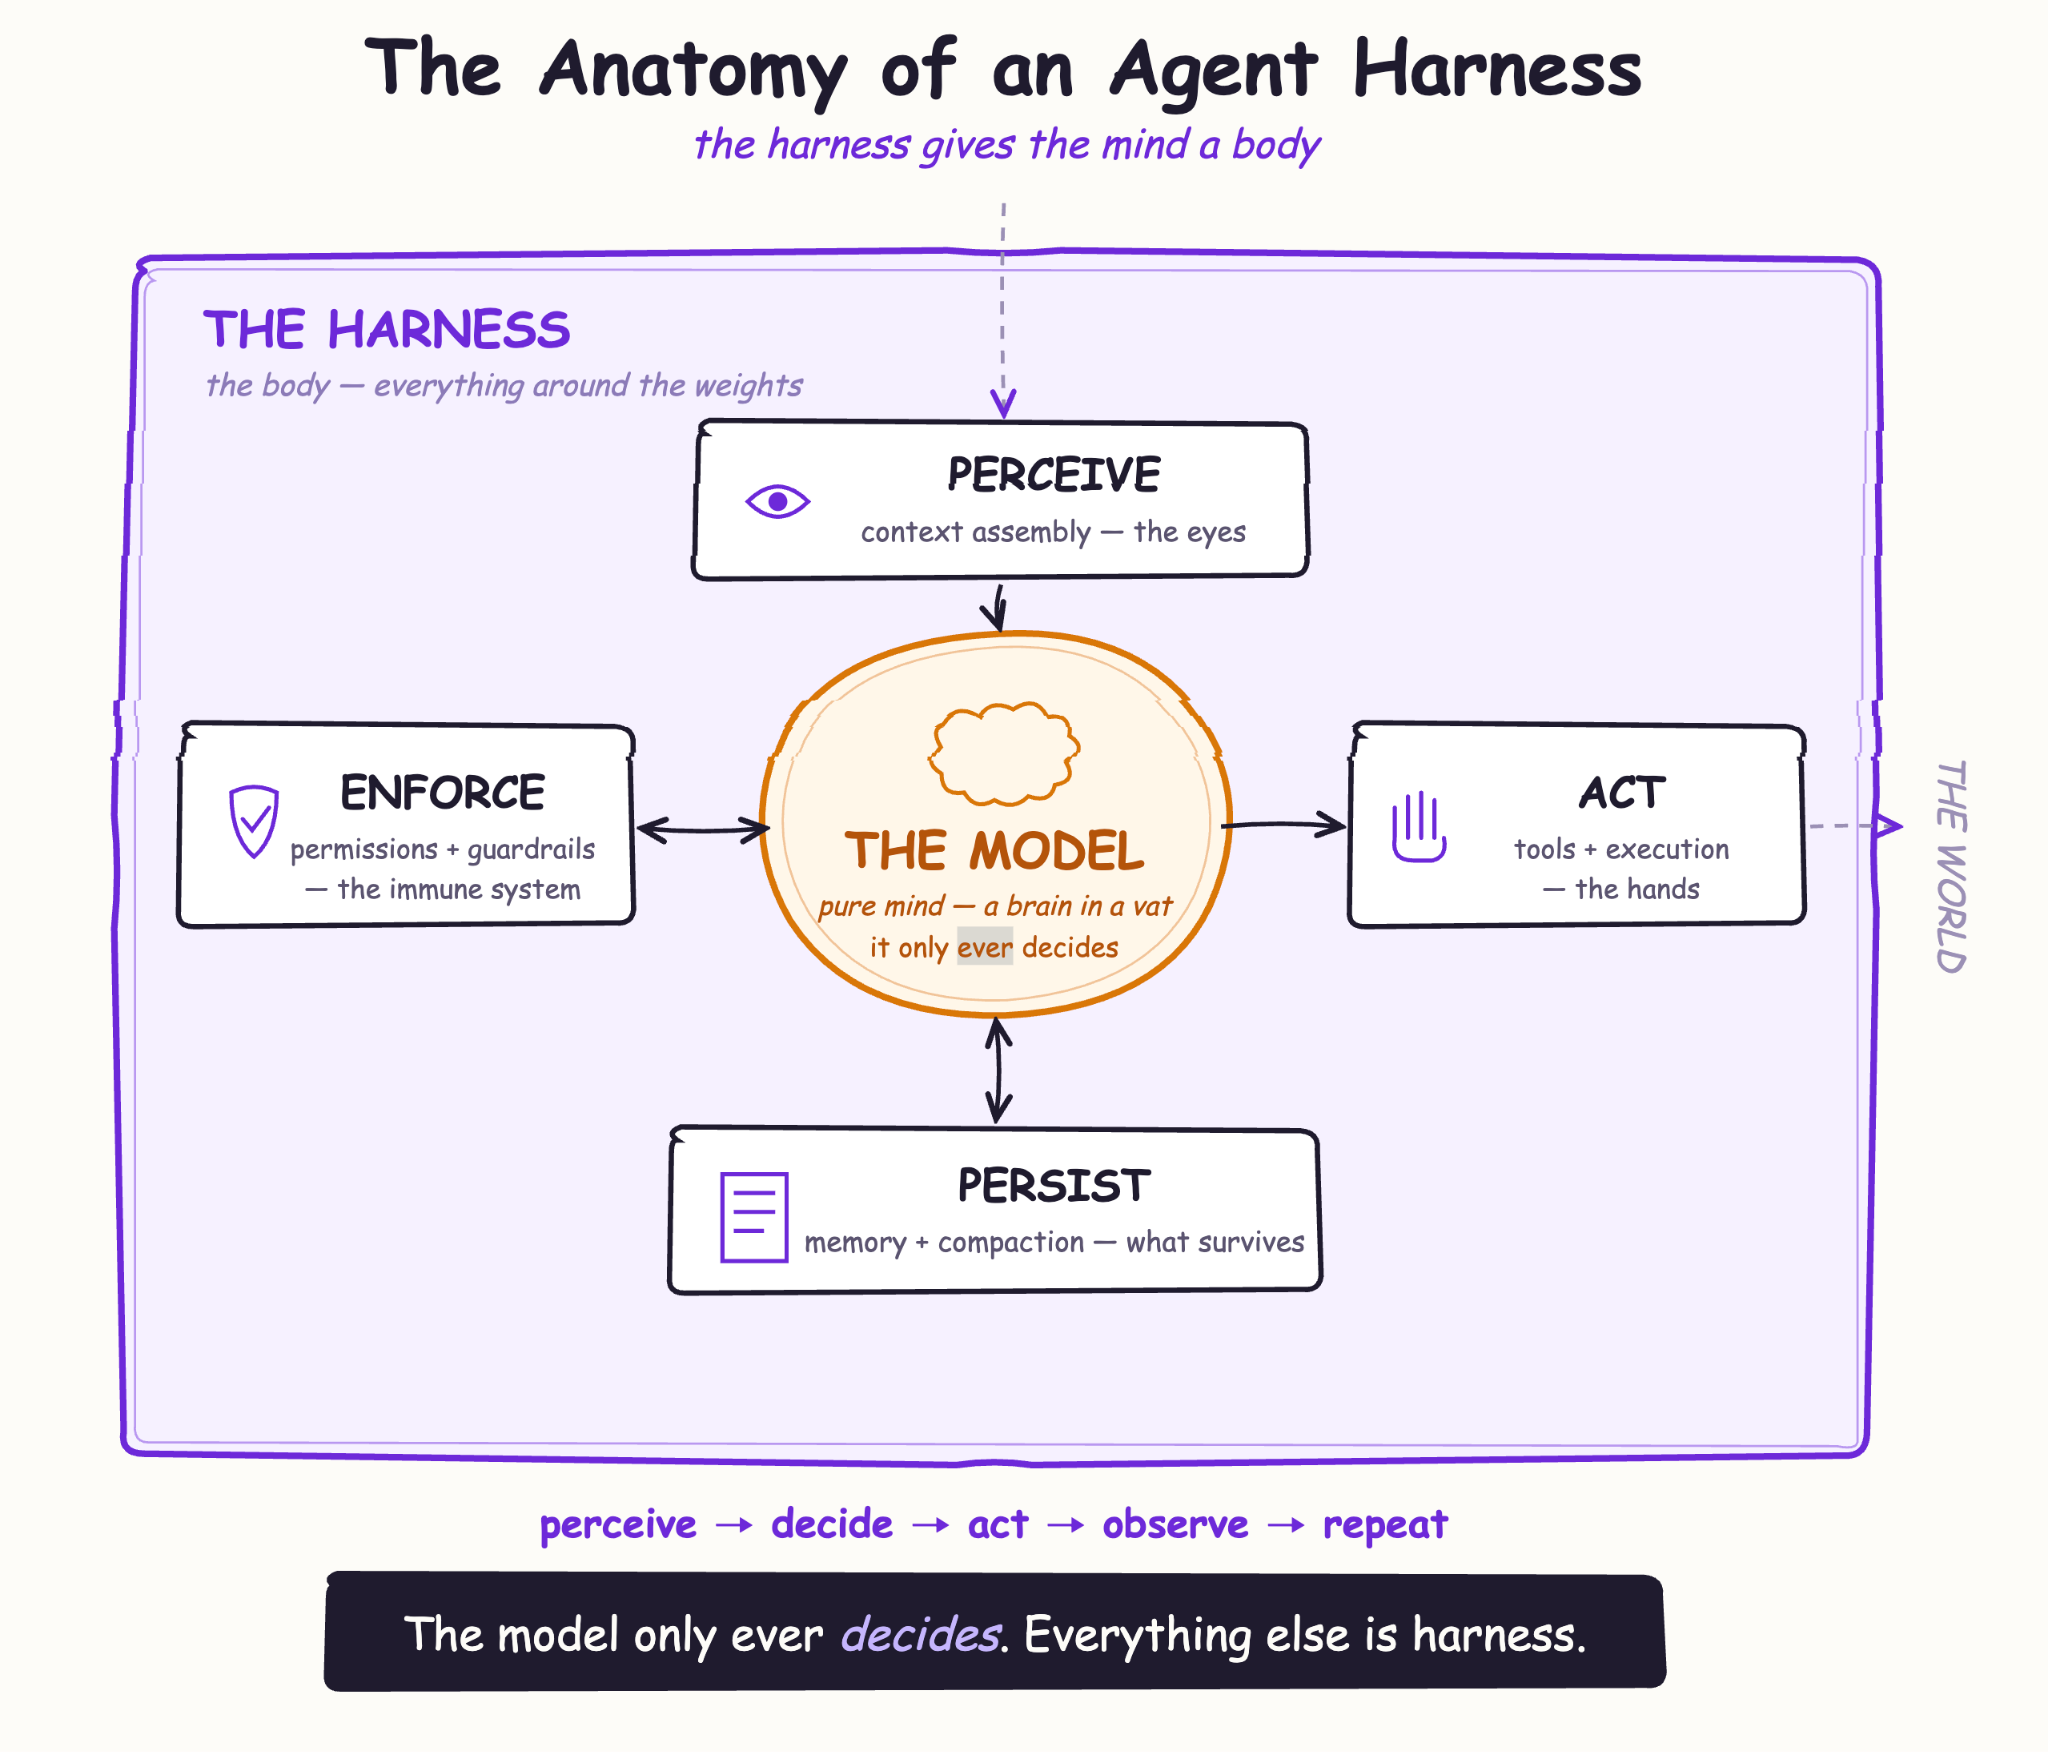
图中文字译注:运行框架是身体,即权重周围的一切;模型是纯粹的心智,是只负责作出决定的缸中之脑。感知:组装上下文,相当于眼睛;行动:工具与执行,相当于双手;持久保存:记忆与压缩,即能够保留下来的信息;执行约束:权限与护栏,相当于免疫系统。循环为“感知→决定→行动→观察→重复”。图末文字:“模型始终只负责作出决定。其余一切都是运行框架。”
运行框架1.0:过去的“外挂时代”
模型与运行框架的演进历程中,始终贯穿着两条曲线。一条是运行框架对模型的要求,另一条是模型在实践中能做到的事。
这两条曲线之间的差距就等于智能体的有效程度;我要论证的是,正是差距的缩小,带来了Lukasz Kaiser提到的智能体的切实进步。
这个差距是这样分阶段缩小的:
-
ReAct:“纸面上的运行框架”(2022年10月):ReAct是一种通过提示词让模型推理的提示技术。它是纸面上的智能体循环,位于模型权重之外。它定义了“智能体循环”的概念:模型推理→行动→观察→重复。再强调一次,ReAct循环只是一种提示方法。 当时,提示词是唯一存在的推理方法,还没有人把它叫作“运行框架”。同一个冬天发布的Toolformer(Meta,2023年2月)暗示,工具使用能力可以通过训练获得,而不必依赖提示词。这有点像Alan Turing关于计算机的构想,在它被落实到物理载体之前就已经存在。一个强大的想法,直到后来才成为现实。(ReAct比ChatGPT早一个月:2022年10月对2022年11月。)此时两条曲线都接近零。差距很小,因为我们才刚刚开始。
-
AutoGPT/BabyAGI:“过早的自主性”(2023年春):有了AutoGPT/BabyAGI,运行框架曲线飞快地跑到了模型能力曲线前面。两者都把完全自主权交给模型,要求模型充当“自主员工”,但当时的模型仍然只是脆弱的下一个词元预测器,谈不上强多少。循环不会给模型增加能力。 循环会放大模型已有的能力,而在某个门槛以下,它放大的会是错误,而非可靠性。想想复合效应往坏方向发展时的威力:每一步都有95%的可靠性,执行一个20步的任务,平均成功率就只有约36%。运行框架给模型派了一项任务,而模型在现实中没有机会完成它。此时差距达到最大,接下来的18个月都是对此的回应,以及缩小差距的尝试。
-
Cursor/Copilot:“退回到人类参与循环”(2023—2024年):最早一批AI驱动的集成开发环境(IDE)认识到了给模型太多自主权的失效模式。它们把运行框架曲线拉到模型曲线之下,以此缩小差距。不要直接把循环交给模型;把循环交给人类,让人类能够编排循环,同时让模型加快人类的工作。第一版Devin试图把自主权重新交给模型。Answer.AI团队的一次测试表明,这仍然为时过早,成功率约为15%。这证明,IDE选择从完全自主退回来并非怯懦,而是正确的做法。不过,当主流策略是把运行框架拉到模型之下时,模型仍在持续进步。到了2024年末,随着第一个推理模型o1推出,差距首次出现了反转,我们开始看到模型能力富余的最初迹象。
-
Claude Code:“曲线相交”(2025年2月):2024年末的反转创造了一个必须有人去抓住的机会:如果模型如今已经领先于运行框架,那么一个刻意踩着模型刹车的运行框架,就是把能力白白搁置了。Claude Code是第一个为抓住这个机会而构建的编程智能体。 它放弃IDE,转向终端,给模型bash和文件读写权限,并用权限规则取代每次变更都需要人类批准的要求。循环再次交到模型手里,这次它明白了任务。Boris Cherny及其团队构建Claude Code时,着眼于下一代模型的能力,而非当前模型的能力。 它如此成功,不是因为它是第一个给模型自主权的产品,而是因为它是第一个在正确的时机这样做的产品。这个时机就是模型已经可靠到足以凭自主性完成任务的交叉点。Claude Code在六个月内达到了约10亿美元的年度经常性收入(ARR),全因Anthropic抓住了两条曲线开始相遇时出现的机会。
接下来,两条曲线不再只是相遇,而开始交织在一起。
运行框架2.0:当下的“共同训练时代”
如今,运行框架很重要,而且这种重要性可以衡量。Harness-Bench让同一个模型在不同运行框架中执行同样的106项任务,得分从52.4到76.2不等:模型完全没有变化,分数却相差23.8个百分点。智能体的一半是运行框架。
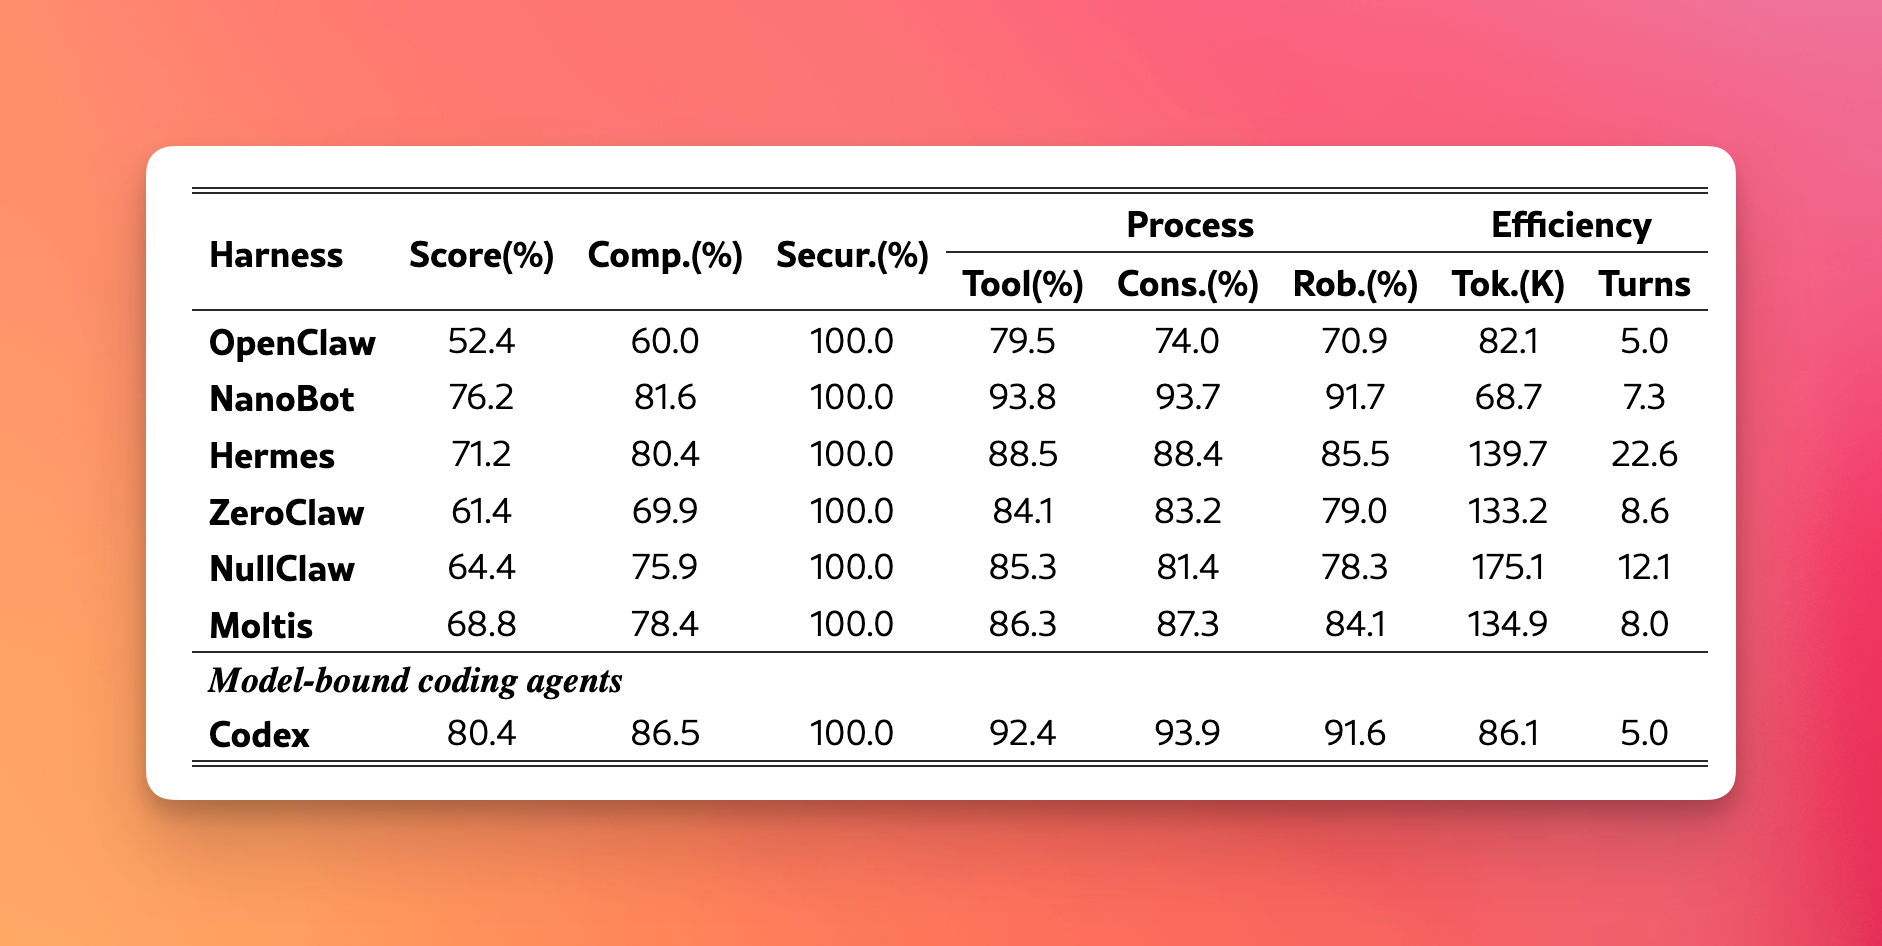
图中文字译注:表头为运行框架、得分、Comp.、Secur.,过程指标Tool、Cons.、Rob.,以及效率指标词元数(千)和轮数;除最后两列外,单位均为百分比。下方另列“与模型绑定的编程智能体”Codex,其得分为80.4。缩写按原图保留。
通过调整运行框架,OpenAI在ARC-AGI-3上获得了类似结果。仅仅加入保留推理和上下文压缩,GPT-5.6 Sol的ARC-AGI-3得分就从13.3%提升到了38.3%,约为原来的三倍。
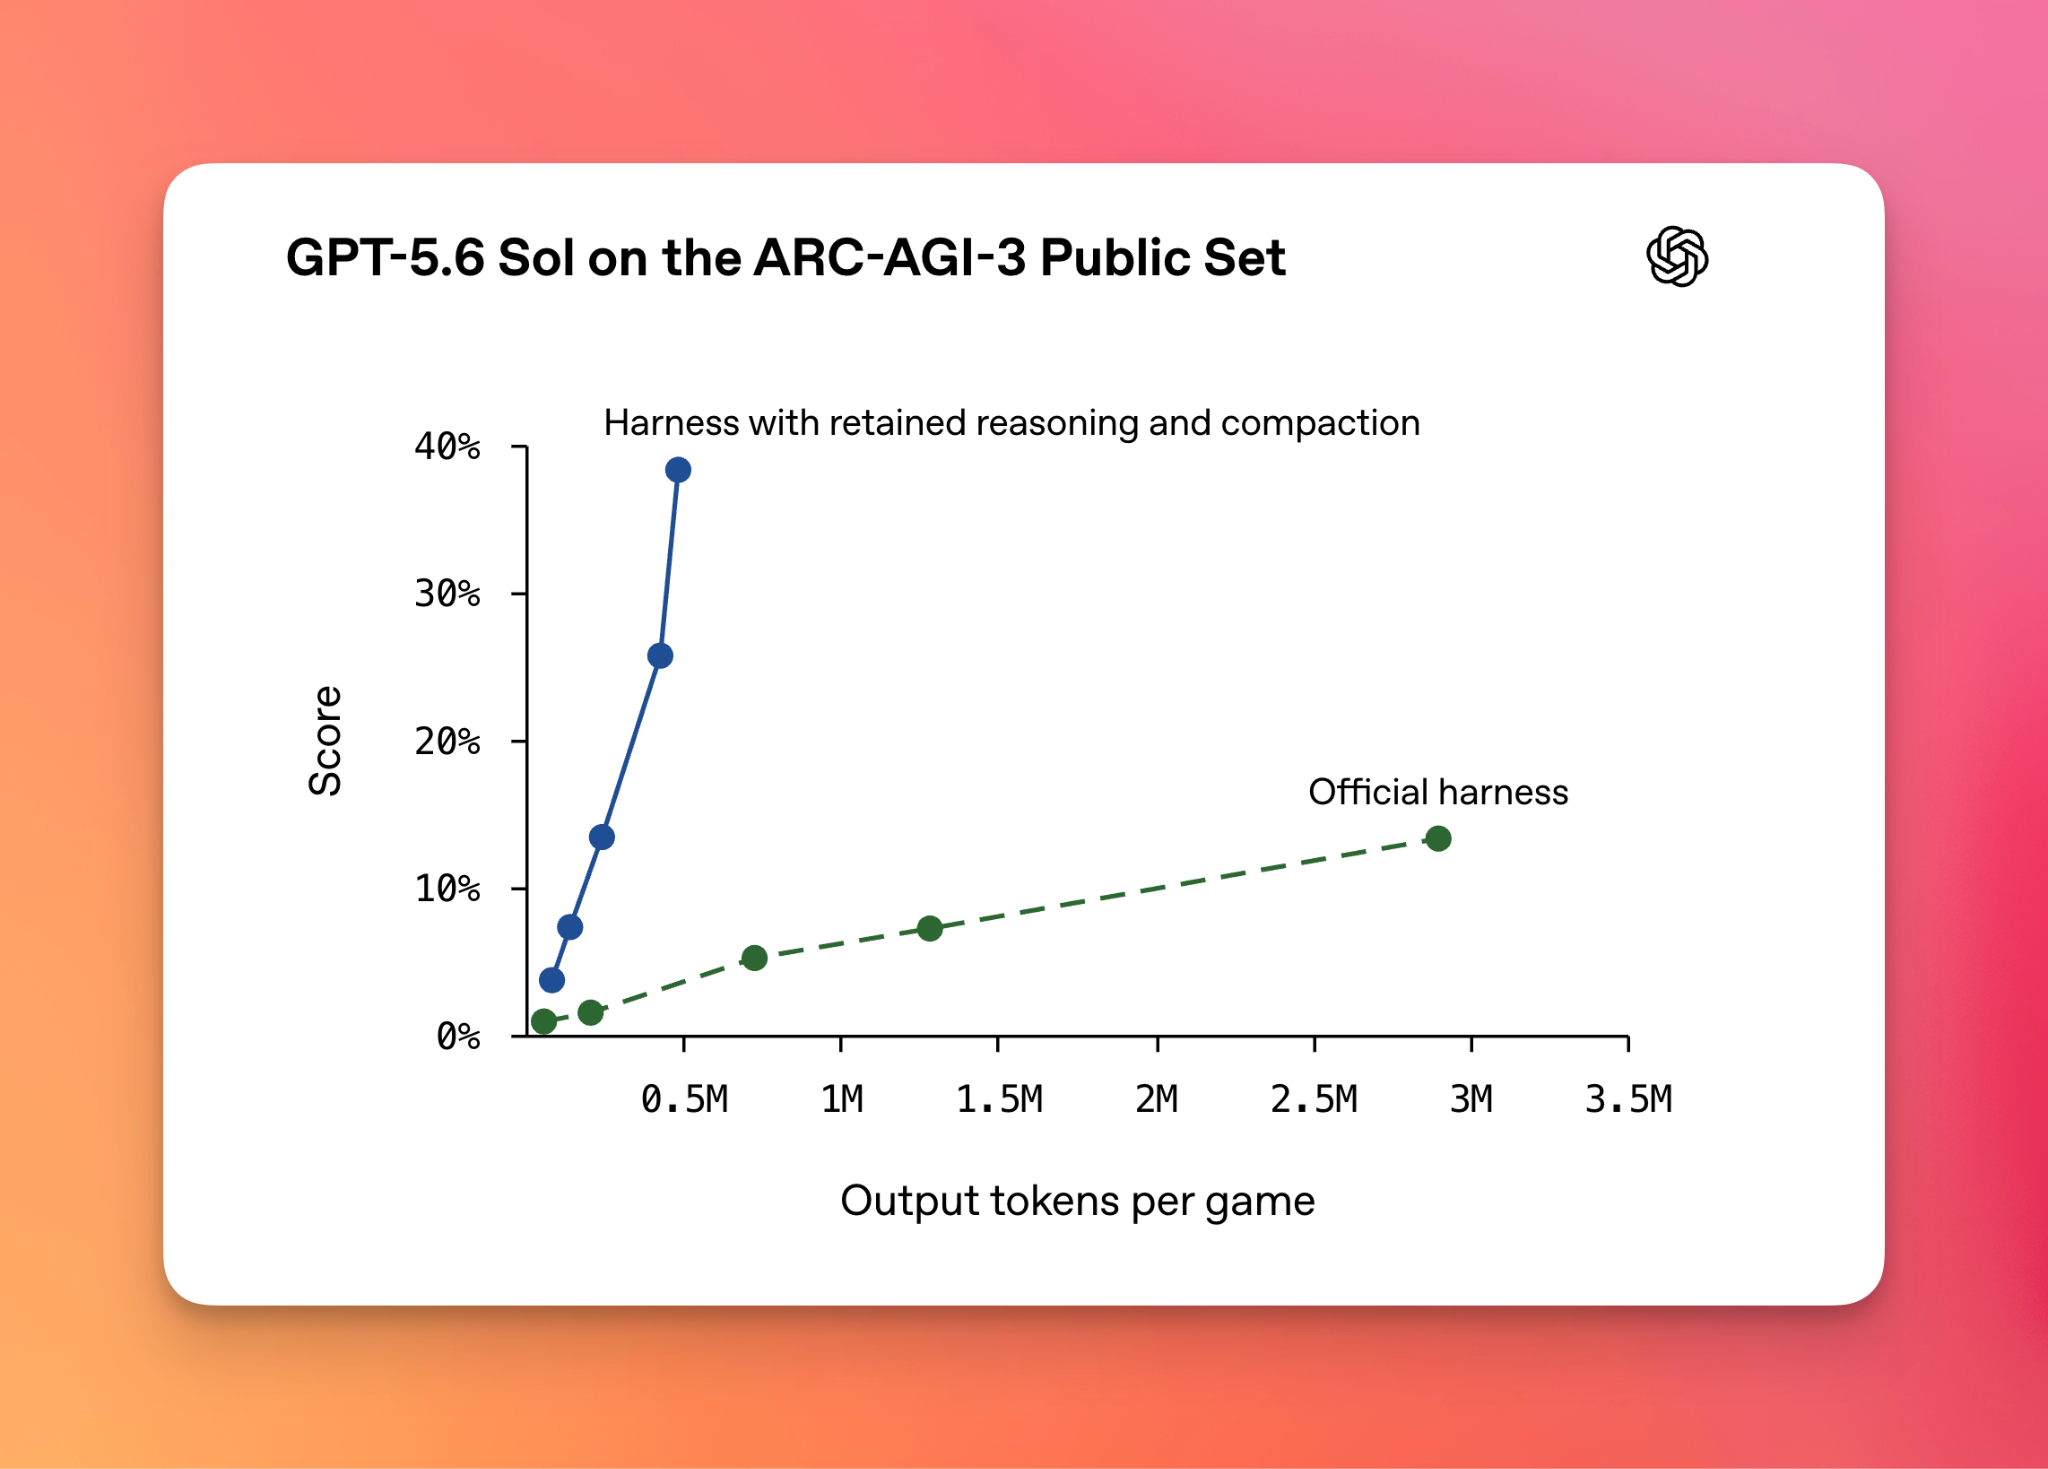
图中文字译注:纵轴为得分,横轴为每局游戏输出的词元数,M表示百万;蓝线表示加入保留推理和上下文压缩的运行框架,绿线表示官方运行框架。
底层发生的变化是,强化学习(Reinforcement Learning,RL)已经移到了运行框架内部。OpenAI在2025年5月的codex-1发布公告中写道:“codex-1在多种环境中,利用真实世界的编程任务进行强化学习训练。”
两条曲线汇合,开始交织成一个统一的系统。
这是Toolformer的梦想在现实中显现。工具不再只靠外部提示词驱动;如今,工具调用是在模型的环境内部训练出来的。
接着,随着模型在运行框架的环境中训练,它们开始把运行框架的能力吸收到模型权重里。例如,模型会根据对自身上下文窗口的了解,学会自动压缩上下文。
GPT-5.1-Codex-Max发布时这样介绍:
“第一个经过原生训练,能够通过压缩在多个上下文窗口之间工作的模型。”
一旦模型吸收了运行框架的能力,运行框架就可以卸下脚手架。 通过删减来实现生产。Anthropic的Thariq Shihipar说,团队最近删去了80%的Claude Code系统提示词。
衡量智能体运行框架演进速度的指标是:在保持同等能力水平的同时,你能删掉多少运行框架。作为AI工程师,我们需要朝着这个未来构建系统。
这就是模型与运行框架的演进循环:训练→吸收→卸下→重复。模型会向上攀登,去迎接下一件它还做不到的事。
Kaiser指出的那次跃进很难说清,因为它不是一个离散事件。预训练的跃进容易察觉,因为你可以在模型卡中清楚描述它。模型与运行框架共同演进的跃进就没那么明显,因为演进过程没有文档记录。这就是去年冬天那次跃进的答案:它发生在模型与运行框架协作的间隙中。
我们需要问:如果运行框架的每一种能力最终都会被模型吸收,那还会给我们留下什么?
运行框架3.0:未来的“注意力时代”
继续删掉模型能够吸收的一切。想象这个过程结束时,你的智能体会是什么样子。当你删掉一切之后,手里还剩什么?
模型权重接下来会吸收什么?多智能体编排、工具选择、记忆……这些只是其中几种可能性。研究人员正在构建能够自我改进的运行框架,它们自身也可以用类似于模型的方式训练。
这种删减与吸收过程结束后,留下的是以人类为中心的智能体能力。例如权限、身份、信任和可理解性(legibility)。把权限吸收到自身之中的模型,等于消解了权限。吸收不会终结运行框架。吸收会颠倒运行框架的方向。
运行框架成为智能体与操作它的人类之间的接口。
运行框架诞生时,是人类与模型之间的接口。我们从聊天框走到IDE,再走到终端。如果模型吸收了面向计算机的能力,下一阶段的演进就会提高一个抽象层级。运行框架会成为模型与我们人类注意力之间的接口。
它会成为注意力接口(attention-interface)。
Ryan Lopopolo在Latent Space的《Extreme Harness Engineering for Token Billionaires》一期节目中说:
“唯一在根本上稀缺的东西,就是我的团队在同一时刻投入的人类注意力。”
词元已经变得充裕而可靠,但我们的瓶颈仍是稀缺的人类注意力。
我们已经看到了这种变化的火花,例如Anthropic为长时间运行的智能体设置的进度文件,以及智能体批准队列。
模型吸收运行框架时,模型曲线和运行框架曲线之间的差距不会消失。它会跨越人类的边界,形成新的一对曲线和新的差距。新的差距,在于智能体向人类提出的要求,与人类能够给出的回应之间。
注意力接口
我预测,在一年之内,每一家构建智能体AI的公司都会推出人类注意力策略的配置界面,就像每家智能体AI公司都推出了AGENTS.md一样。
AGENTS.md告诉智能体如何与你的代码库协作。注意力接口将告诉智能体如何与你协作。 它将规定:什么时候允许打断你,什么时候应该继续工作,哪些决定它可以独立作出,哪些决定需要你的批准。而且,和智能体系统中的其他一切一样,它将成为系统中一个可学习的组成部分,可以随着数据增多而学习。 每一次纠正都会成为有用的数据。
模型最初是一个缸中之脑。运行框架给这个大脑装上了身体,随后身体开始融入大脑。留给我们去构建的,是未来任何模型都不会吸收的东西。通向那种唯一真正稀缺的资源的接口:人类注意力。
此文章由AI翻译。