预训练的进步主要来自数据
把六年的预训练进步拆分为数据改进与模型改进
过去几年里,我们看到AI快速进步1。其中有多少来自数据,又有多少来自模型改进?这个问题的答案,对前沿实验室的经济账和未来进步的速度都有重大影响。
我们在相对较小的规模上研究这个问题,具体考察2019至2025年的预训练(pretraining)。这几年中,每年都有新的开放模型配方(model recipe)发表,将当年公开已知的算法调整汇集起来,例如架构、优化器、初始化、学习率调度、超参数等方面的改进。每年也都有新的公开数据语料库(data corpus),来自更广泛的抓取以及新的整理、提取和过滤技术。
我们将这些代表不同年份的模型配方与数据语料库组合起来,在不同的训练计算规模下训练模型,最高达到1e19次浮点运算(FLOPs)2。
显然,既然我们改变了模型训练所用的数据集,就不能用它们在某个固定数据集上的交叉熵损失(cross-entropy loss)来比较这些不同的模型。因此,我们转而用OLMES评测衡量模型的最终能力(end capabilities)。这项评测汇总了10个不同、相对简单的基准测试,主要是选择题问答。遗憾的是,评估最终能力而非预训练损失,会给结果增加一些噪声,下面的图中就能看到。不过,我们尝试运行多个随机种子,以获得更清楚的界限。
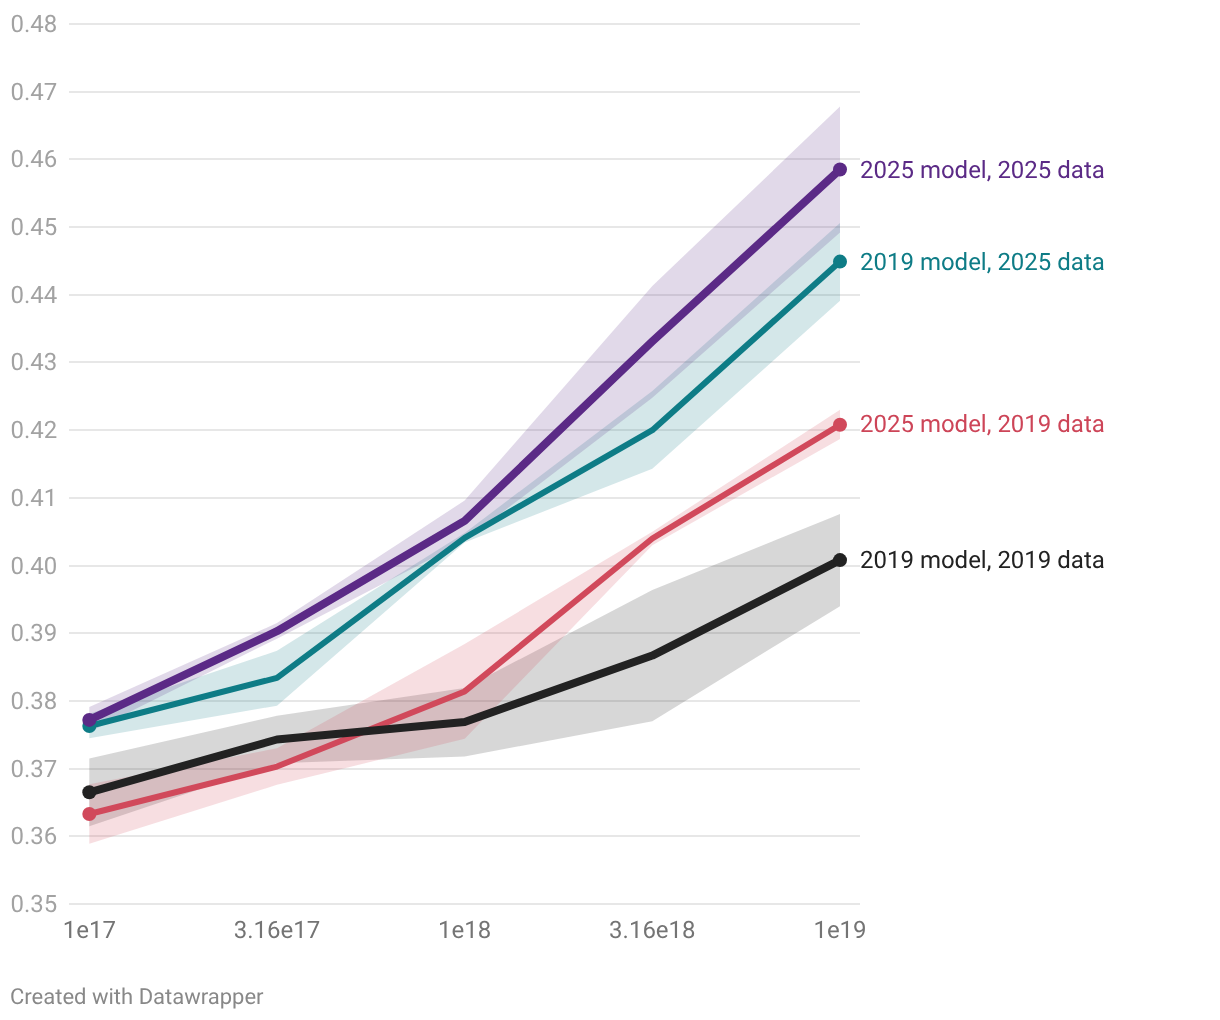
我们发现,在1e19 FLOPs的计算预算下,2019至2025年间,数据改进带来的计算效率提升是模型改进的3.24倍:数据带来12.0倍提升,模型带来3.7倍提升3。
计算倍数(compute multipliers)
OLMES得分随训练计算量的变化。
图表来源:Han & Patel。
图中文字译文:四条曲线分别对应2025年模型+2025年数据、2019年模型+2025年数据、2025年模型+2019年数据、2019年模型+2019年数据。
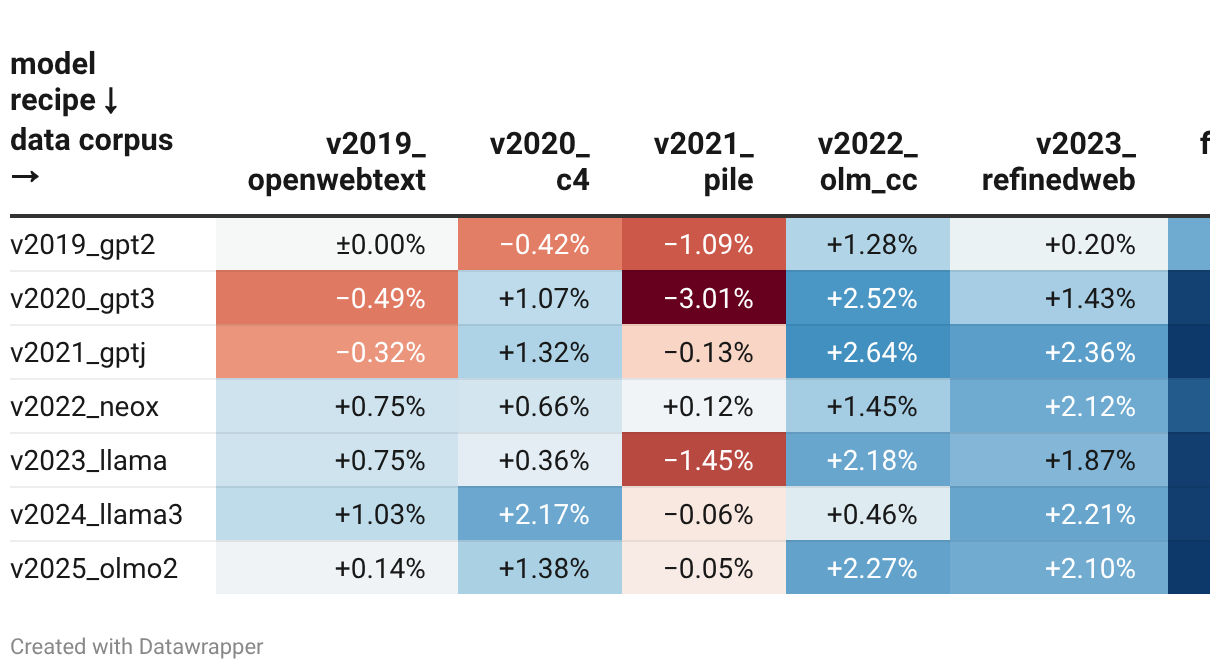
下面的网格展示了,在3.16e18 FLOPs下,相对于2019年数据+架构的基线,我们训练的模型在所测试的最终能力上提高了多少4。
使用Datawrapper制作
图表来源:Han & Patel。
| 模型配方↓/数据语料库→ | 2019 OpenWebText | 2020 C4 | 2021 The Pile | 2022 OLM CC | 2023 RefinedWeb | 2024 FineWeb Edu | 2025 Ultra FineWeb |
|---|---|---|---|---|---|---|---|
| 2019 GPT-2 | +0.00% | -0.42% | -1.09% | +1.28% | +0.20% | +2.12% | +3.57% |
| 2020 GPT-3 | -0.49% | +1.07% | -3.01% | +2.52% | +1.43% | +4.02% | +2.25% |
| 2021 GPT-J | -0.32% | +1.32% | -0.13% | +2.64% | +2.36% | +4.17% | +4.14% |
| 2022 GPT NeoX | +0.75% | +0.66% | +0.12% | +1.45% | +2.12% | +3.53% | +4.23% |
| 2023 LLaMA | +0.75% | +0.36% | -1.45% | +2.18% | +1.87% | +4.08% | +3.56% |
| 2024 LLaMA 3 | +1.03% | +2.17% | -0.06% | +0.46% | +2.21% | +4.08% | +4.34% |
| 2025 OLMo-2 | +0.14% | +1.38% | -0.05% | +2.27% | +2.10% | +4.17% | +4.01% |
我们发现,数据改进与模型改进带来的收益大体独立,彼此没有交互作用。也就是说,要获得某项模型改进的收益,并不需要特定的训练数据堆,反过来也一样。通过线性模型,OLMES得分方差的88%可由模型改进和数据改进的加法效应解释。
讨论
先简要回顾一下,2019至2025年间,数据和模型分别发生了哪些变化。
模型从GPT-2发展到OLMo-2,其间出现了优化器、位置编码(positional encodings)、归一化(normalization)、激活函数(activation functions)、初始化等方面的关键创新5。
数据方面,我们从2019年的OpenWebText起步。它只包含Reddit上获赞足够多的链接所指向的网页,再经过去重和过滤,所以总共只有约90亿个词元(tokens),GPT-2的训练数据主要就是这些。到了2025年,UltraFineWeb这类开源数据语料库,通过抓取整个互联网,规模大了许多;过滤也精细得多,例如训练分类器,预测哪些数据能在实际实验中改善模型表现。
对我们的结果,一种天真的解读是:2019至2024年,即预训练时代,AI的大部分进步都只是来自更好的数据工程,例如提取、整理等;那个时期所有的模型工作,重要性都低得多。
但这恐怕误解了模型改进的价值。它们的主要贡献未必是计算效率,也就是用更少的FLOPs达到相同表现。它们的贡献是首先让更多计算量变得可用。随着参数数量、上下文长度、运行时长和集群规模增加,各种问题都容易出现:梯度爆炸或消失,内存和带宽耗尽,训练慢得无法进行。大量模型研究都在消除这些扩大规模的限制,或把限制推向更远处。许多最重要的创新都属于这一类,例如混合专家模型(MoEs)、稀疏注意力变体、稳定性方面的创新,包括归一化位置、初始化等,以及FlashAttention这样的系统或内核级优化。
我们在这里考察的数据改进,对更大模型的作用可能会小一些。小模型,比如我们训练的这些模型,会从数据质量改进中获得显著收益,因为它们容量有限,所以你必须谨慎挑选塞进去的东西。大模型则有那么多富余容量,也许你只想尽可能往里塞东西,即使其中大部分是垃圾,随机梯度下降(stochastic gradient descent)的魔法也会把信号从噪声中分离出来。如果选择激进过滤,就得训练几十轮(epochs);根据实证结果,这样表现更差,还不如使用平均质量较低、但规模更大的数据集。事实上,考虑到前沿模型为了尽量减少强化学习(RL)和部署所需的推理计算量,相对于Chinchilla计算最优方案的过度训练程度高达100倍,激进的数据整理就更有害了。
可以用帆船和集装箱船的差别来打个比方。集装箱船未必开得更快,但它能拖着几千吨货物,对应数百万亿个词元的预训练数据;也不会被风浪掀翻,对应在数十万块GPU上稳定训练。
如今我们有了容量更大、更结实的集装箱船,就不必为装船的具体货物费心了。只要哪怕有一点可能派上用场,都可以往里装。相比之下,对于2019年那些又小又脆弱的帆船,你必须极其谨慎,只带最有价值的货物。
但如果预训练进步的实质,只是往这艘船上装更多货物,那么我们是不是快没货了?这涉及数据墙(data wall),以及合成数据(synthetic data)在帮助我们越过数据墙方面到底有多有效。各家实验室显然都在广泛使用合成数据,而我们完全没有考察过,它能否在不损害模型表现的情况下,有效扩充数据语料库。如果收益有限,预训练进步的主要驱动力就会停滞,因为我们并没有制造更多互联网,而对一组固定数据的整理也只能做到某种程度。说清楚一点,我们目前没有实质理由认为会这样。但既然数据似乎对推动预训练进步如此重要,这就是一个必须研究的问题。
Ryan Greenblatt指出,历史上预训练数据语料库的许多改进,看起来都属于自动化研究者可以直接通过实证测试取得的进步。例如,用不同数据训练,做消融实验(ablations),看看模型表现如何。因此,如果我们实现AI研发的自动化,自2019年以来推动预训练的数据进步,可能会大幅加速;这种可能性与我们的结果完全相容。
我们想说明,单独看预训练,其进步会加速还是放缓,其实并不是AI总体进步最重要的问题,因为过去两年的许多收益都来自RL。
未来研究
下面这些方向,我们觉得会非常有意思,也涉及一些亟待回答的重要问题:
- 可以在更大的规模上运行这个实验,看看数据改进和模型改进,哪一个更依赖规模,从而在前沿规模下影响大得多。
- 以最终能力衡量,在预训练和后训练(post-training)中,高质量新数据的边际价值分别是多少?
- 我们希望广泛了解合成数据到底有多有效。一个可以研究的问题是:如果你有一小批高质量数据,通过生成合成数据把它扩充起来,相比只拿它训练多轮,究竟能好多少?
- 可以比较实验室在数据经纪商、环境生产者等方面的支出,与其在计算资源和研究人员上的支出,推算数据的隐含价值。
我们想研究数据在推动AI进步中发挥了什么作用。探究这个问题的方法还有很多,有些可能比我们的方法更聪明、更有信息量。就连我们的实验,也是在极小规模上做的。我们当然认为,漏掉什么东西是完全有可能的。我们很想听听别人会怎样研究这个问题,最好还能看到他们的结果!
特别感谢Charlie O’Neill参与的许多有帮助的讨论。
附录:方法
模型配方的计算倍数
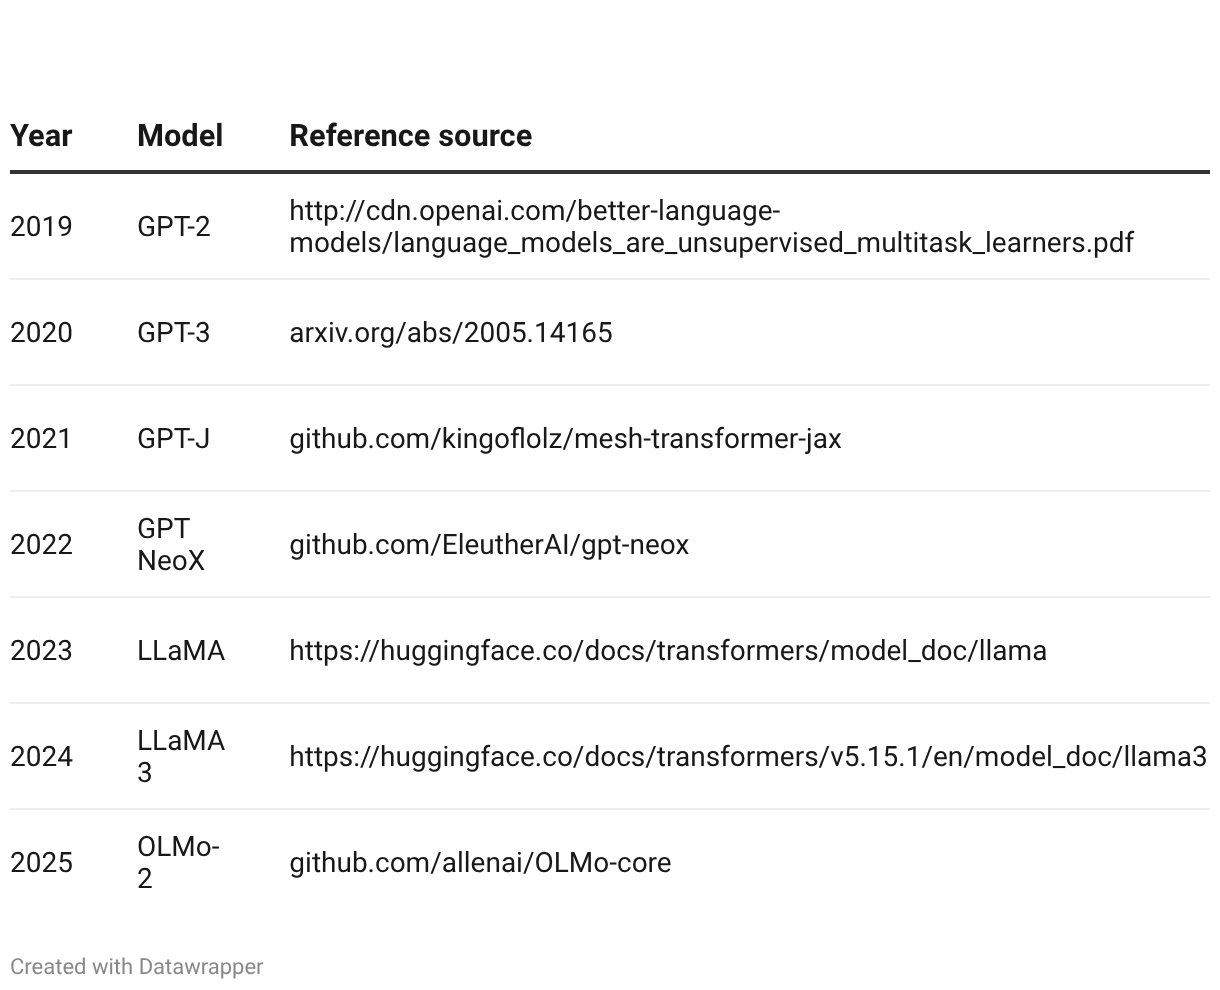
| 年份 | 模型 | 参考来源 | 1e19 FLOPs下的计算倍数 |
|---|---|---|---|
| 2019 | GPT-2 | http://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf | 1.00 (参考基线) |
| 2020 | GPT-3 | arxiv.org/abs/2005.14165 | 1.36 [1.16, 1.60] |
| 2021 | GPT-J | github.com/kingoflolz/mesh-transformer-jax | 1.71 [1.52, 1.96] |
| 2022 | GPT NeoX | github.com/EleutherAI/gpt-neox | 0.74 [0.56, 0.95] |
| 2023 | LLaMA | https://huggingface.co/docs/transformers/model_doc/llama | 1.68 [1.51, 1.92] |
| 2024 | LLaMA 3 | https://huggingface.co/docs/transformers/v5.15.1/en/model_doc/llama3 | 1.69 [1.52, 1.91] |
| 2025 | OLMo-2 | github.com/allenai/OLMo-core | 1.82 [1.66, 2.04] |
数据集的计算倍数
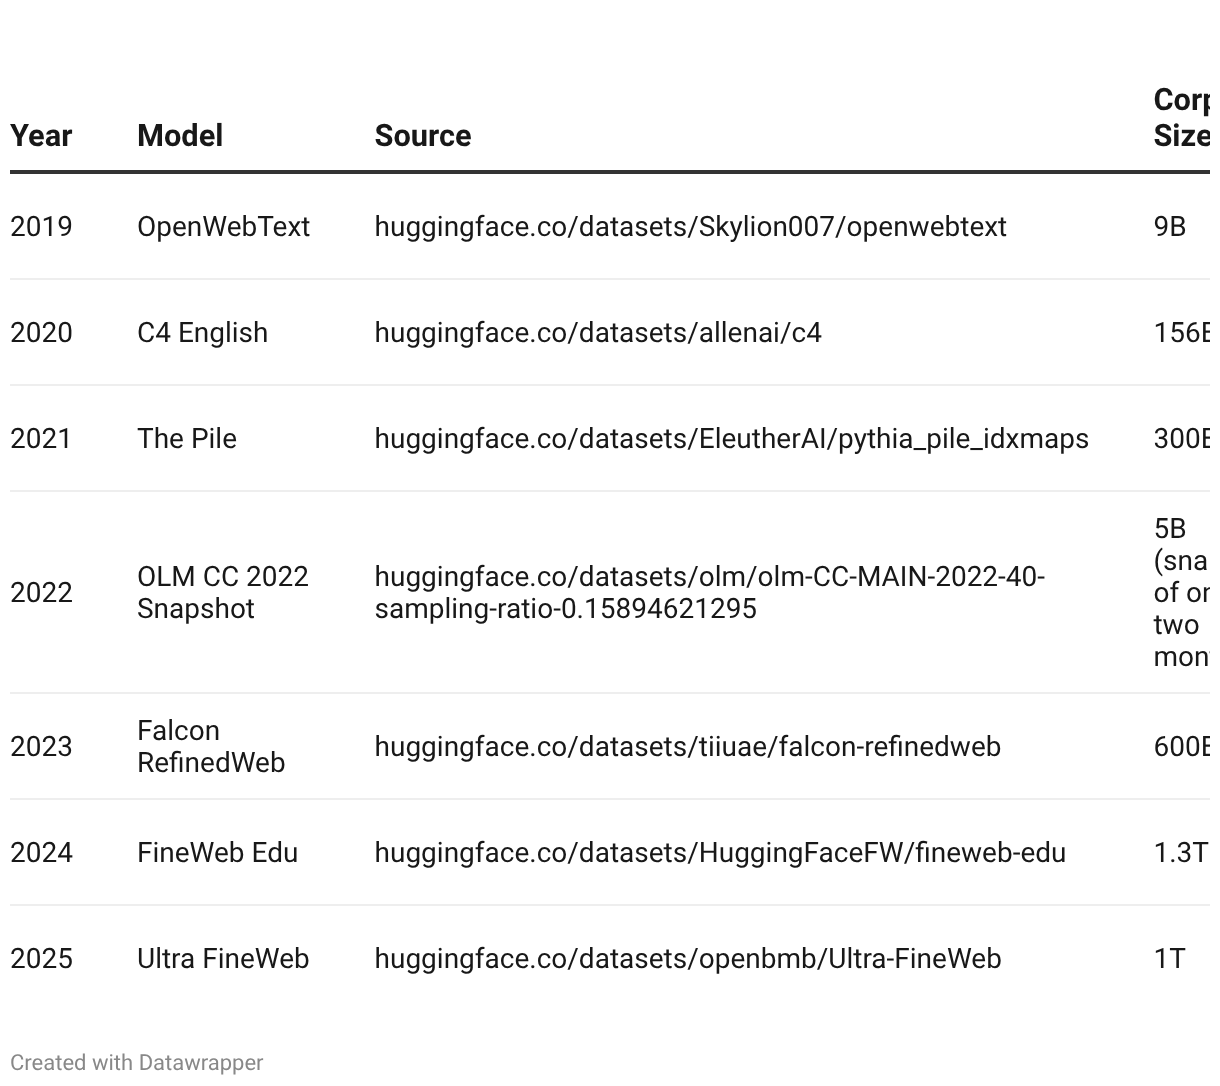
| 年份 | 模型 | 来源 | 语料库大小 | 1e19 FLOPs下的计算倍数 |
|---|---|---|---|---|
| 2019 | OpenWebText | huggingface.co/datasets/Skylion007/openwebtext | 9B | 1.00 (参考基线) |
| 2020 | C4 English | huggingface.co/datasets/allenai/c4 | 156B | 1.37 [1.09, 1.70] |
| 2021 | The Pile | huggingface.co/datasets/EleutherAI/pythia_pile_idxmaps | 300B | 0.98 [0.73, 1.22] |
| 2022 | OLM CC 2022 Snapshot | huggingface.co/datasets/olm/olm-CC-MAIN-2022-40-sampling-ratio-0.15894621295 | 5B(仅两个月的快照) | 2.59 [2.21, 3.15] |
| 2023 | Falcon RefinedWeb | huggingface.co/datasets/tiiuae/falcon-refinedweb | 600B | 2.62 [2.14, 3.34] |
| 2024 | FineWeb Edu | huggingface.co/datasets/HuggingFaceFW/fineweb-edu | 1.3T | 8.63 [6.98, 10.81] |
| 2025 | Ultra FineWeb | huggingface.co/datasets/openbmb/Ultra-FineWeb | 1T | 8.66 [6.68, 11.01] |
我们以这些模型配方,在不同数据语料库上从头进行预训练,采用不同计算预算,并使用多个独立随机种子6。计算预算分别为1e17、3.16e17、1e18、3.16e18和1e19 FLOPs。计算量核算采用名义计算量(nominal compute)的约定:C = 6ND,其中N是非嵌入参数的数量,D是数据词元数。
在每个计算预算下,我们改变参数数量,从而也改变训练词元数,以确定每个训练配方×语料库组合的计算最优搭配。我们用语料库上的留出集损失(held-out loss)确定这个计算最优点。随后可以得到每个组合的下游表现随计算量变化的缩放曲线(compute scaling curves),最后从中提取计算倍数。
所有训练运行都使用相同的分词器(tokenizer)和上下文长度:GPT-2字节对编码(BPE),由tiktoken实现,词表大小为50,257;T=2048,批量(batch)为262,144个词元。
训练运行的最终能力高度依赖超参数。显然,不可能遍历所有超参数组合,调超参数确实是一门精细的艺术!我们尽力控制这一影响,并把峰值学习率(peak learning rate)看作最重要的超参数。
某些年份的算法配方会规定,峰值学习率应当如何调节,它是模型大小、数据预算、批量大小等相关变量的函数。这些规定,为我们判断最优学习率提供了有用的先验。
我们先在5个锚点上扫描学习率,覆盖3种不同模型大小和2种不同的D/N比值。确定这些锚点的最优学习率之后,再拟合最优学习率的参数形式:
$$ lr(N, D/N) = lr_0 \cdot (N/N_0)^a \cdot \left( \frac{D/N}{(D/N)_0} \right)^b $$
对于除OLMo-2以外的所有模型配方,我们拟合共用的指数a和b,以及各模型特有的lr₀。OLMo-2则使用模型配方规定的最优学习率。之所以对OLMo-2这样处理,是因为Ai2发表配方时,同时公布了小模型阶梯(small-model ladders),规定了我们所研究规模下的最优超参数。我们还在3.16e18 FLOPs的计算最优点核实了,实际训练所用的学习率处于最优值或接近最优值。
主要技术结果
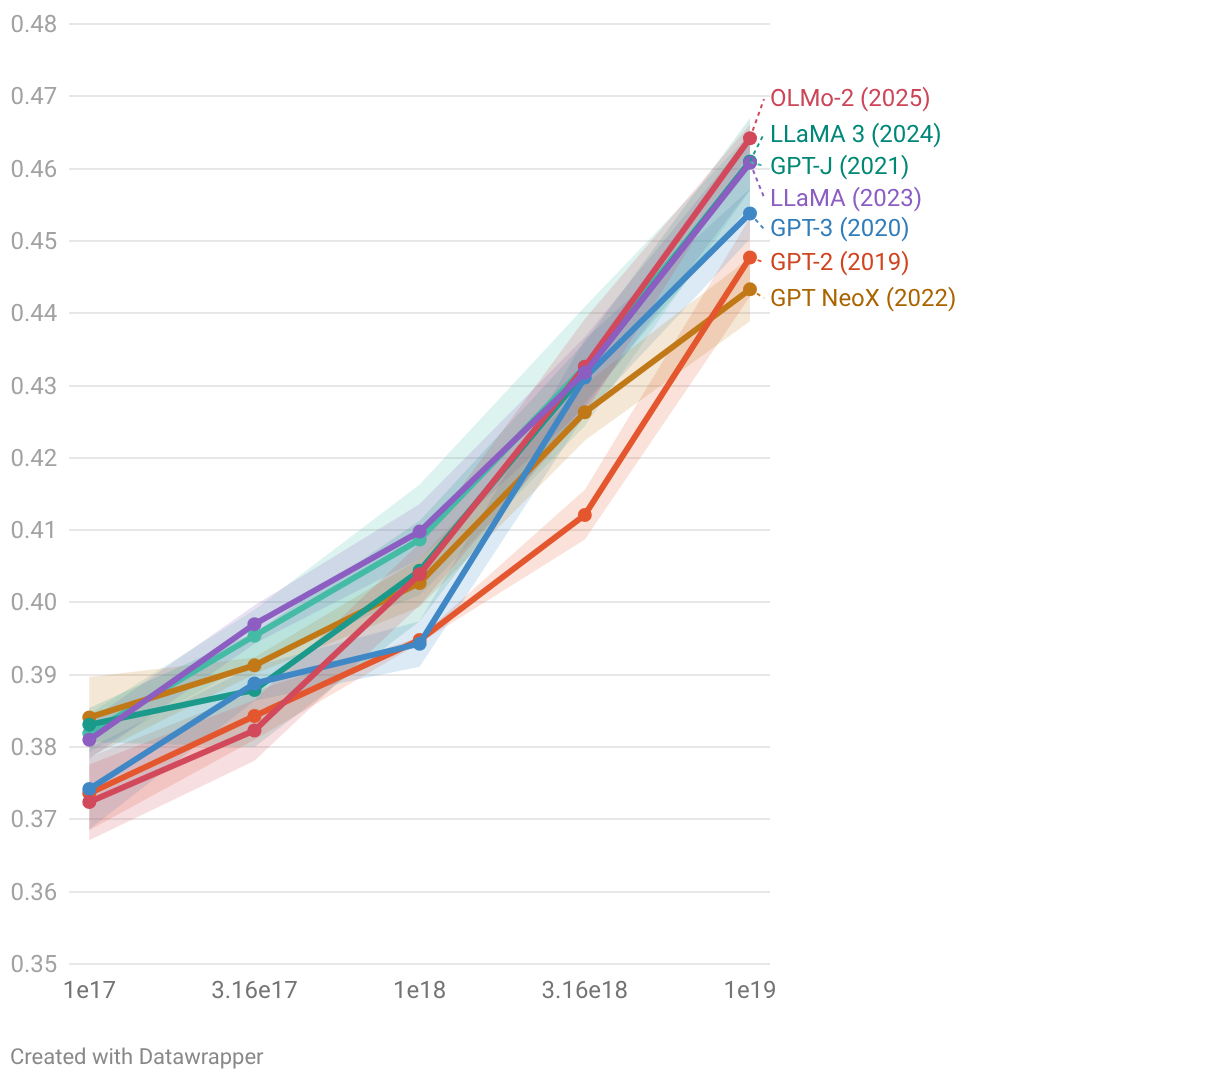
在FineWeb Edu上训练不同模型时,OLMES得分随计算量的变化
图表来源:Han & Patel。
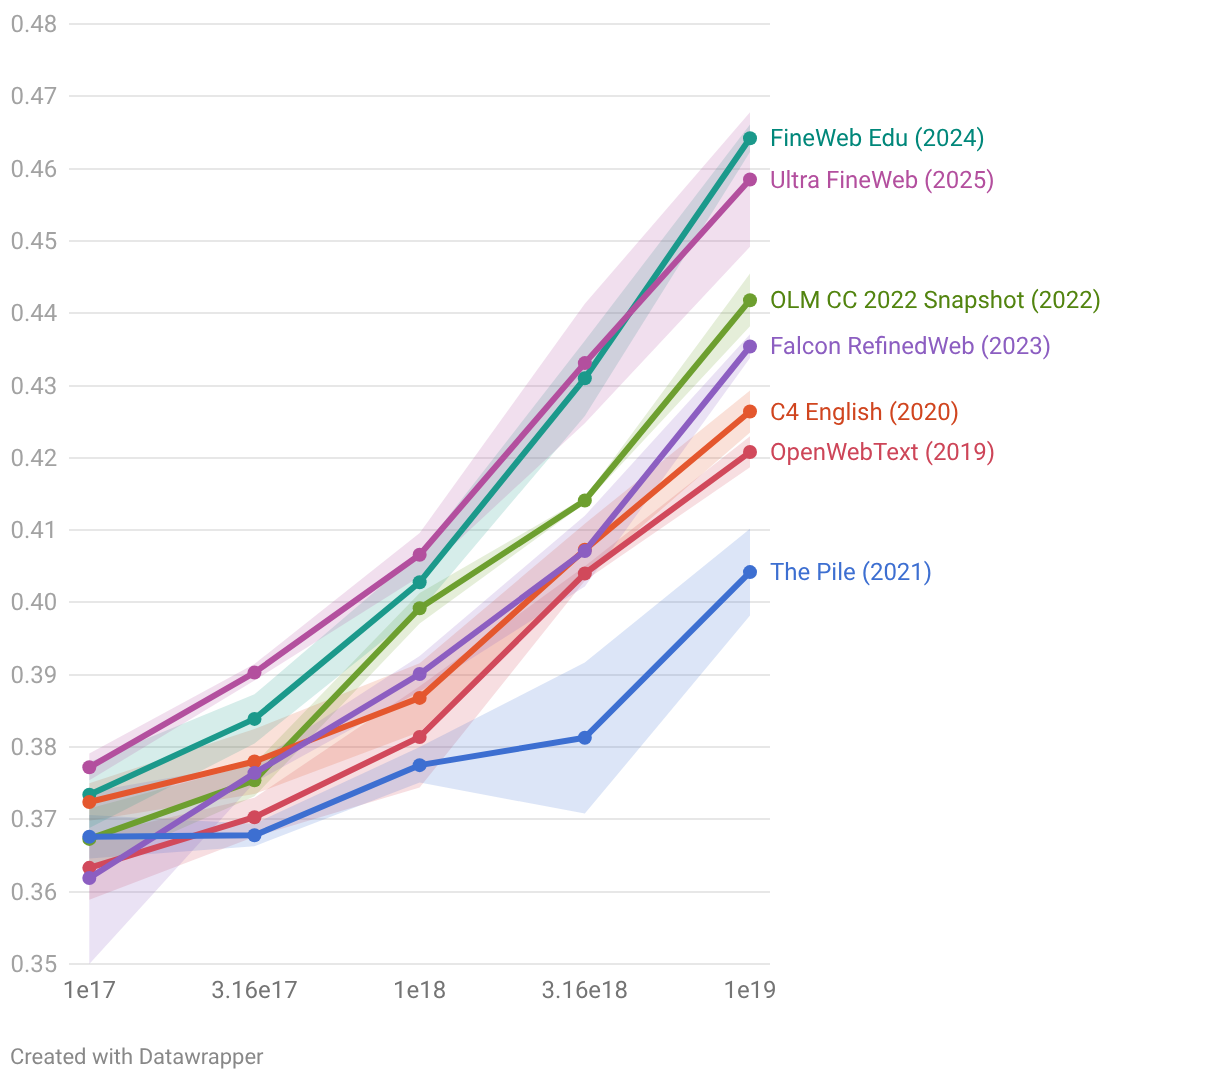
在不同数据语料库上训练OLMo-2时,OLMES得分随计算量的变化
图表来源:Han & Patel。
解释图中的一些异常
正如预期,在模型和数据两个维度上,计算效率总体都随时间提高。我们观察到的一些异常值如下:
- 在1e19 FLOPs下,NeoX表现不如GPT-2,尽管它在1e17至3.16e18的范围内表现更好。这可能来自OLMES评测的噪声。我们还注意到,以FineWeb-Edu语料库上的留出集预训练损失衡量,NeoX表现优于GPT-2。
- The Pile似乎比OpenWebText差得多。这并不奇怪,因为The Pile的主要改进在于数据语料库的多样性,而非过滤。它是从22个来源整理而成的混合数据,包含PubMed和arXiv论文、GitHub代码、法律意见、专利、议会会议记录等。对于其中许多词元,在OLMES上的跨领域迁移(cross-domain transfer)效果可能很有限,因为OLMES考的是英语网页文本选择题,所以计算效率更低。我们注意到,考虑到The Pile的规模更大,我们预计,在更大的规模下,它最终应当优于那个非常小的OpenWebText。
- 还应注意,NeoX和The Pile的计算倍数是通过外推(extrapolation)得到的,这会引入额外的潜在误差。
计算倍数及其误差条的计算方法
- 计算缩放曲线上的每个点,都来自多个使用独立随机种子的训练运行。图中的误差条(error bars)是这些随机种子对应的OLMES评测得分的标准差。
- 假设在某个计算量下,我们的参考模型或参考数据语料库达到了某个参考表现水平。
- 接着,我们在候选模型或候选语料库的计算缩放曲线上,找到最靠左、首次达到该参考表现水平的点,以此计算倍数。参考方案所需的计算量除以候选方案所需的计算量,就是候选方案的计算倍数。
- 计算倍数的误差条,来自对整个估算流程进行参数自助法(parametric bootstrap),表示1个标准差的区间。
- 我们想特别强调:模型配方计算倍数的实际不确定性,预计会高于误差条所表示的不确定性。这是因为我们做的超参数调优有限,带来了额外的不确定性;最终能力或留出集损失,很可能对峰值学习率、批量大小等的确切取值相当敏感。
还要注意,我们的消融实验未必涵盖计算效率收益的全部范围,原因有很多。实际上,2019至2025年间,我们观察到模型改进的逐年计算效率收益(compute efficiency gains,CEG)为1.24倍[1.19, 1.29],数据改进为1.51倍[1.45, 1.57]。联合衡量时,我们观察到的逐年CEG为1.57倍[1.49, 1.65]7。这确实远低于Anson Ho等人估计的年均3倍,原因如下:
- 许多收益可能依赖规模,或者在更长的上下文中尤其重要,而我们所用的规模太小,许多收益还无法实现。
- 例如,OLMo-2的层归一化和查询—键归一化(QK norms),以及NeoX中并行的注意力+多层感知机(MLP)模块。
- 推理效率优化,例如LLaMA-3的分组查询注意力(GQA),它优化的是键值缓存(KV cache),不会在我们的研究中体现为计算倍数。我们也没有考察分词器的改进。
- 我们得到的计算倍数,对每年所选择的模型配方或数据语料库相当敏感。我们选择了自己认为有代表性的模型配方或数据语料库。但我们绝没有穷尽所有可能,进而断言它们是每年最好的。
- 我们考察的是相对于OLMES基准的计算倍数。它综合了10种相对简单的任务类型;我们考察的并非达到某个困惑度(perplexity)指标所需的计算倍数。如果换用其他基准,例如专门测试编码或问题求解的基准,数值也会很不一样;那些基准很可能奖励完全不同的数据工程方法。
我们还想指出,我们没有考察其他数据改进,例如从新来源收集更多高质量数据、人类专家生成的数据、合成数据生成方法等。我们研究的大多数语料库,都是同一个Common Crawl经过整理后的子集,并没有扩大可用数据的集合。这显然是在消耗有限的存量,这条路能走的距离终究有限。
模型配方与数据语料库收益的独立性
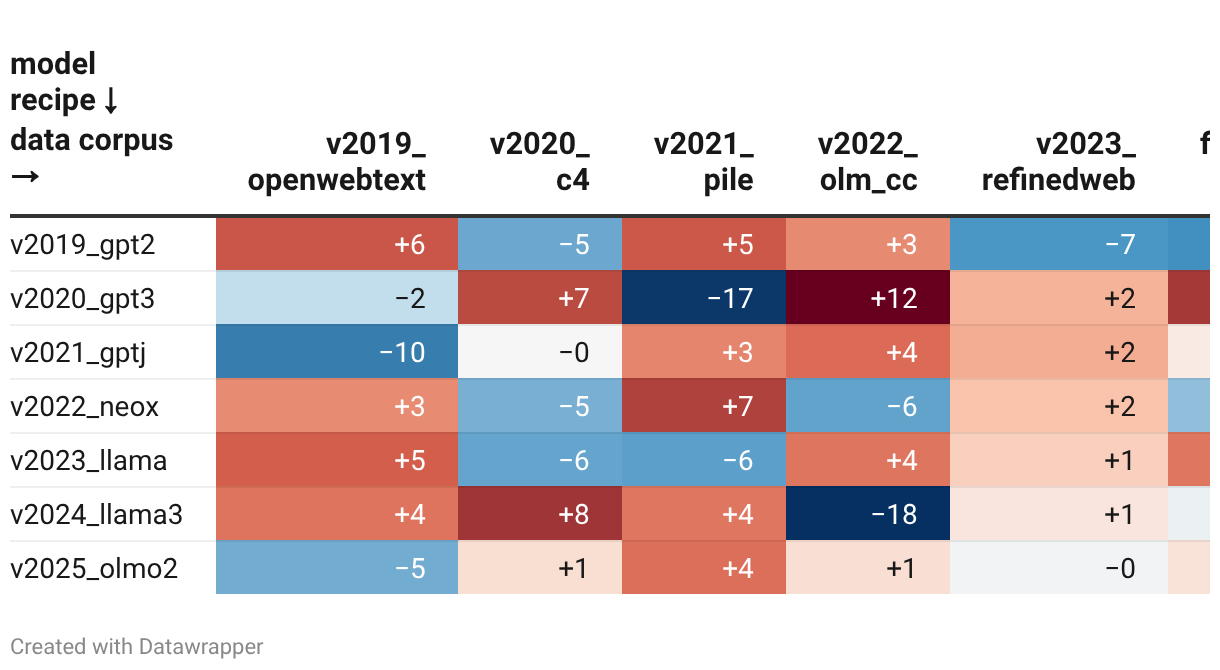
下面是我们为确定模型配方收益和数据语料库收益有多独立而做的研究。我们考察了3.16e18 FLOPs下的OLMES得分网格。对“OLMES得分=均值+模型效应+数据效应”进行线性回归,得到决定系数(R²)为0.88。这意味着,OLMES得分方差的88%,可以用模型改进和数据改进的加法效应解释;只有约12%的方差来自交互作用或高阶项,以及评测噪声。这提示,复杂的模型—数据交互作用相对较小,也就是某项模型改进的利用依赖特定数据工程,或反过来的情况,影响相对较小。
加法分解的残差
对于3.16e18 FLOPs下的模型×数据网格,残差为:观测值−(μ+模型效应+语料库效应),以准确率的千分之一为单位。
图表来源:Han & Patel。
| 模型配方↓/数据语料库→ | 2019 OpenWebText | 2020 C4 | 2021 The Pile | 2022 OLM CC | 2023 RefinedWeb | 2024 FineWeb Edu | 2025 Ultra FineWeb |
|---|---|---|---|---|---|---|---|
| 2019 GPT-2 | +6 | -5 | +5 | +3 | -7 | -8 | +7 |
| 2020 GPT-3 | -2 | +7 | -17 | +12 | +2 | +8 | -10 |
| 2021 GPT-J | -10 | -0 | +3 | +4 | +2 | +0 | +0 |
| 2022 GPT NeoX | +3 | -5 | +7 | -6 | +2 | -4 | +3 |
| 2023 LLaMA | +5 | -6 | -6 | +4 | +1 | +4 | -2 |
| 2024 LLaMA 3 | +4 | +8 | +4 | -18 | +1 | -1 | +2 |
| 2025 OLMo-2 | -5 | +1 | +4 | +1 | -0 | +1 | -1 |
此文章由AI翻译
Footnotes
-
Anson Ho等人估计,预训练的软件效率每年提高3倍,95%置信区间(CI)为1.5倍至64倍。正如Ho在这篇博客中所说:“大部分软件进步,实际上可能来自数据质量改进”,以及“将少数几种依赖规模的算法变化扩大规模”。 ↩
-
我们采用C = 6ND的名义约定核算计算量。 ↩
-
2019年的模型配方是GPT-2,2025年的是OLMo-2。2019年的数据语料库是OpenWebText,2025年的是UltraFineWeb。 ↩
-
我们实现的GPT3在The Pile上出现了一些训练不稳定现象,即梯度尖峰(gradient spikes)。 ↩
-
其中包括:优化器改进,预热+衰减调度(warmup + decay schedules),用旋转位置编码(RoPE)替代学习式绝对位置编码,均方根归一化(RMSNorm)+SwiGLU门控MLP,调整归一化顺序,QK归一化,Z-loss正则化,以及更干净的初始化。 ↩
-
计算缩放图中的每个点,我们都至少使用3个随机种子。对于3.16e18预算下,模型配方与数据语料库组合构成的7×7网格,每个组合只用了1个随机种子。 ↩
-
1.57倍的逐年倍数,是用2019年模型+语料库到2025年模型+语料库的联合改进计算的,并不是模型改进1.24倍与数据改进1.51倍的乘积。 ↩