思考预训练与强化学习各自如何学习
以及这对可验证奖励强化学习(reinforcement learning with verifiable rewards,RLVR)进展的启示
最近,有人一直在讨论,强化学习(reinforcement learning,RL)获得一个样本所需的浮点运算次数(FLOPs),远远多于监督学习(supervised learning)。预训练(pretraining)中,你训练的每个词元(token)都会给出一个信号。强化学习中,你必须展开一条长达数万词元的完整思考轨迹(trajectory),才能在末尾得到一个奖励信号,比如:我的代码单元测试通过了吗?这道数学题答对了吗?诸如此类。
但这只是问题的一半。比较强化学习与监督学习的学习效率,有一个简单的办法:
$$ \text{Bits/FLOP} = \text{Samples/FLOP} \times \text{Bits/Sample}. $$
也就是:每次浮点运算获得的比特数 = 每次浮点运算获得的样本数 × 每个样本获得的比特数。
我还没听到有人讨论这个等式中的另一项:每个样本的比特数(Bits/Sample)。而在训练的大部分时间里,强化学习每个样本的信息密度要低得多得多。
用直白的话来说
监督学习,也就是预训练,只是在不断吸收比特。每个词元都暗示着语言的结构、组织这种语言的头脑,以及这个头脑所看到的世界。训练初期,模型完全随机,对所有这些内容的不确定性都达到最大。因此,每个词元都让你大开眼界。同时,你会得到一个精确的信号,告诉你对正确答案的判断错了多少,以及应该更新哪些参数,才能少错一些。
假设你从一个随机初始化的模型开始训练。如果你用监督学习对“The sky is”(天空是)做下一词元预测(next-token prediction),训练循环会说:“其实是‘blue’(蓝色)。你说‘blue’的概率是 0.001%。把那些指向‘blue’的连接大大增强。好,下一个词元。”
使用策略梯度(policy gradient)的强化学习,会提高所有答对轨迹的权重,降低所有答错轨迹的权重。但一个本来就不怎么聪明的模型,答对的概率低得惊人。
如果你用强化学习对“The sky is”做下一词元预测,训练循环大概会这样说:“好,‘halcyon’错了。别再做导致你说出‘halycon’的那些事……好,‘serendipity’也错了……”如此反复猜测,次数大约相当于词表中的词元数量,也就是十万这个量级。
具体细节
来想一想:随着通过率(pass rate,$p$)变化,每个样本最多能提供的比特数会怎样变化。这里的通过率指说出正确答案的概率。为简化讨论,假设答案只有一个词元。那么,对于一个完全没训练过的模型,通过率就是 $1/\text{词表大小}$。
在监督学习中,每个样本的正确标签都会被准确地告诉你。学到多少新信息,取决于你在得知正确答案时有多惊讶:通过率,也就是正确答案的先验概率越低,看到正确标签时学到的东西就越多。熵(entropy)的基本公式告诉我们,监督学习中每个样本可以学到 $-\log(p)$ 比特。
在强化学习中,你只会被告知答案对不对。能提取多少新信息,受到你对这个二元结果有多不确定的限制。如果你几乎总能通过($p \approx 1$),或几乎总是失败($p \approx 0$),每次尝试都很难让你感到意外。当通过的概率像抛硬币一样($p \approx 0.5$)时,你学到的最多。二元随机变量信息量的基本公式告诉我们,强化学习中,每个样本最多可以学到以下比特数:1
$$ \operatorname{Entropy}(p)=-p\log(p)-(1-p)\log(1-p). $$
好,来画一下这个关系。
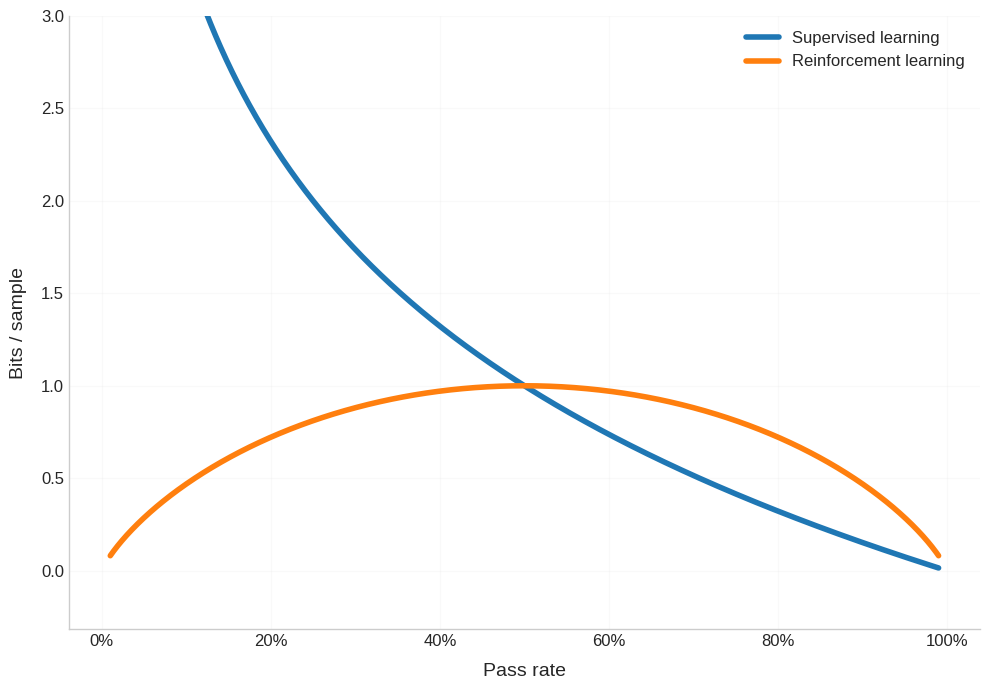
看起来还不算太糟。是的,在一半的通过率范围里,预训练要好得多;但在另一半范围里,强化学习更好。不过,这张图非常容易误导人。因为缩放定律(scaling laws)中的幂律(power law)意味着:通过率每提高一个数量级,都需要相当的计算量。如果从 $1/100{,}000$ 的通过率提高到 $1/10{,}000$ 花了 $X$ 次浮点运算,那么从 $1/10{,}000$ 提高到 $1/1{,}000$ 也会花 $X$ 次浮点运算。所以,我们实际上应该用对数尺度来绘制通过率,再强调一次,这样才能体现横轴上每一段增量对应相同数量的浮点运算。
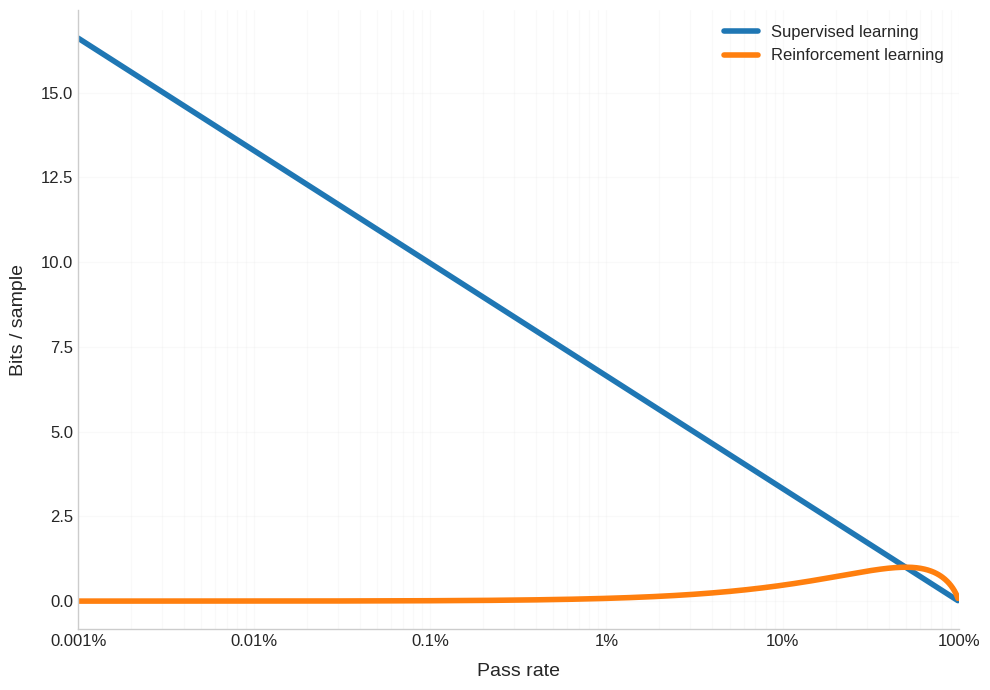
天哪,这幅图真让人难过。强化学习每个样本的信息密度能与预训练相当的区域,只占训练最末尾的一小段,而那时你已经有了一个相当不错的模型。
我还想再次强调,这与另一个问题完全是两回事:获得一个强化学习样本,也就是在得到任何信号之前展开一条完整轨迹,所需计算量可能超过百万倍。
实际上比这还糟:方差
训练初期,强化学习的情况实际上比前面讨论的还要糟。当通过率很低时,梯度估计会极其嘈杂、难以预测。你要么在一批样本中完全没有采到正确答案,此时几乎得不到信息;要么采到了,随之出现一个巨大的尖峰。训练被来回拉扯,这非常不利于高效训练。2
有意思的是,预训练面对的问题正好相反。它在训练末期的方差(variance)特别高。随着预训练推进,你耗尽了越来越多的可约减损失(reducible loss),也就是模型真正能从数据中学会的东西。剩下的大多是不可约减损失(irreducible loss),即互联网文本本身固有的不可预测性。
提示语“Bob’s favorite color is”(Bob 最喜欢的颜色是)该怎么接下去?这得看 Bob。并不存在一个正确答案,让你那个超级聪明的模型真正变得善于预测。然而,无论有人在互联网上随手写了什么答案,你那个超级聪明的模型仍会据此更新梯度。这种噪声淹没了一个批次里那几个真正可以学会的词元提供的真实信号。我不知道这是否准确,但预训练末期这种方差的激增,似乎与为什么预训练越往后批大小就越大有关。
进入强化学习的恰到好处区间
如果强化学习在通过率远大于 1% 的区域效果最好,那么就有一个问题:我们怎样设计强化学习训练,让模型进入并保持这种学习的心流状态?
例如,我们可以把预训练和推理规模扩展(inference scaling)看作提高强化学习过程中的通过率,从而让你能从每个样本中提取多得多的比特。
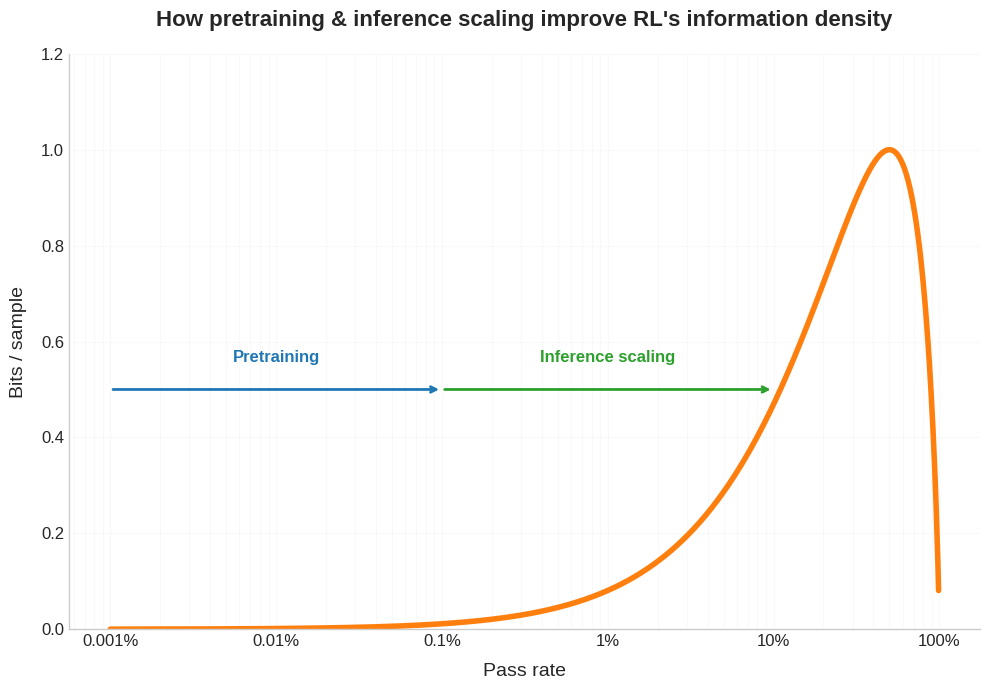
有人指出,课程学习(curriculum learning)对预训练没有特别大的帮助,但对强化学习往往必不可少。考虑到强化学习只有在通过率恰到好处的这个区间(Goldilocks zone),才能从每个样本中获得有意义的比特,这就完全说得通了。因此,你确实希望按顺序安排学习,让挑战难度随模型智能一起提高。
我们的通过率框架,也很好地解释了为什么自我对弈(self-play)在强化学习的历史中如此富有成效。如果你与一个水平和你几乎相当的对手竞争,通过率就会在 50% 左右维持平衡,而这正是强化学习中每个样本比特数函数的峰值。
但自我对弈并不是我们能想到的、在整个训练过程中保持较高通过率的唯一办法。也许我们可以设计某种密度高得多的代理评估(proxy evaluation)。这里的密度可以指两种东西中的一种:
- 每次浮点运算的样本密度(Samples/FLOP):用这种代理评估来估计最终奖励,但在一次回合(episode)中更早地估计,省下展开完整轨迹所需的计算量。这就是价值函数(value function)做的事情。
- 每个样本的比特密度(Bits/Sample):设计一个比正在讨论的实际测试容易通过得多的代理目标(proxy objective)。我能想到的最简单例子,是一个过程奖励模型(process-reward model),它说:“嘿,这次轨迹采样(rollout)得到了错误答案,但我能看出,它一开始的推理方向是对的。所以,让我们提高那些早期词元的权重。”
关于为什么迄今很难为大语言模型(LLMs)开发出这类有用的代理目标,可参阅 DeepSeek R1 论文的第 4.2 节。
比特确实更少,但非常有价值
公平地说,虽然强化学习中每次浮点运算可能学到的比特少得多,但学到的比特非常重要。它们与预训练中的比特不能直接放在一起比较。主要有两个原因:
- 预训练教你的是互联网的数据流形(data manifold)是什么样子,这与“我怎样完成有经济价值的任务?”只有部分、间接的关系。而强化学习有望直接给你真正有用的东西。
- 即使预训练语料包含完成某个具体任务的指令,也没有这样的思考轨迹来教模型:如何纠正自己的错误,或运用它那套能力参差不齐、不同于人类的技能来完成任务。
对此的反驳是:这些比特只存在于通过率范围中的很小一部分。再强调一次,这里按对数尺度加权,以体现训练的大部分时间里通过率都糟糕透顶。
顺便说一句,现在我们可以理解那些说法了:RLVR 只是在激发预训练模型中已经潜藏的能力。当然会是这样。如果预训练模型一开始没有足够高的通过率,那么强化学习每个样本的比特数就会少得惨不忍睹,因此根本学不到什么。第 37 手显然是一个著名的例子,在那里,强化学习确实教会了模型一种全新的策略。值得一提的是,AlphaGo 通过自我对弈训练,前面说过自我对弈如何提高通过率;而且在当时,AlphaGo 的计算投入大得惊人。
强化学习中参差不齐的能力
有人指出,从实际表现来看,RLVR 只是让模型把一种思考模式与一种问题类型关联起来,而没有让它形成一种更通用的策略:退一步,想清楚最佳方法是什么。
想想看,怎么会有这样的模型:在编程竞赛中达到世界级水平,同时却在整个代码库里留下极其容易预见的缺陷和技术债?
这种奇怪的能力参差不齐(jaggedness)该如何解释?我想到了一个可能的解释:RLVR 无法区分一条轨迹是由更能泛化的程序生成的,还是仅仅以贪心方式,把问题的形态匹配到某个相关的思考过程。
当你用策略梯度采样轨迹时,这种更复杂的通用策略几乎不可能被采样到;简单的启发式策略(heuristic policy)却会被采样到,而且出现频率会不断增加,直到达到固定(fixation)。与此同时,通用策略越来越远地淡出视野。
那么,问题是:怎样在简单的启发式解法与更复杂的通用解法之间搭起一座短桥?随着时间跨度(time horizon)扩大,这座桥会自发出现吗?
我担心的是,即使在时间跨度更长的任务中,这种退一步、依据自己对世界的理解作出有品位判断的通用策略,也仍然很难通过 RLVR 被凸显出来。因此,要解决这种能力参差不齐的问题,需要一种更通用、更稳健的训练程序,而不能只靠扩大 RLVR 的规模。
人类的学习
这里,我们讨论的只是无模型强化学习(model-free RL)每个样本学到的比特,也就是从一个回合结束时的某种二元结果中学到的比特。但人类的学习效率显然高得多。想想一位连续创业者。我们会说,她有大量来之不易的智慧和经验。这些学习,很少来自上一次回合的那一个比特的结果,也就是创业成功了还是失败了。
人类从经验中学习,在机器学习(ML)中对应什么,目前并不清楚。显然,我们的观察和反思会更新我们的世界模型(world model),独立于最终结果。这在我们的学习中发挥着非常重要的作用。
也许我们不该问:怎样把无模型强化学习的通过率推到约 50%,好从结果中挤出满满一滴信息。也许我们该问:人类怎样从环境中榨出一桶又一桶的信息?
此文章由 AI 翻译