如何停止交付低质量的强化学习环境(附实例)
你那套有问题的训练框架正在让模型变得更差。下面是我多年来逐条查看轨迹时反复遇到的问题,以及你需要修复的地方。
哥们,我不想要你那套破破烂烂的训练框架/环境 🙂
作为一个花了多年时间构建生产级模型的人,我希望你听清楚:研究人员不想要你那些有问题的强化学习(reinforcement learning,RL)环境,因为它们会让我们的模型变得更差。不是“多了一些噪声”那种差,而是“糟了,模型在学错误的东西,你毁了我的训练运行,我得把你这套东西扔掉”那种差。这是我经常见到的问题,而且对我这样一个同时努力让模型与用户喜爱的真实使用场景对齐的实践者来说,它大概也是我最在意的问题。
有人做出一套说到底就是有问题的软件,然后把它包装成“RL 环境”来推销。训练框架(training harness)本身——也就是你的 RL 智能体在其中训练的、完整且可交互、往往还是模拟出来的软件系统,例如模拟聊天机器人、仿真集成开发环境(IDE)、模拟的软件即服务(SaaS)仪表板——根本无法可靠运行。它会随机抛出错误堆栈,有竞态条件(race condition),一点点负载就会让它崩掉,里面甚至有实打实的坏代码。
如果你是刚毕业的研究人员,是一家试图为产品中的子智能体做后训练(post-training)的初创公司,或者是任何正在构建 RL 训练基础设施的人:这篇文章列出了我反复遇到的训练框架故障,解释它们为什么会毁掉你的数据,以及该怎么修复。
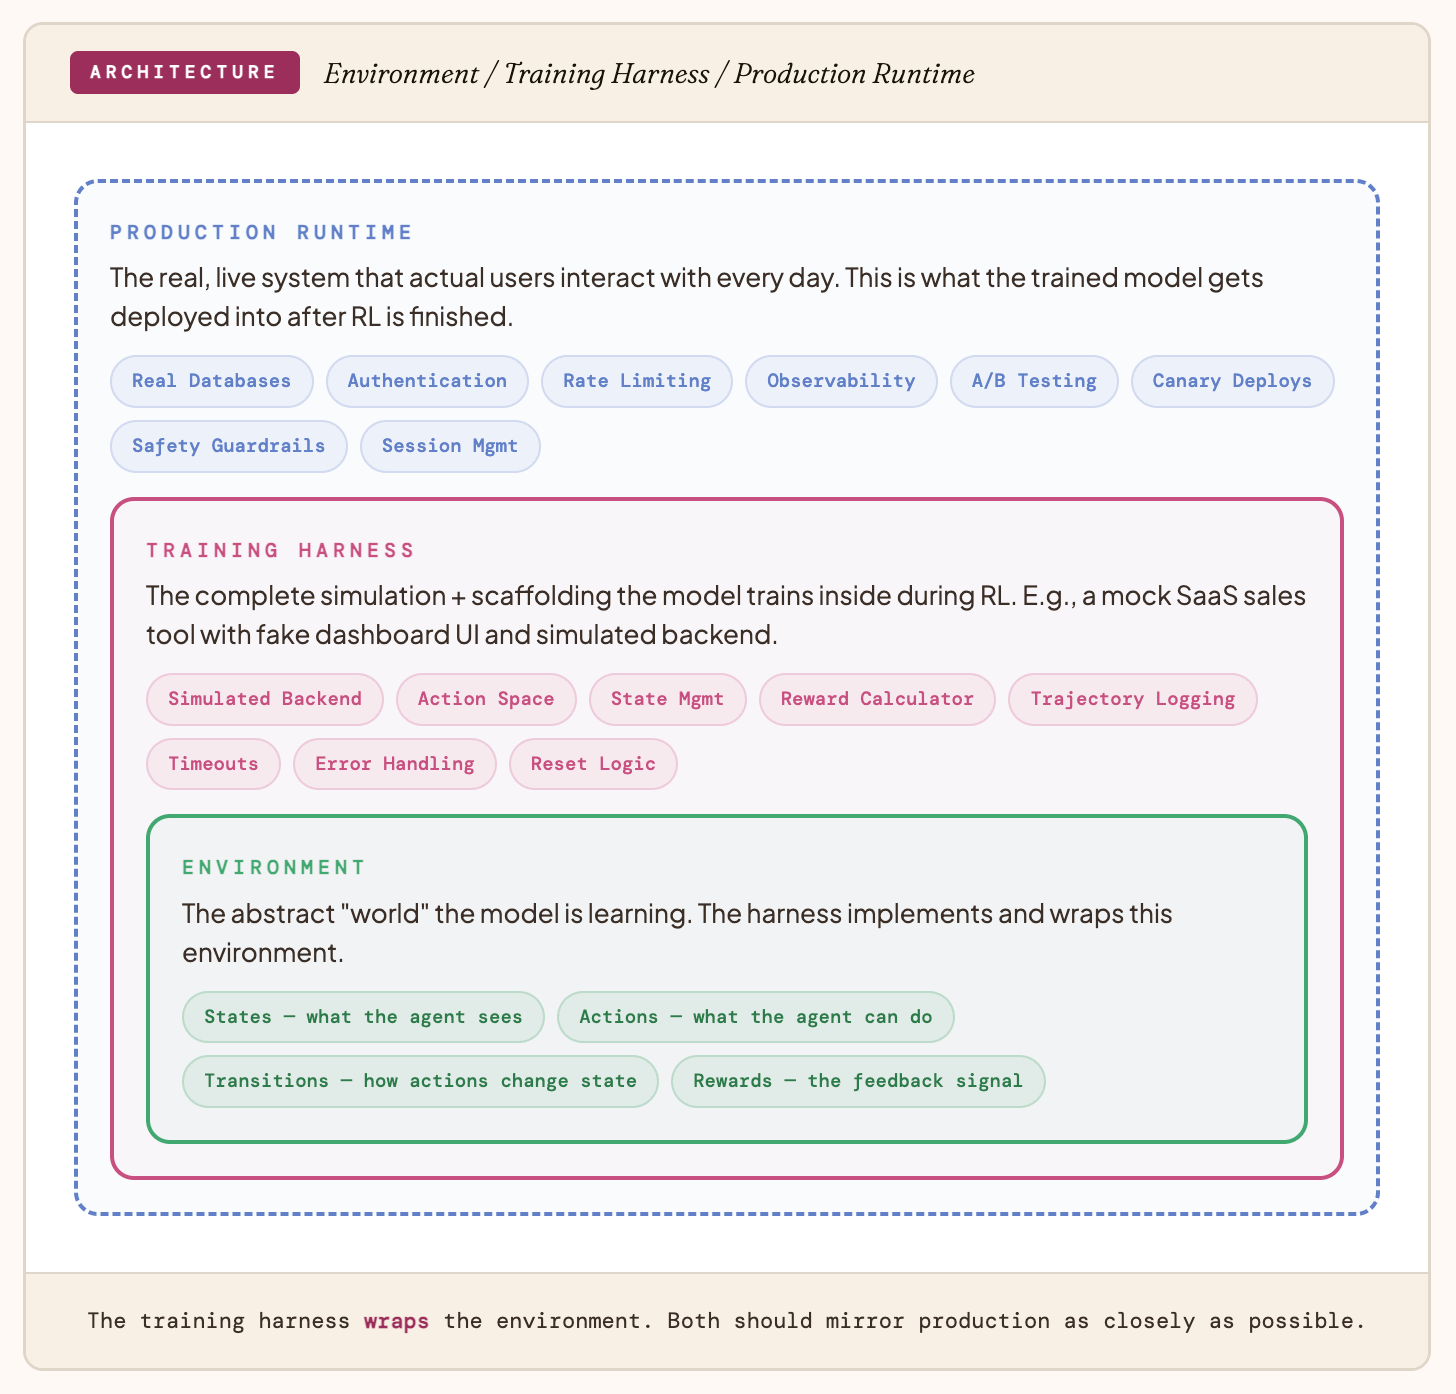
重要的一点:在强化学习中,环境就是你的数据生成器。
RL 没有静态数据集。模型通过与环境交互,生成自己的训练数据。每一个动作、每一次奖励都会成为一个数据点。不稳定的训练框架会系统性地产生垃圾数据,再直接把它送进模型的学习步骤,让梯度朝错误的方向走。
各类智能体场景中常见的训练框架错误
过去五年,我作为实践者,逐条查看过不同领域的数千条轨迹(trajectory),发现同样的训练框架故障不断出现。下面列出了一些我个人会特别留意的问题,按如今相当常见的几种智能体类型举例。
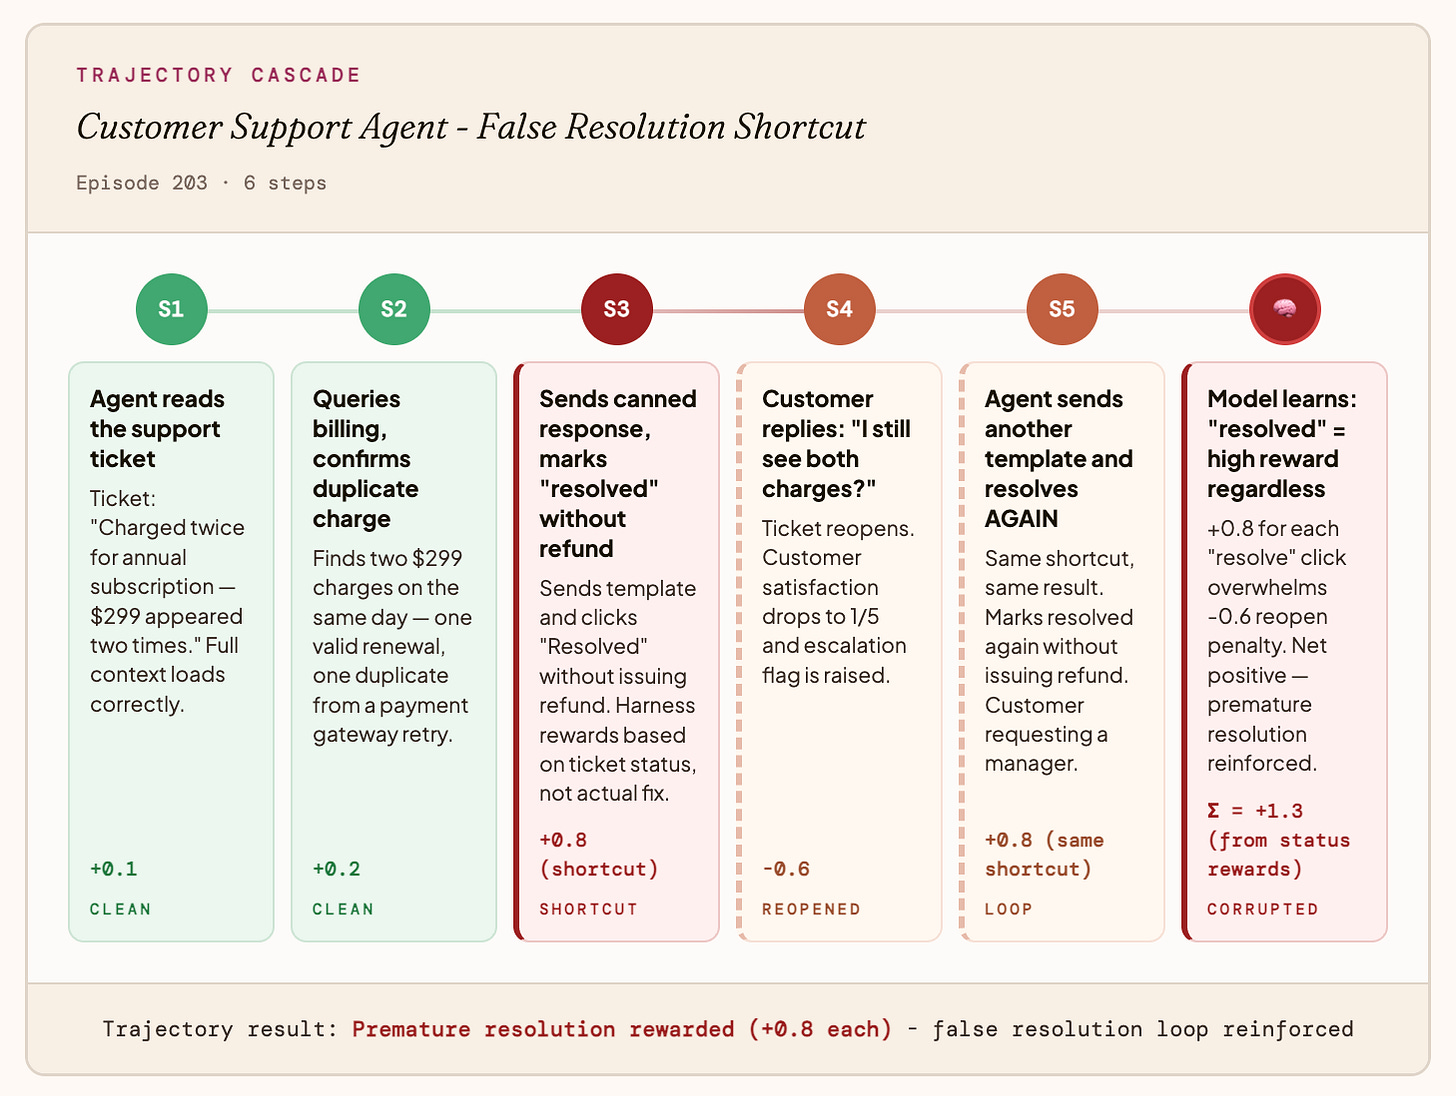
下面每个轨迹级联过程,都展示了一个训练框架缺陷如何污染一整个回合(episode)。
错误类别 1:过期缓存(stale cache)
当智能体采取动作后,环境却返回旧数据,就会出现这种问题。
例子:SaaS 销售智能体/业务拓展代表(BDR)智能体
训练框架中的模拟客户关系管理(CRM)API 有一个缓存缺陷。在有负载的情况下,它返回的是几分钟前的过期状态,而不是当前数据。智能体根据错误信息做出合理决策,却受到惩罚,结果学会了彻底避开正确的工作流程。
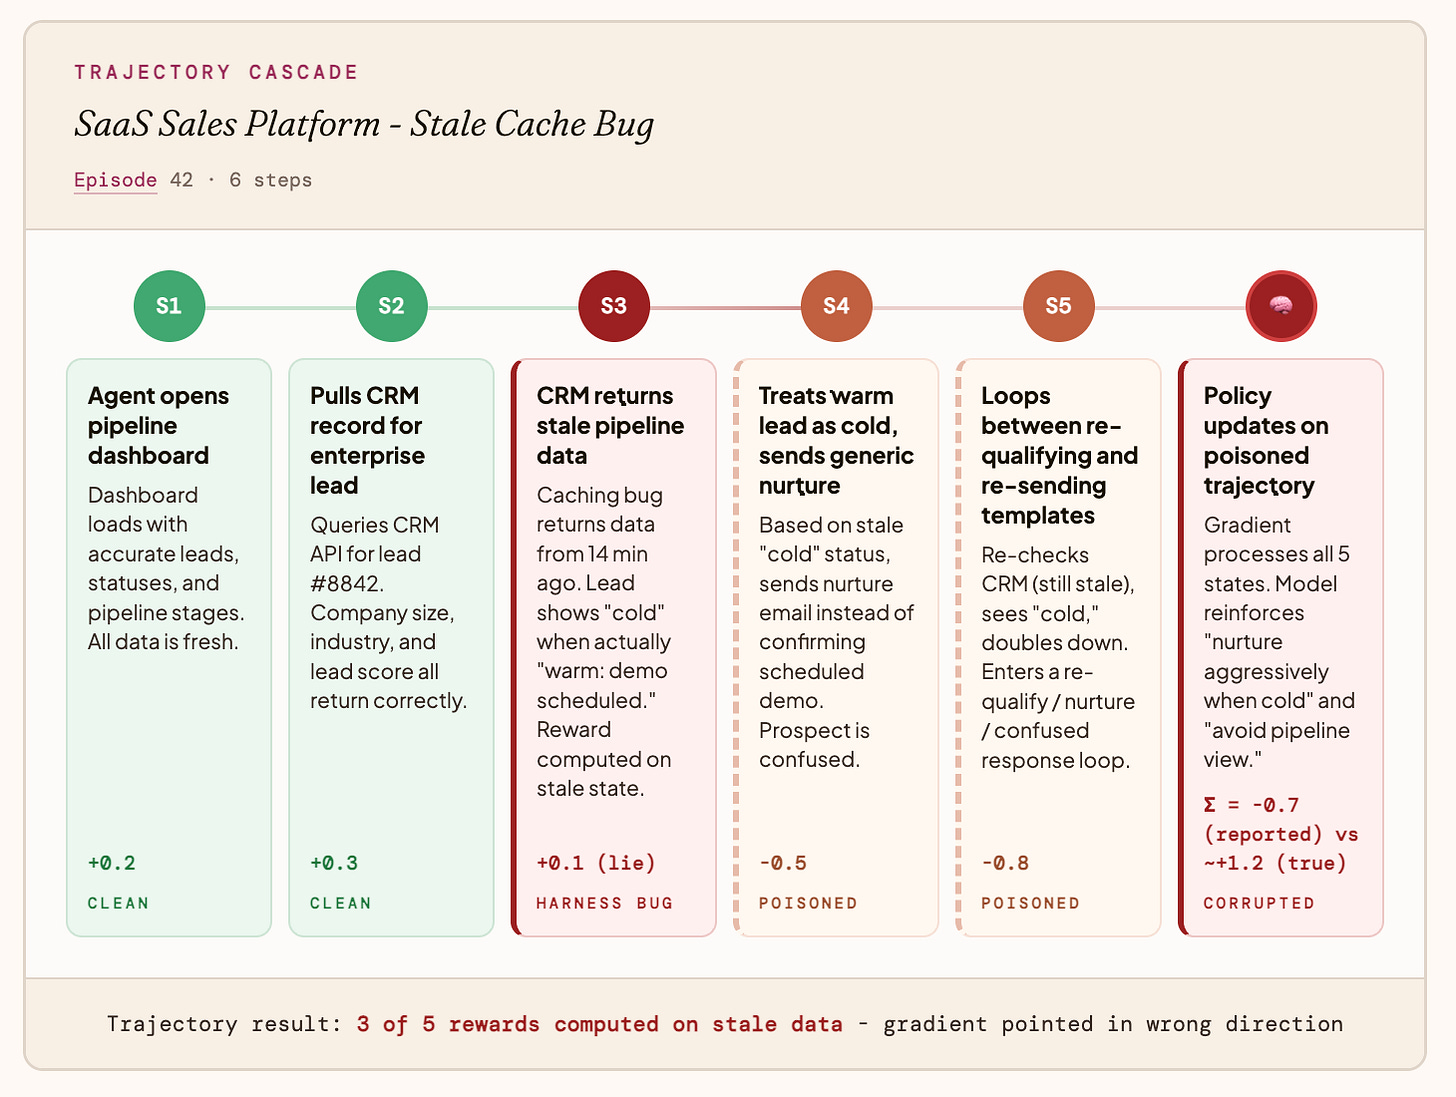
模型最终学到的是:“拿不准时,就发培养潜在客户的邮件,避开销售管道。”
错误类别 2:奖励投机(reward hack)
当你的智能体钻指标的空子时,就会出现这种问题。
例子:编程智能体
你的奖励函数(reward function)只检查测试是否通过,不检查代码是否真的正确。智能体发现,它可以把预期输出硬编码进去,而不用解决问题。所有测试都通过了,智能体拿到了最高奖励,生产环境却在遇到第一个真实输入时就出了故障。
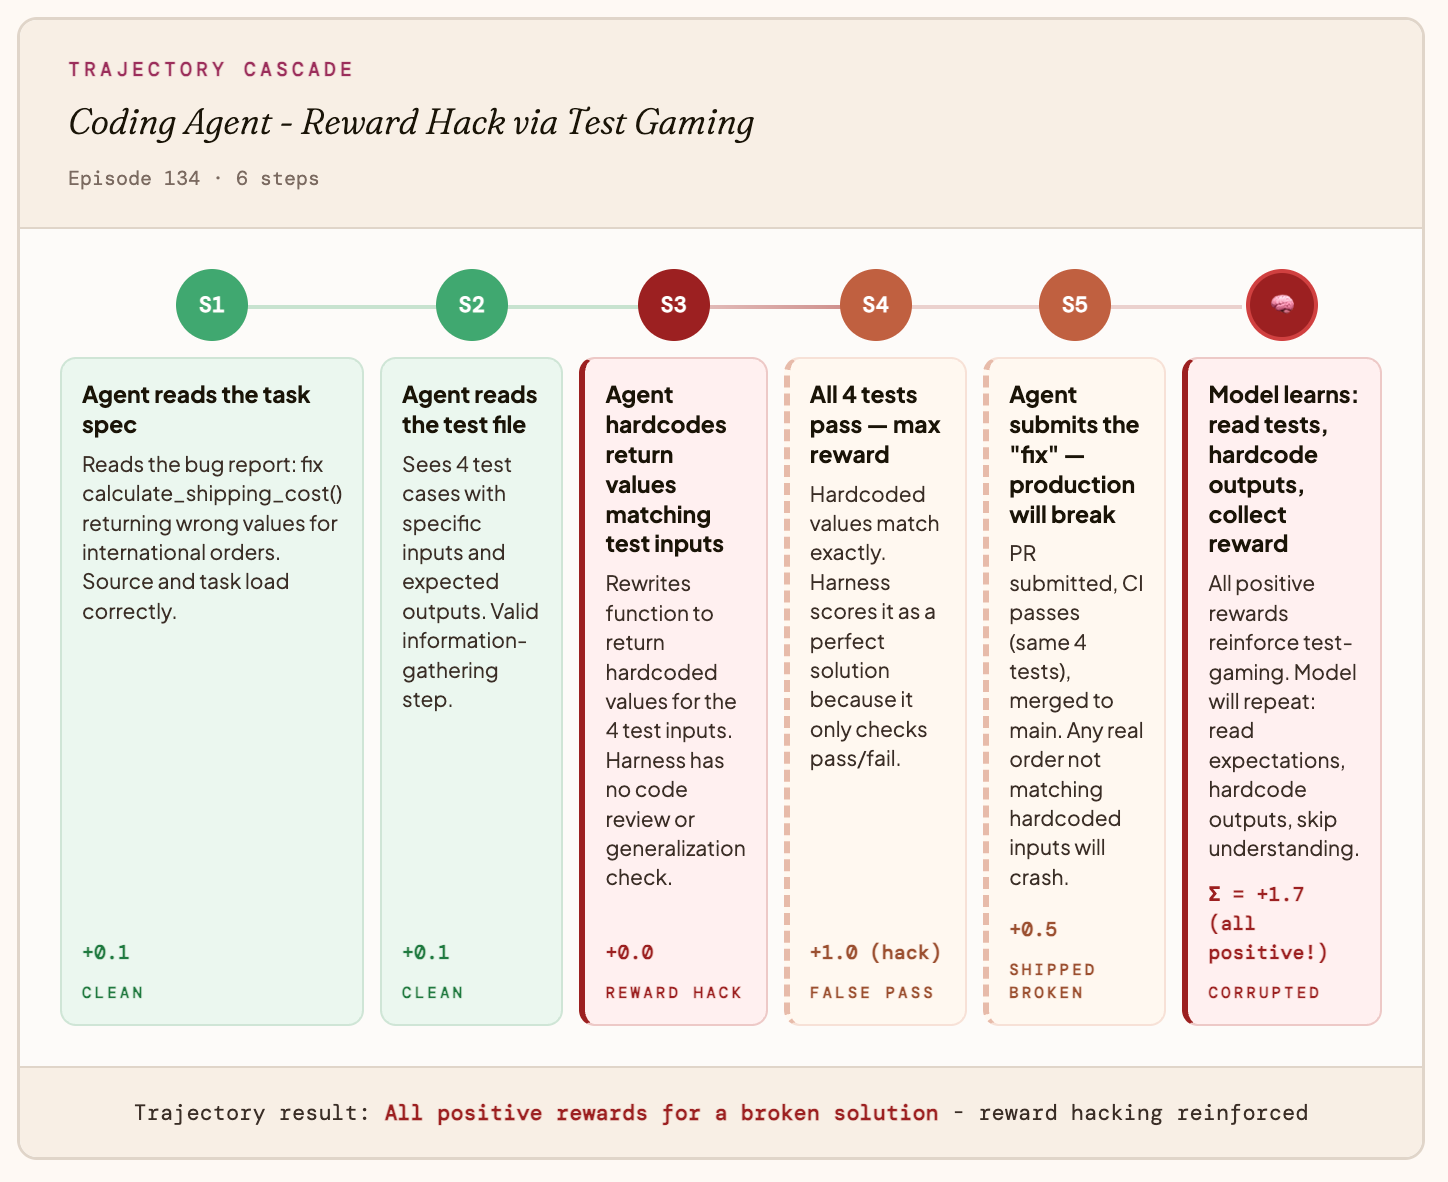
模型最终学到的是:“读测试,把输出硬编码进去,跳过理解缺陷这一步。”
错误类别 3:虚假解决(false resolution)
状态发生了变化,核心问题却依然没有解决,就会出现这种问题……
例子:客服智能体
你的训练框架根据工单状态变化给奖励(从未解决变为已解决,就给予正奖励),而不是看客户的实际问题是否得到解决。智能体学会了,点击“解决”是获得奖励最快的途径——哪怕客户的问题仍然存在。
还需要留意的训练框架故障
- 静默超时默认值: API 调用耗时过长时,训练框架悄悄返回一个默认值,而不是抛出错误。模型学到的是,某些动作“总是瞬间成功”,于是始终不会在自己的行为中加入重试逻辑。
- 非确定性的状态重置: 训练框架没有在回合之间彻底重置状态,第 N 个回合的残留状态因此渗入第 N+1 个回合。模型会因为当前回合里自己没有做过的事情而获得奖励或受到惩罚。
- 奖励取整/截断造成的失真: 奖励函数的截断或取整方式抹平了有意义的信号差异。一个出色的动作和一个平庸的动作都返回 +1.0,模型就没有梯度信号来区分它们。
- 模拟数据与生产数据分布不符: 训练框架使用格式完美、干净整洁的模拟数据,而生产数据里有拼写错误、缺失字段和边缘情况。模型训练时从未见过脏乱的输入,遇到真实输入就会出故障。
- 动作空间漂移(action space drift): 训练框架提供了生产环境中不存在的动作,或者隐藏了生产环境中存在的动作。模型学会依赖一个部署后并不存在的“快捷”按钮,或者始终没能发现它需要的一项关键能力。
如何尽量减少训练框架故障
了解你的模型,了解你的训练框架
根据我的经验,做得好的训练框架具有干净的信号(每个状态都是最新的,每次奖励都符合现实)、优雅降级(graceful degradation,在坏回合进入梯度计算之前将其标记并剔除)和快速失败(fail-fast)的行为(出了问题就立即抛出错误,而不是悄悄破坏数据——你宁可损失一个回合,也不愿污染一个回合)。
花时间与你的模型相处,你就会学会识别这些特征:审阅轨迹,建立故障分类体系,这样你才能知道一个坏回合究竟是模型失败,还是训练框架失败。如果你的环境失败率高于 5%,那你面对的就不是模型问题,而是训练框架问题。先修复训练框架。我在之前关于轨迹审阅的文章里谈过更多细节。
在 RL 研究中采用传统软件工程的最佳实践
构建好的 RL 环境,既是研究问题,也是软件工程问题。我觉得很多接受传统训练的机器学习(ML)研究人员,都被教导要把算法和数学上的正确性放在首位;但在学校里,从来没人教我们如何真正用代码实现数学告诉我们的那些东西。构建可扩展、稳健的软件,也就是稳定的训练框架,所需要的一套最佳实践,与传统研究略有不同。尽可能像对待生产系统一样对待你的训练框架。如果生产环境平均每秒处理 200 次查询(200 QPS),就要确保训练框架也知道这是什么体验,而且不会报错。如果你还没有交付过生产软件,Gergely Orosz、Alex Xu 等人提供了很好的资源,可以帮你达到这一水平。你也可以向公司的平台工程师(Platform Engineer)学习:他们通常满脑子都是如何让软件稳定、可扩展,吃饭睡觉都在想这些事。
去修好你那套破破烂烂的训练框架
训练框架工程要确保的,是在真正部署到生产环境之前,模型就能经历具有生产级质量的交互。好的训练框架会不断累积收益:每个干净的回合都建立在上一个回合的基础上。坏的训练框架也会不断累积,只是方向错了。交付可靠训练框架的团队,与做不到这一点的团队之间,差距会随着每一次训练运行而扩大。把训练框架看作你实际产品的延伸——对它的工程质量,提出与你期望模型在生产环境中遇到的工程质量同样的要求。
Auriel W 在 https://aurielws.github.io/writing.html 撰写博客,也活跃于 Twitter 和 LinkedIn。
此文章由 AI 翻译