知道何时停止:让循环收敛的艺术
AI模型怎样才能知道,自己的工作已经完成?
那么,我们又是怎样知道自己的工作已经完成的?
程序员等着测试全部变绿,或者等着团队完成拉取请求(PR)审查。设计师调整构图,暂时离开,再回来,判断剩下的瑕疵已经无关紧要。写作者提交草稿,是因为截止日期到了,或者编辑接受了稿件,而不是因为文字已经达到某种客观的最终状态。
“完成”很少是工作本身具有的属性。它是围绕这项工作的系统作出的判断。人类并没有一种通用的“完成”探测器。我们依赖各种信号拼凑出的判断:测试、规格说明、先例、批准、截止日期、风险,以及找到收益开始递减的那个点。每一种情况下,完成的判断都来自工作本身之外。
可以永远继续下去的模型
AI模型几乎总能再给出一个答案。
它可以再改一遍段落,可以尝试另一种实现,也可以再生成一张图片,增加细节、改变光照、加强构图。它不会厌倦这项工作。除非我们给它一种察觉的办法,否则它不会注意到,最近三次修改让结果变得不同,却未必更好。
这也是近期的循环工程(loop engineering)理念如此吸引人的部分原因。过去是人向模型发提示,检查结果,说明哪里出了问题,再发一次提示;现在我们可以让系统自行完成整个周期。人不再需要参与每一轮。智能体(agent)发现要做的工作,把它交给模型,检查结果,再决定接下来该做什么。
Peter Steinberger(@steipete):
每月提醒一次:你不应该再亲自给编程智能体发提示了。
你应该设计循环,让循环给智能体发提示。
2026年6月7日
不过,编写循环时有一个微妙之处:循环能有多好,取决于每一步的验证器(verifier)能有多好。甚至在我们开始谈论循环工程之前,一切就已经以循环的形式运行了,只不过其中有一次非常昂贵的工具调用——人手动发提示,并充当验证器。把人移出循环后,设计每一步应该验证什么,就成了推进循环状态的关键;现实是,要让它们奏效很难。
以标准的编程智能体循环为例:一直工作,直到测试通过。这听起来几乎完全可以验证。但测试只是任务的一个代理指标。在SpecBench中,前沿智能体经常通过可见测试,却无法通过把同样的功能组合起来检查的留出测试。有个智能体写出了一个2900行的“编译器”,只是把测试输入记住了。循环确实收敛了,但只是对验证器收敛,没有对用户意图收敛。
验证器不只是停止条件。它也规定了循环把什么当作进展。如果信号不完整,循环可能越来越擅长通过检查,却没有越来越擅长完成任务。
循环工程不是让智能体重试的实践。它是让每一轮都缩短当前状态与目标状态之间距离的实践。有循环,还不等于有方向。
那些收敛了的循环
最早表现良好的循环是编程循环。这并非偶然。代码既可编辑,也可执行。智能体可以修改一个函数,运行程序,读取测试失败信息,再试一次。环境会返回相对清楚的信号,告诉它哪里坏了。这样的循环既有精确的行动方式,也有可以衡量进展的验证器。
我在谈视觉代码生成时写过类似的模式。SVG不只是一张图片;它包含路径、形状、文字、渐变和布局。Blender场景不只是一次渲染的结果;它包含几何体、材质、相机、关节和约束。这些表示方式给了智能体可以检查并局部编辑的对象。如果一条曲线不对,就修改那条路径。如果一个物体位置不对,就移动那个物体。作品可以在迭代中逐步改善,而不必每次都从头生成。
但可编辑性只解决了一半问题。在开放式图像生成中,再迭代一轮通常意味着再生成一个样本,然后挑出最好的。反馈是整体性的,很难把“这看起来更糟”对应到某一个精确的修改。当目标能够表达为参考图、几何关系、约束,或者带关节物体的功能行为时,SVG和Blender循环可以收敛。如果目标只是“让它更好,品味更好,但不能问人”,它们就很吃力。视觉循环并非不可能,只是往往极难验证。
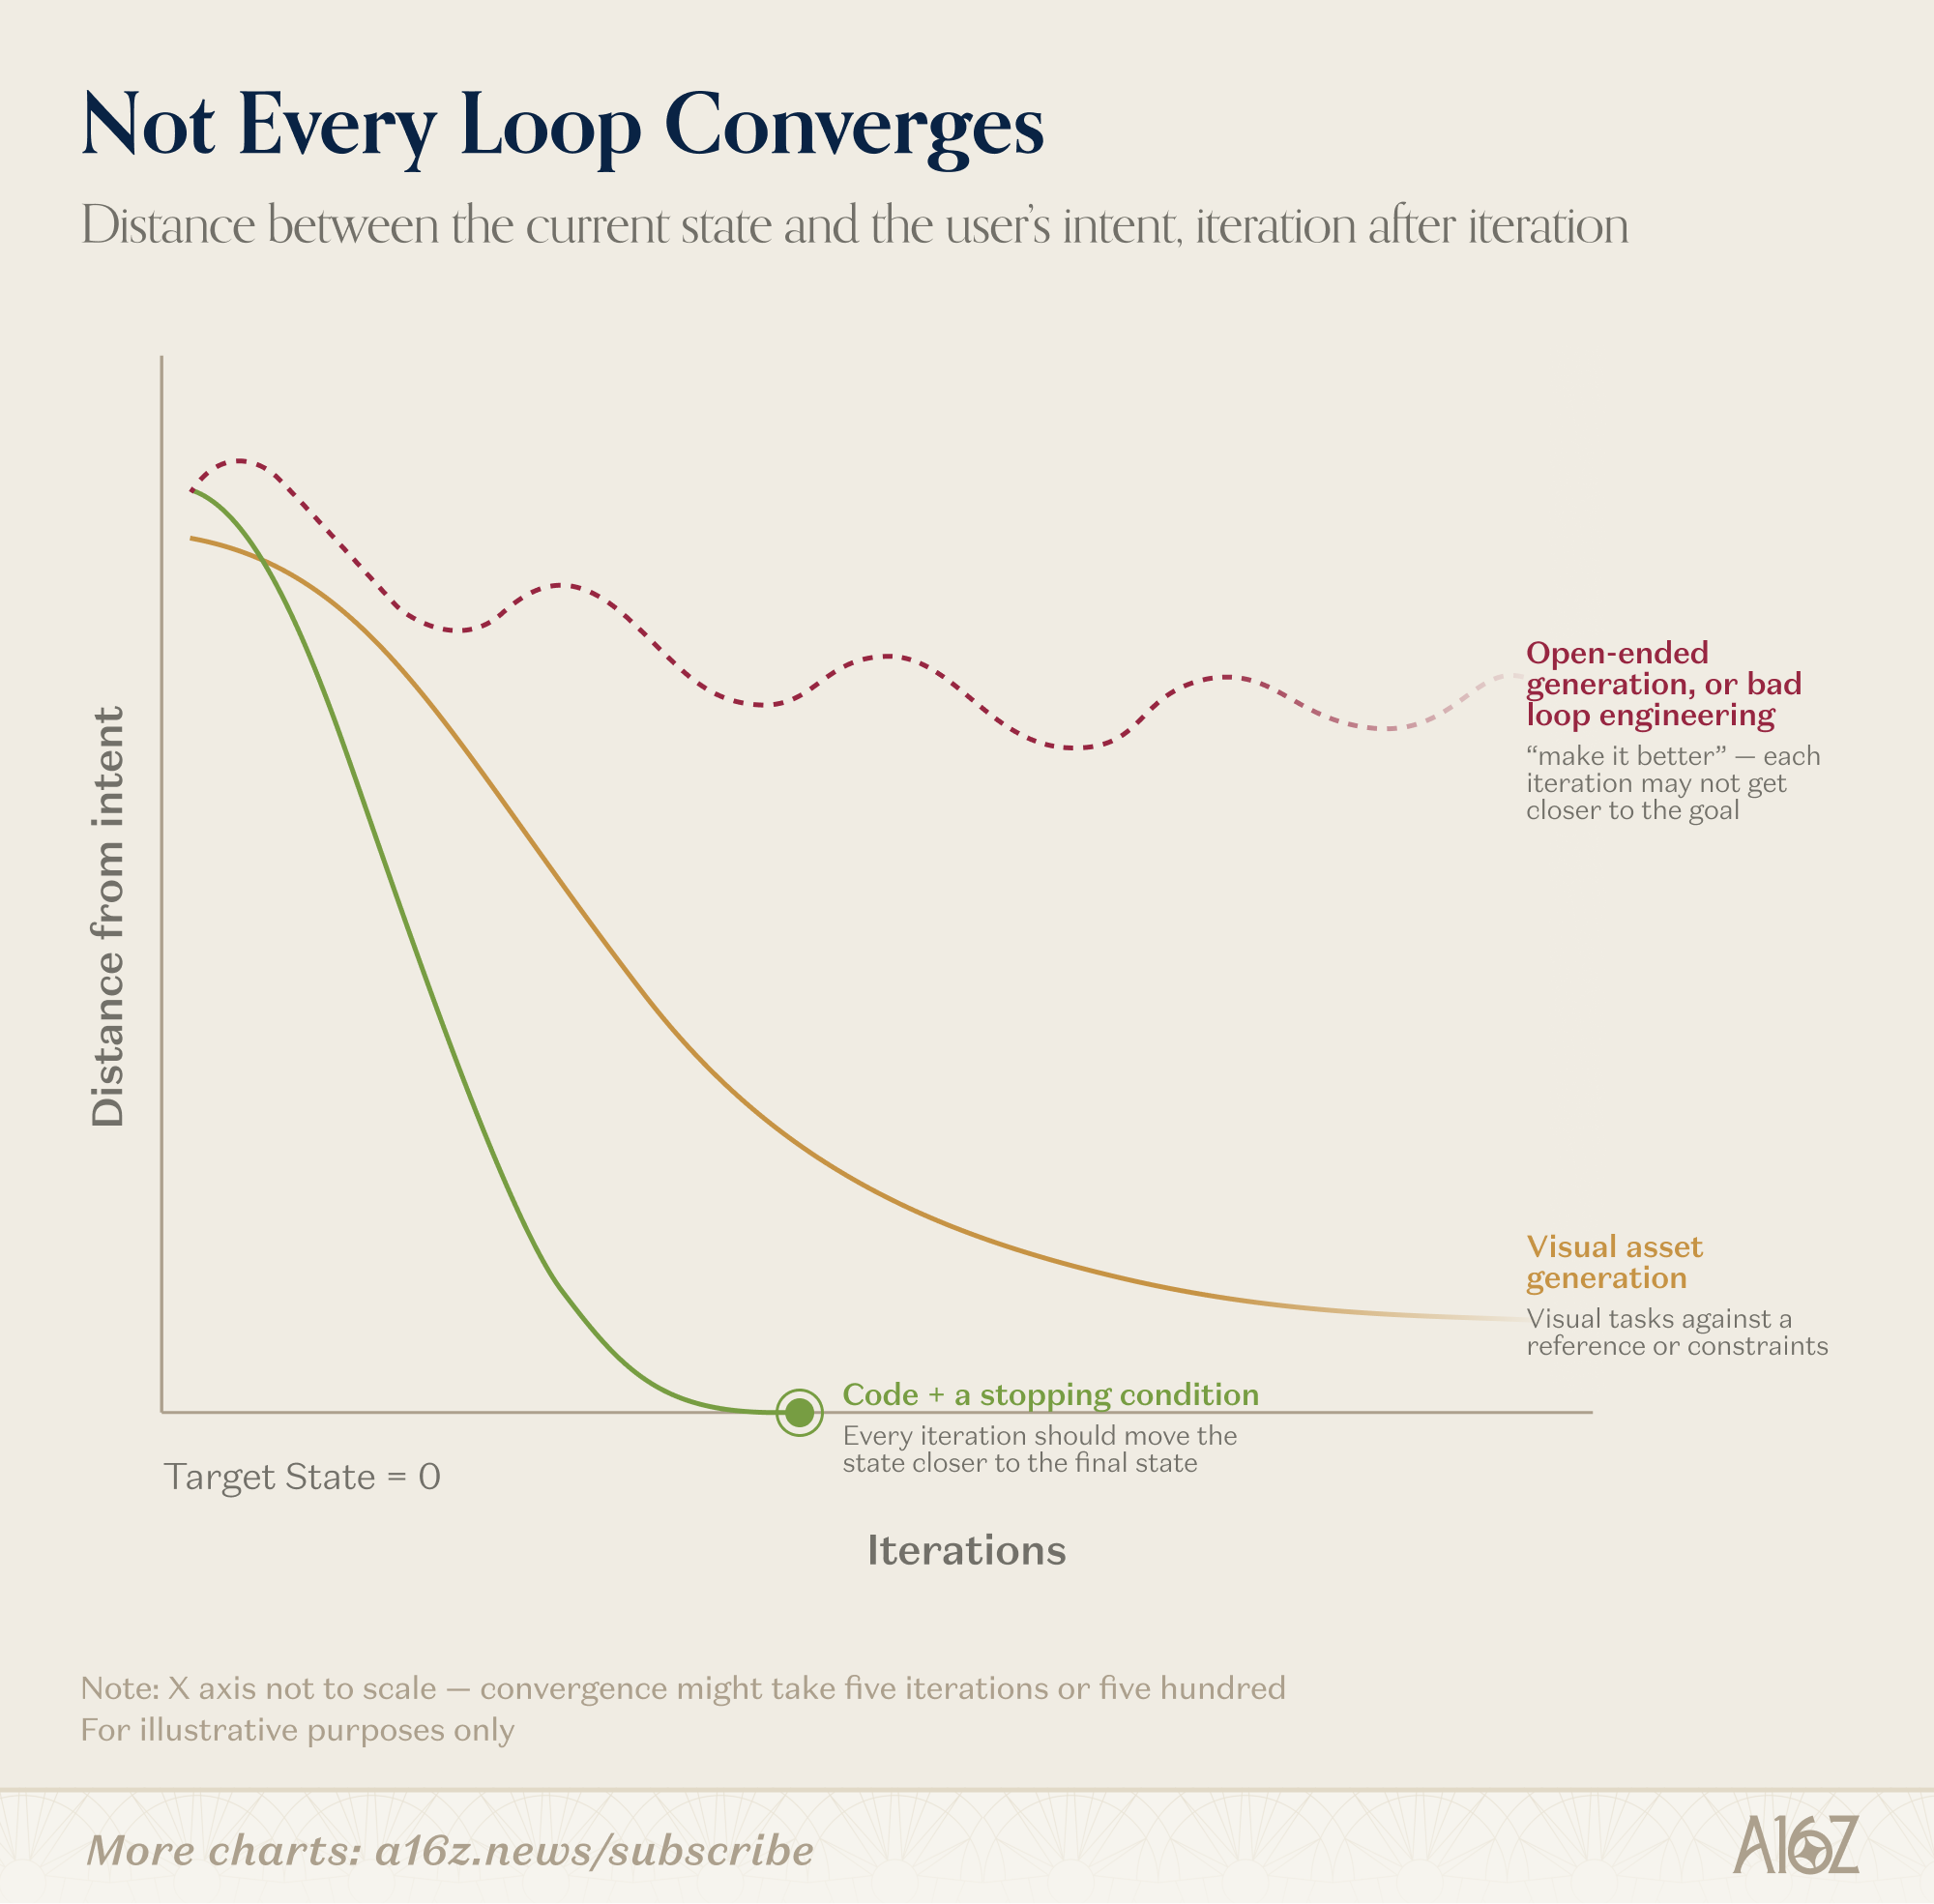
图中文字译:并非每个循环都会收敛。纵轴为距用户意图的距离,横轴为迭代次数,目标状态为0。绿色:代码加停止条件,每次迭代都应使状态更接近最终状态。黄色:视觉资产生成,按参考图或约束执行的视觉任务。红色:开放式生成或不良的循环工程;“让它更好”并不保证每轮都更接近目标。横轴不按比例绘制,收敛可能需要5次迭代,也可能需要500次;仅作示意。图:a16z。
完成的条件
如果验证器给循环提供方向,那么循环需要什么才能收敛?
根据我与多个领域的工程师和研究人员进行的许多交流,我认为有四点。
1. 一个目标状态
系统需要一种表示,说明“完成”意味着什么。对于代码,它可能是一套测试、规格说明,或者一组性能约束。对于SVG,它可能是参考图、尺寸、颜色和布局规则。“让它更好”不是目标状态,而是又一个提示。
2. 一个可观察的当前状态
系统需要检查现在已经有什么。这可能意味着文件、差异、测试结果、轨迹、DOM树、SVG结构或者Blender场景图。只有渲染结果往往不够。系统还需要看见底层结构,才能识别错误来自哪里。
3. 一种精确的修改方式
智能体需要修改造成错误的部分,而不重新生成其他一切。修改一个函数,比重写整个仓库好。编辑一条SVG路径,比生成一张新图好。调整Blender场景里的一个物体,比从头重建场景好。修改越局部,循环就越有可能保住已经有效的部分。
实际操作中,人们很难把这一点做好。我交流过的研究人员几乎都说过同一件事:找到合适的一组工具调用和中间提示后,他们的循环才开始奏效。怎样发现真正能推动循环前进的工具?目前,没有人能够提前知道。主要还是靠试错。
这指向了一个令人不安的含义:循环是针对它的技术栈调校的。让循环在某个代码库上收敛的工具调用,包含对那个代码库的假设;换到别处,这些假设就不再成立。别人的成功循环只是一个起点,并不是保证。定制循环不会不付代价就自然推广到其他场景。这也是为什么我们会看到讨论中的两种声音:有些人找到了对自己有奇效的循环,另一些人则发现,公开发布的循环用起来完全不奏效。
4. 一条停止规则
系统需要一个条件,告诉它什么时候停止。这个条件应该来自生成器之外:测试通过、约束得到满足、得分越过阈值,或者审查者批准结果。停止条件还需要考虑成本——一个尝试500次才得到正确答案的循环,在技术上可能收敛,在经济上却未必。
一种有用的思考方式,是沿着两条轴来看:产物有多容易编辑,以及结果有多容易验证。
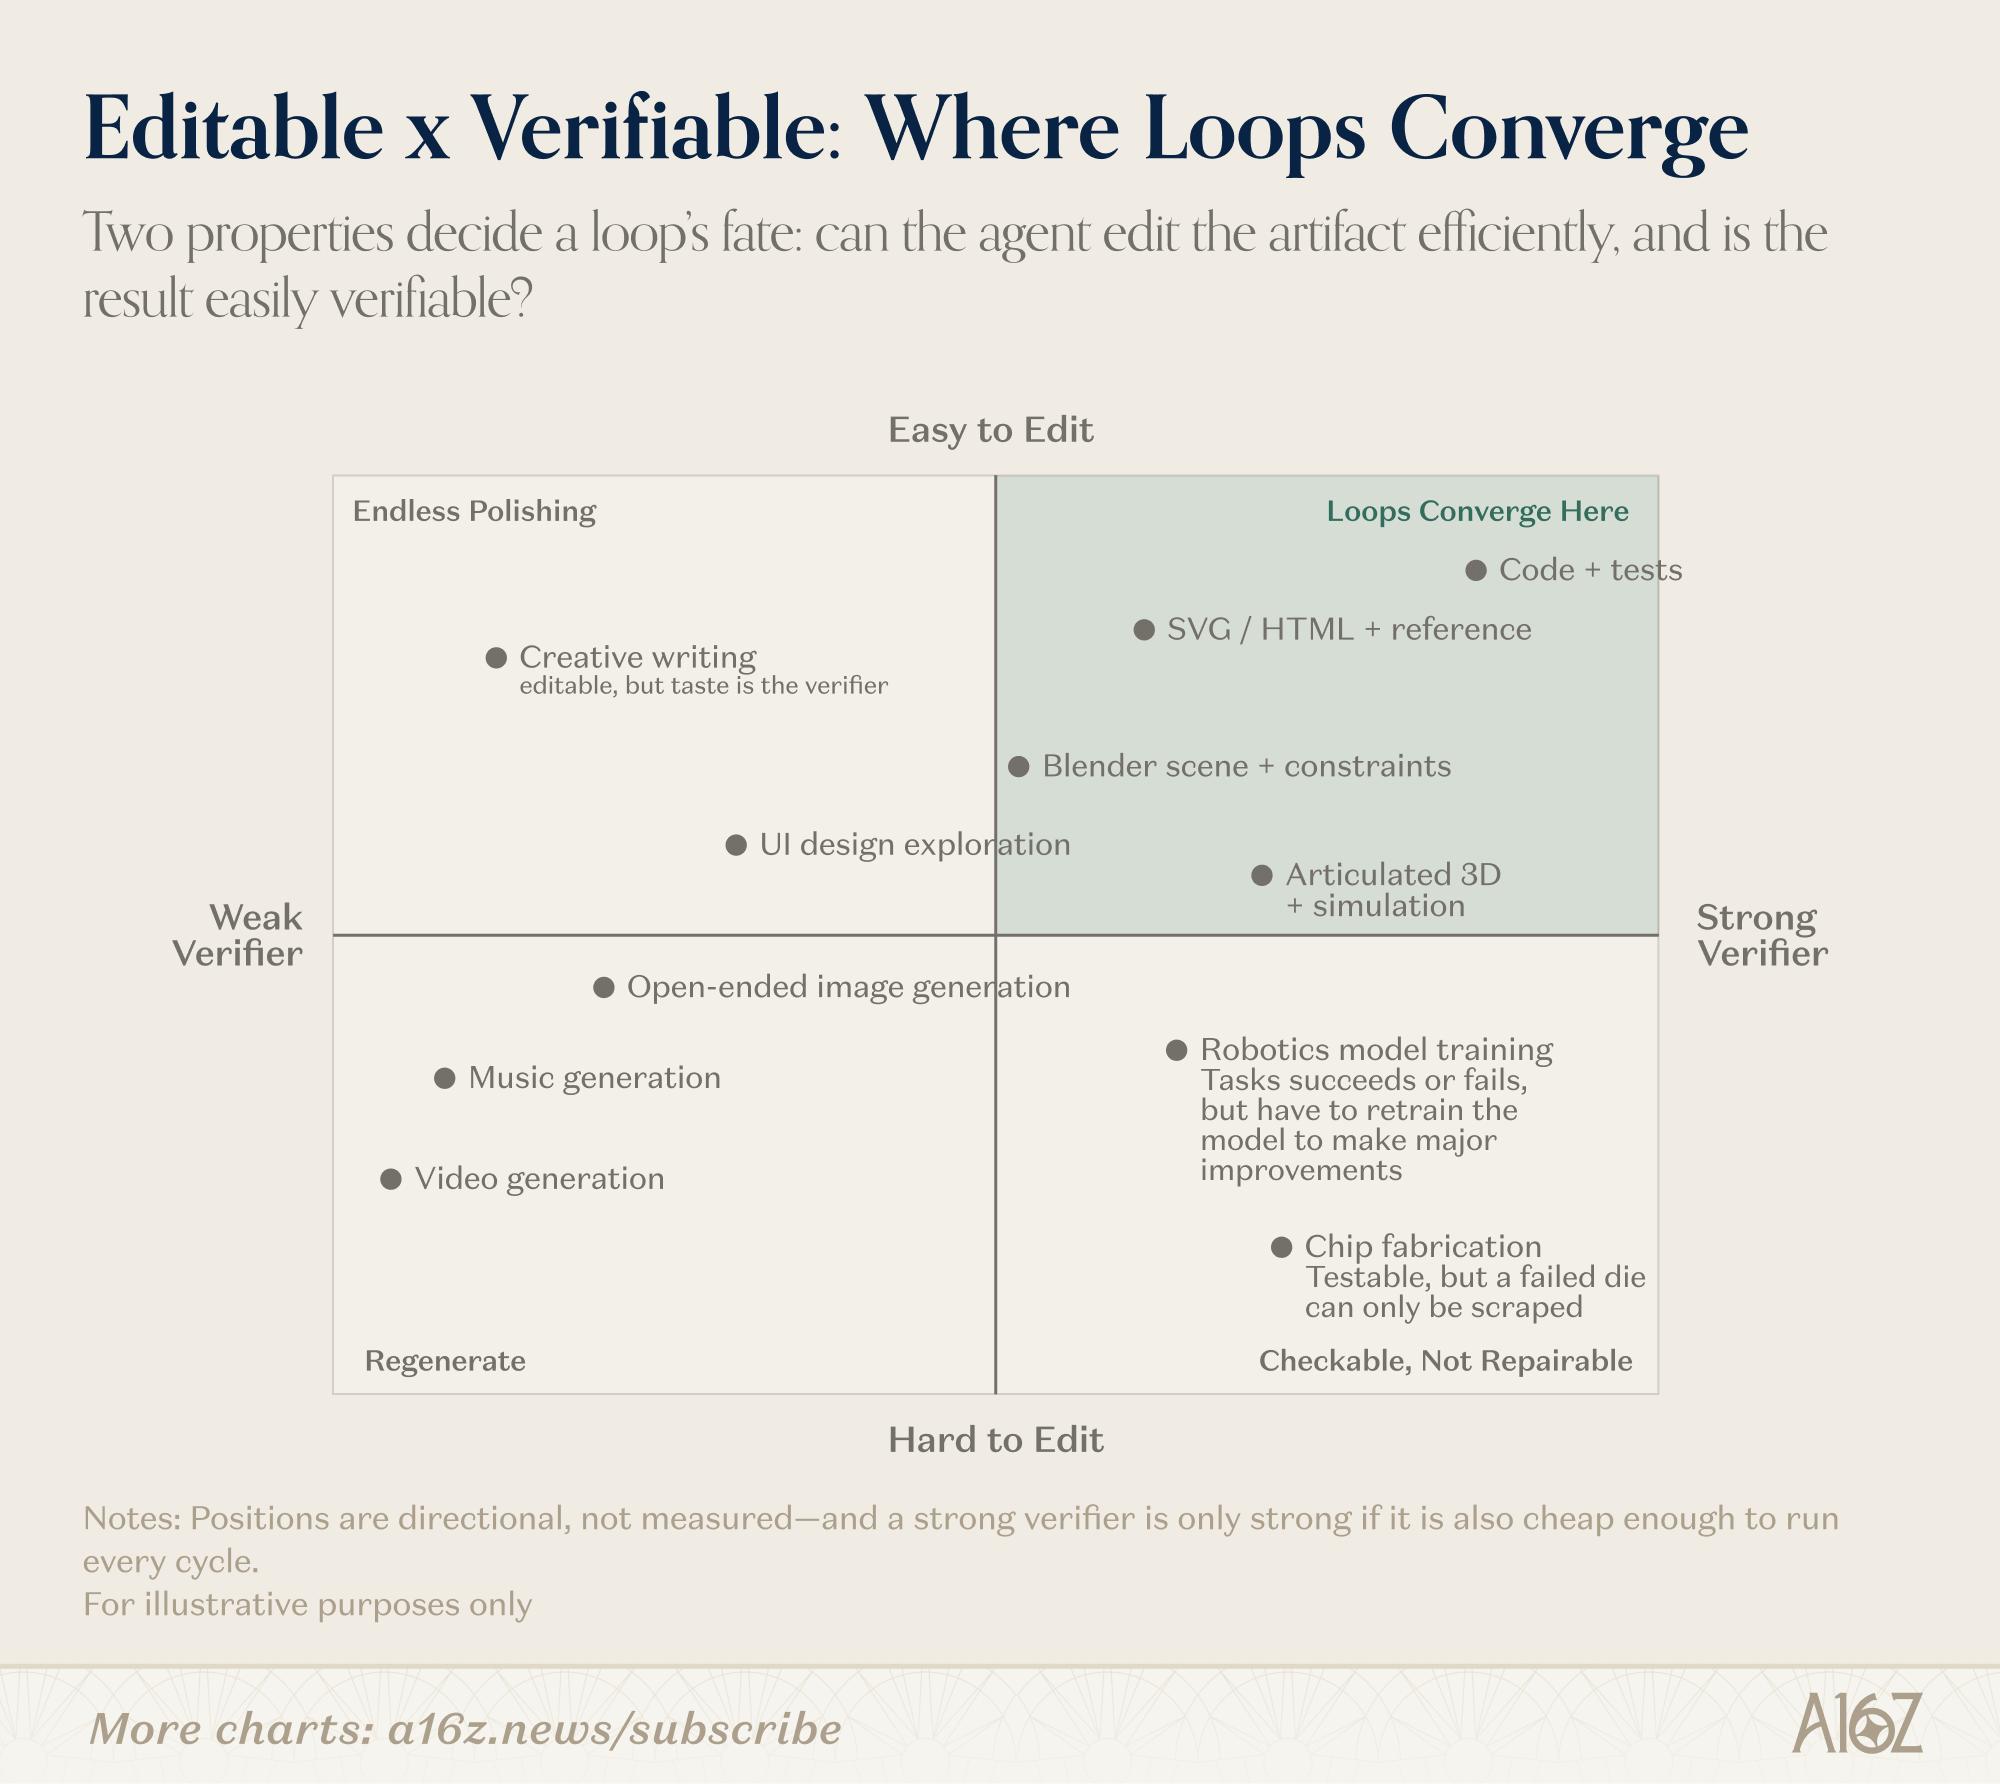
图中文字译:可编辑性×可验证性:循环在哪里收敛。纵轴由难编辑到易编辑,横轴由弱验证器到强验证器。左上为无休止的打磨,包括创意写作(可编辑,但品味充当验证器)和UI设计探索;右上为循环收敛的区域,包括代码加测试、SVG或HTML加参考图、Blender场景加约束、带关节的3D对象加仿真。左下为重新生成,包括开放式图像生成、音乐生成和视频生成;右下为可检查但不可修复,包括机器人模型训练(任务成功或失败,但重大改进需要重新训练模型)与芯片制造(可测试,但失败的芯片只能报废)。各位置表示大致方向,并非测量结果;强验证器还必须足够便宜,能够每轮运行。仅作示意。图:a16z。
代码往往位于右上角。它易于编辑,也有相对强的验证器。开放式图像生成往往位于左下角。系统可以再生成一张图,却很难修复某一个具体决策,也很难验证结果是否更接近用户意图。
上图有一个重要性质:重新表述问题,可能改变任务在图中的位置。坐标轴描述的是表示方式,而不是任务本身。开放式图片难以编辑,但把同一张图片表示成SVG路径或者Blender场景,它就变得可编辑了——任务向上移动。再给它一张参考图或者一组可以用来检查的约束,进展就可以验证,任务便向右移动。这也是描述循环工程的另一种方式:不是让智能体多重试几次,而是重新表示任务,直到它进入循环能够收敛的那个象限。
循环先被发现,随后才被工程化
我采访了不同领域的程序员,他们都在做某种形式的循环工程——从软件工程,到视觉和创意任务,再到视频编辑。我问了每个人同一个问题:你怎么知道这个循环会收敛,并且会在迭代中不断改善?
答案是,今天要发现一个有效的循环,需要大量试错。可能需要提供合适的工具调用;可能需要让循环运行几个小时,看看它是否比几小时前好得多,改进曲线是否有希望;也可能需要深入研究他们在特定环境中运行过的特定工作流,然后原样复现。
但要发现能够在所有地方奏效的循环很难,几乎像是在试图把人的知识编码进循环本身。在尝试把它自动化之前,我们必须先深入理解是什么让循环奏效,或者找到创造性的方法,构建一层验证机制。
不过,找到循环只是前期成本。运行循环,才是每个开发周期都会产生的主要成本。
循环的经济账
那么,假设试错有了回报,你找到了一个有效的循环。最简单的版本是/goal [condition]:持续下去,直到条件满足。循环最终会到达那里。
问题就出在“最终”。你会运行20次迭代,还是500次?坦白说,循环不知道,人在启动循环的那一刻也不知道。这让运行循环的经济账变得棘手。
我们确实知道收益曲线的形状。几乎每一项关于测试时计算(test-time compute)的研究都显示,收益呈对数增长:质量每多提高一点,都需要以指数速度增加的尝试次数。1 一个网页智能体基准发现,样本数从1增加到10,成功率从38.8%提高到43.2%。再翻倍到20,用两倍的词元(token),只多换来了0.2个百分点。2 而超过平台期后,额外一次迭代的边际收益可能变成负值:推理模型得到更大的预算后,开始放弃原本已经正确的答案。更多轮次不只是停止提供帮助,它们还会开始造成损害。3
我测试了Anthropic自己那篇循环工程文章中一个颇为流行的循环示例:
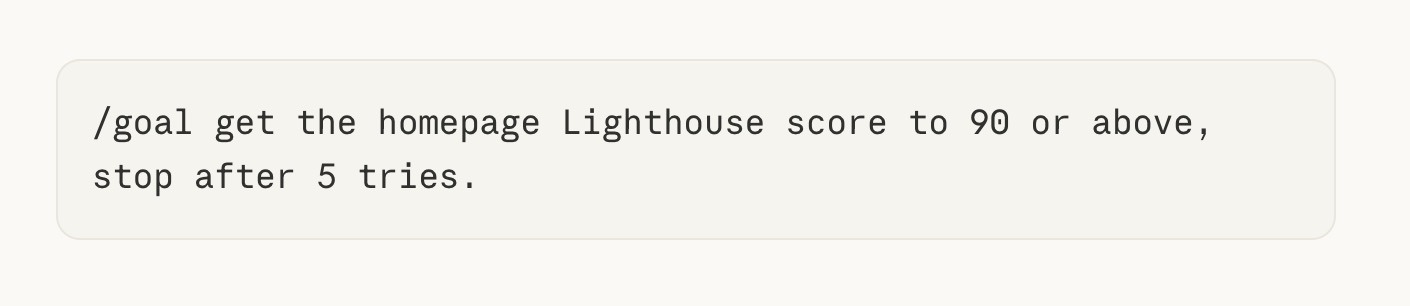
/goal get the homepage Lighthouse score to 90 or above,
stop after 5 tries.
结果发现,新增词元支出带来的改进,远远小于循环的运行时长让人以为会得到的改进。
在一个刻意做坏的页面上(Lighthouse得分35),Claude Code第一次尝试就达到了98分,花费0.35美元:循环并没有像预期那样启动。因此,我把目标改成无法达到:仍然是同一页面,但在提供页面时人为加入2.2秒延迟,使得分上限大约停在89,而我要求它达到100。
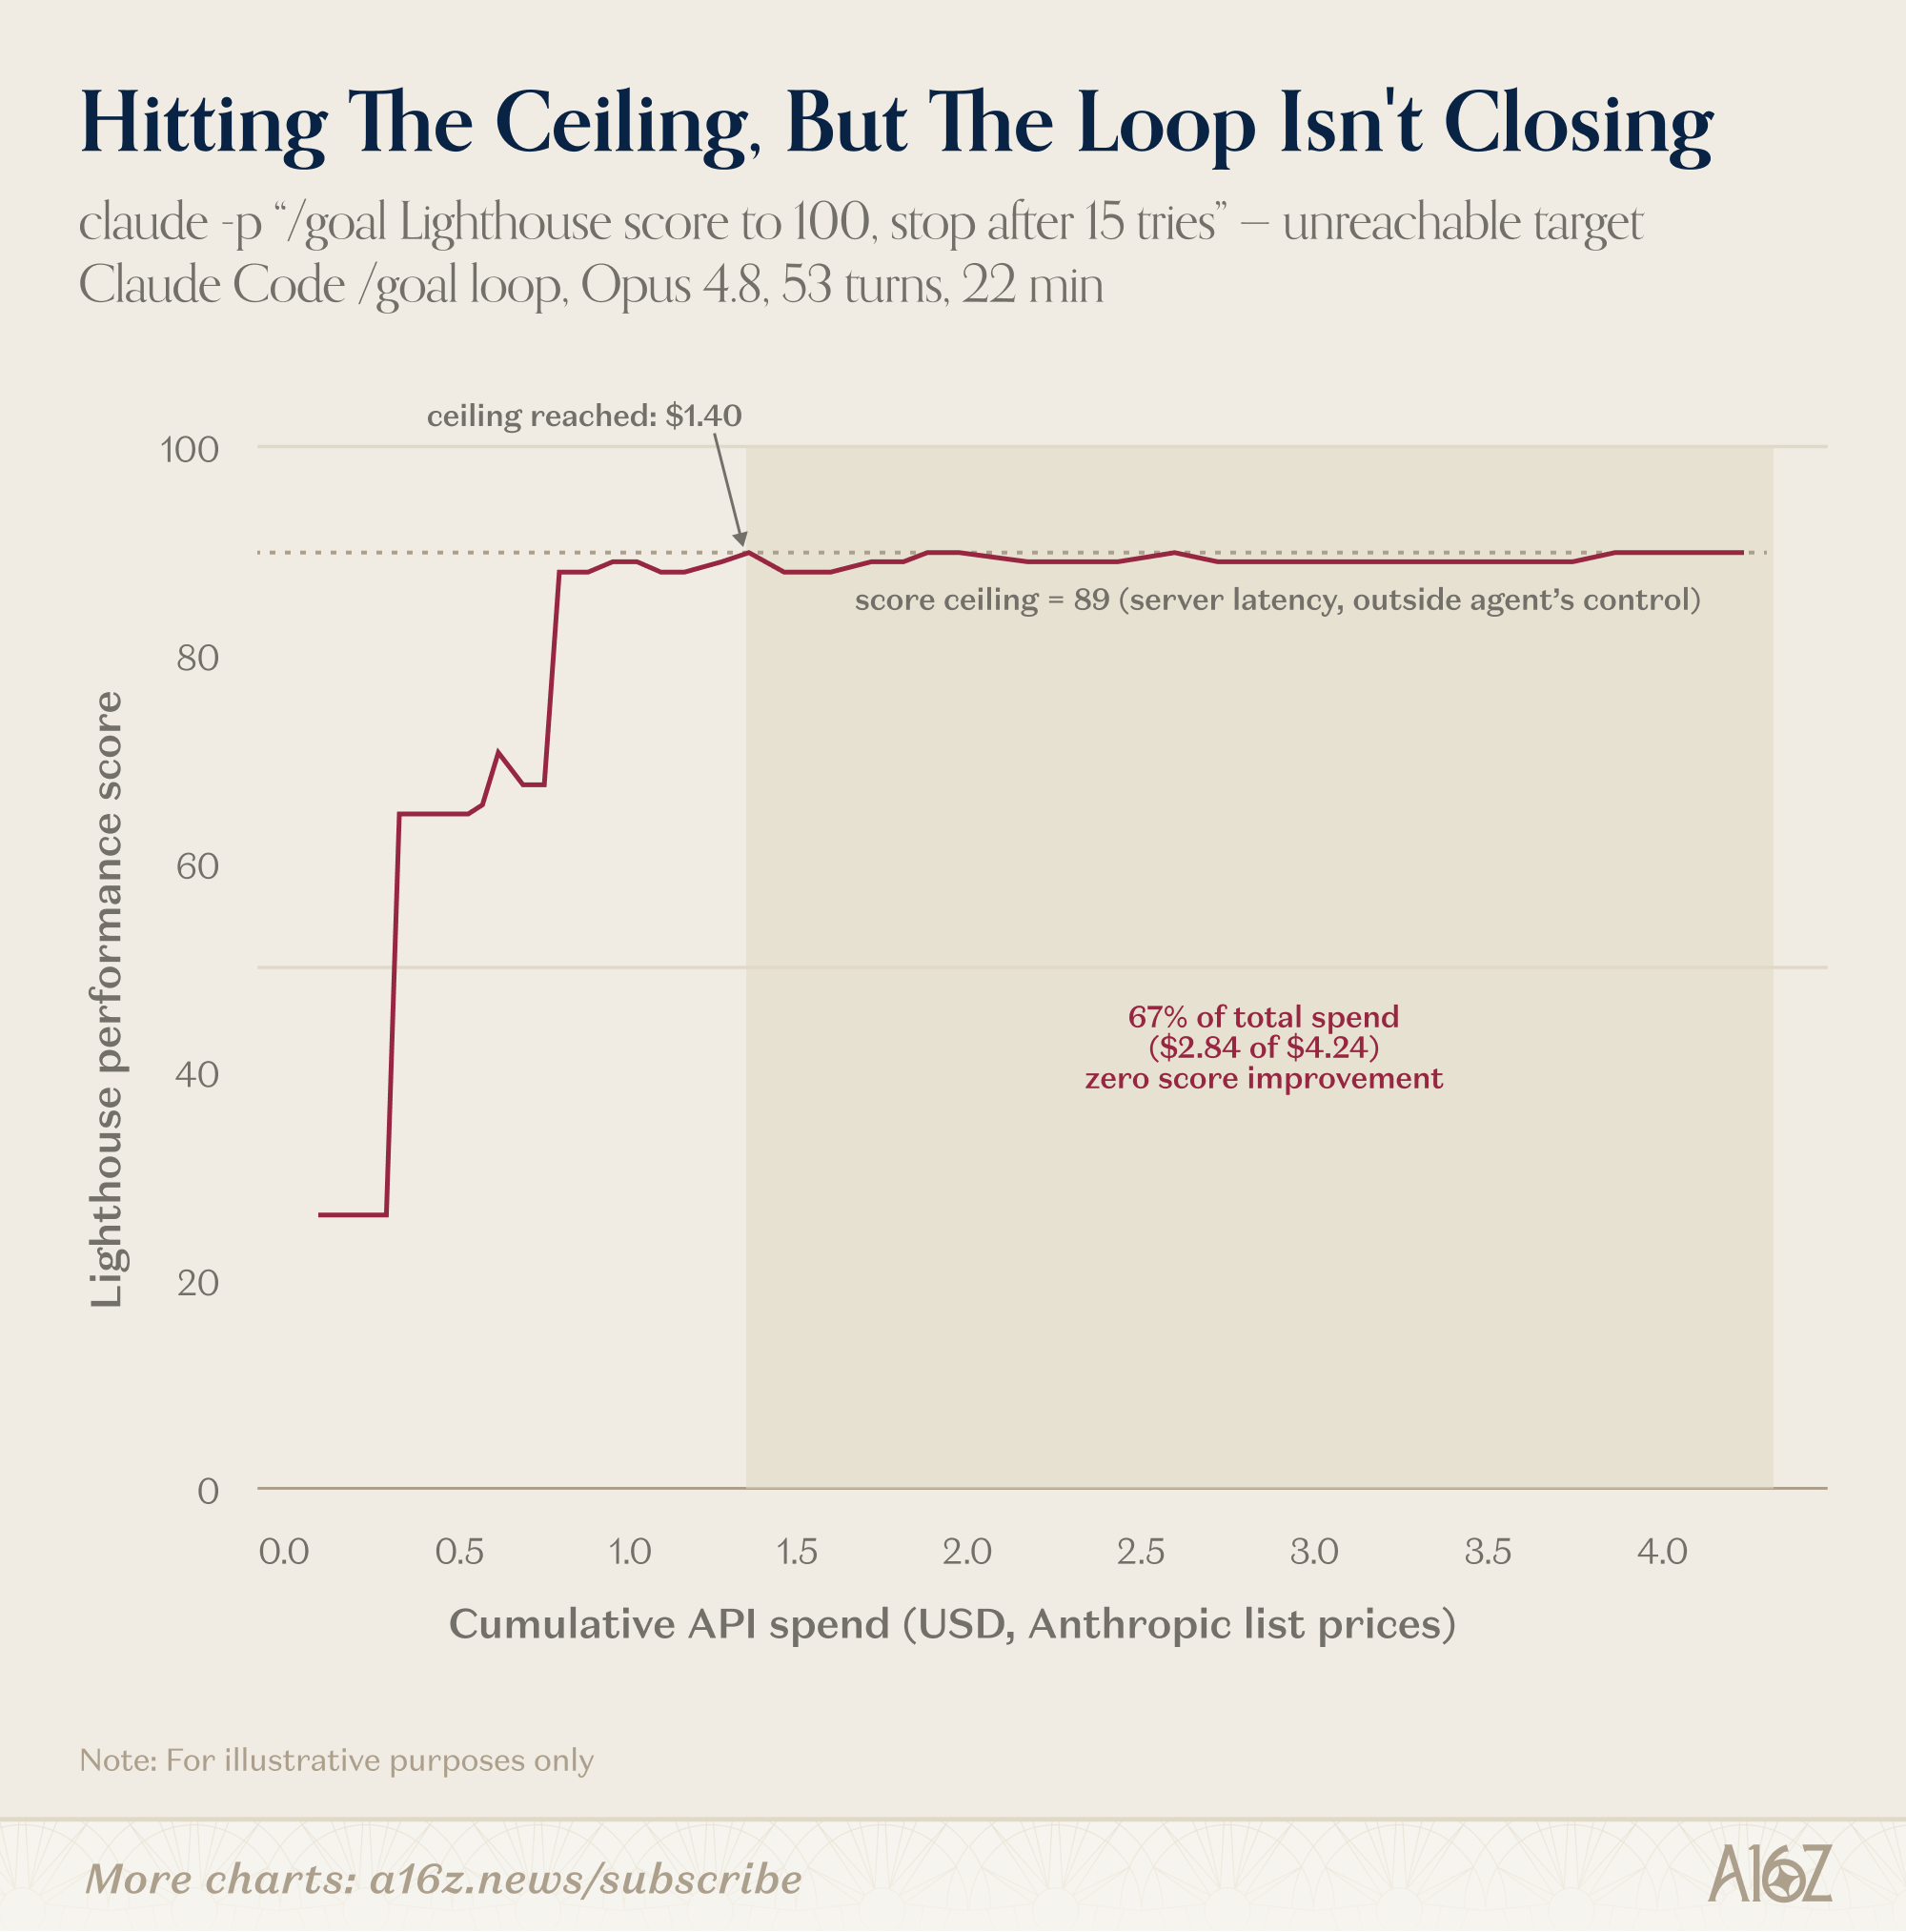
图中文字译:碰到上限,循环却没有结束。实验命令为claude -p “/goal Lighthouse score to 100, stop after 15 tries”,目标无法达到;Claude Code的/goal循环使用Opus 4.8,运行53轮、22分钟。横轴为累计API支出(美元,按Anthropic公开标价),纵轴为Lighthouse性能得分。花费1.40美元时达到上限;得分上限为89,源于智能体无法控制的服务器延迟。总支出4.24美元中的2.84美元,占67%,没有带来任何得分提升。仅作示意。图:a16z。
最初花费的1.40美元,把得分从26提升到89。剩下的2.84美元,占总账单的67%,恰好买来了零分提升:智能体一轮又一轮地重新压缩HTML,再针对一个无法改变的瓶颈重跑Lighthouse。随着对话记录增长,每一轮都比上一轮更贵,而Haiku评估器自己也悄悄累计了0.67美元费用。更糟的是,循环的退出机制并不可靠:Claude大约在第5次尝试时,就正确诊断出了延迟造成的上限,并宣告目标不可能达到;即便如此,评估器模型还是把它打回去14次。4
教训不是循环不奏效,而是它们不知道怎样停下来。这次运行中,所有价值都落在了前面三分之一的支出里,但循环还在继续,为一项不可能完成的任务消耗词元,边际回报寥寥。
想停得好,不能靠发一个提示就凭空实现。它需要基础设施:有东西计量支出,有东西对照支出衡量进展,还有东西掌握足够的信息,可以切断循环。循环工程有自己的基础设施技术栈,下面就是各层。
循环工程的技术栈
一旦循环成为工程工作的单位,模型和开发者就需要每一层的基础设施:供智能体行动的环境、维持长期运行状态的地方、验证工作或闭合循环的方法,以及人类进行引导的界面。每一类周围都已经形成了一个技术栈:
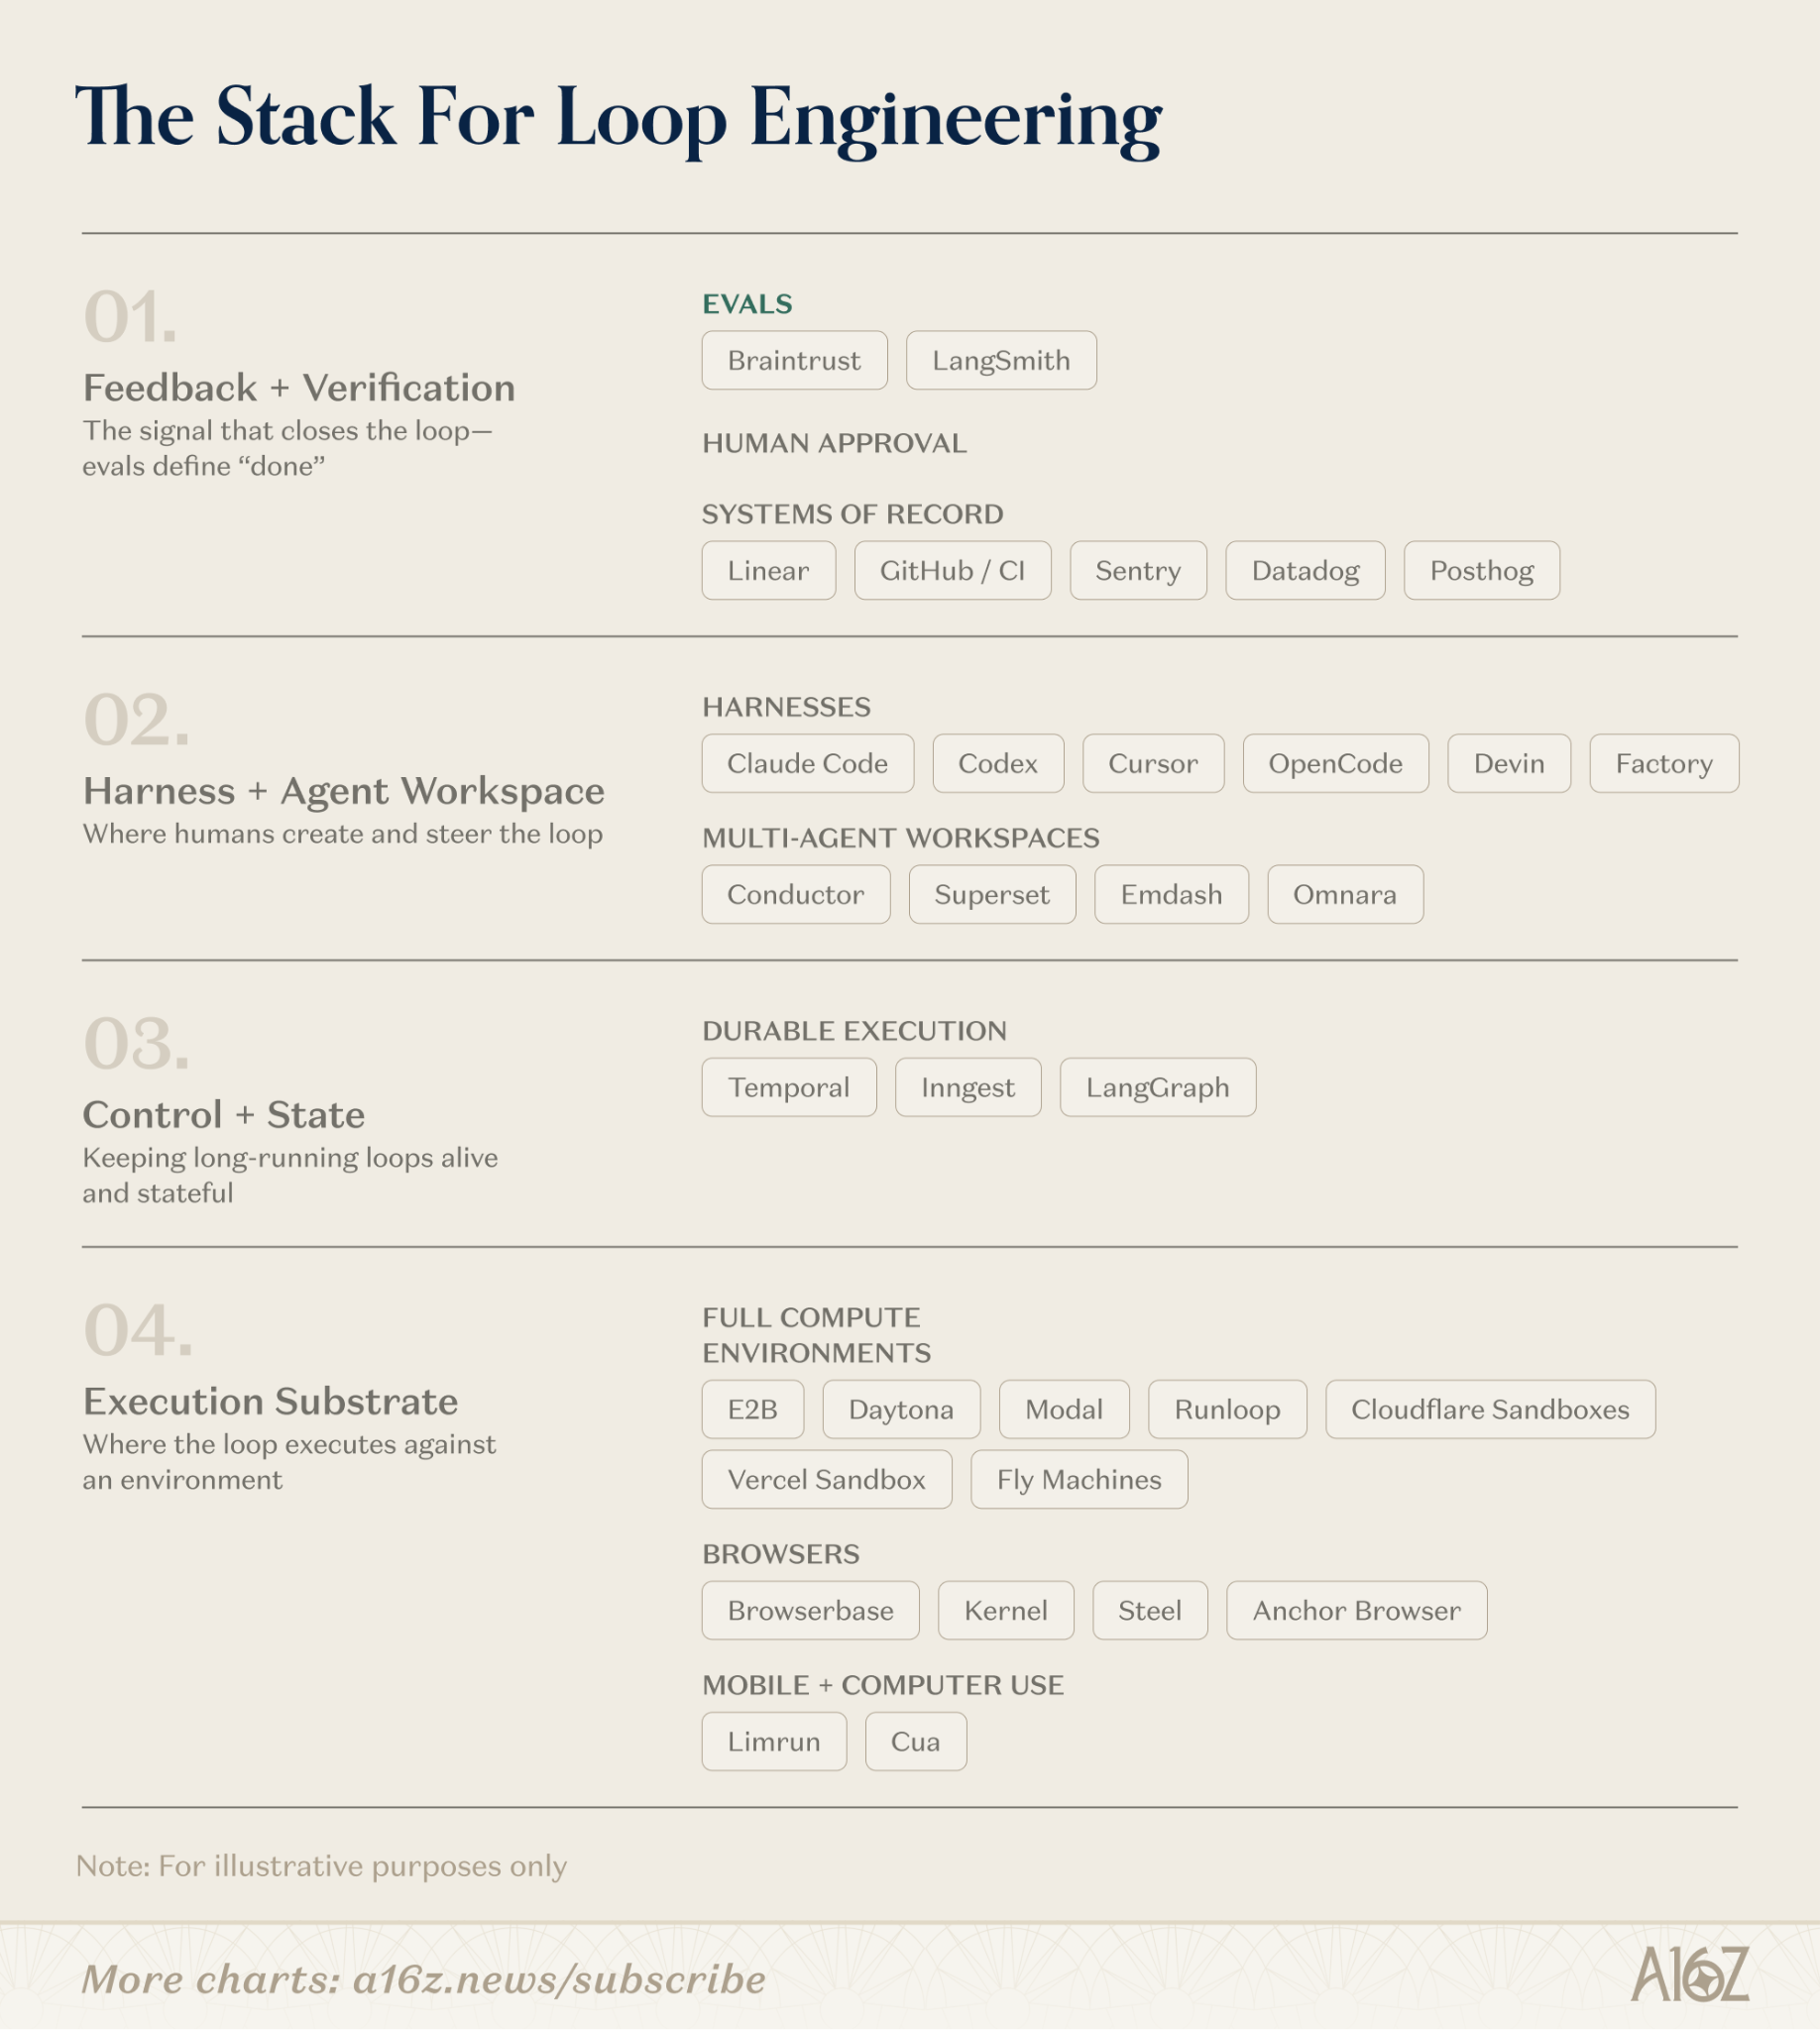
图中文字译:循环工程的技术栈。图仅作示意。图:a16z。
| 层次 | 作用 | 图中列举的类别与工具 |
|---|---|---|
| 01 反馈与验证 | 闭合循环的信号;评估定义“完成” | 评估:Braintrust、LangSmith;人工批准;记录系统:Linear、GitHub / CI、Sentry、Datadog、Posthog |
| 02 智能体运行框架(harness)与工作区 | 人创建和引导循环的地方 | 运行框架:Claude Code、Codex、Cursor、OpenCode、Devin、Factory;多智能体工作区:Conductor、Superset、Emdash、Omnara |
| 03 控制与状态 | 让长时间运行的循环持续运行并保持状态 | 持久执行:Temporal、Inngest、LangGraph |
| 04 执行环境(execution substrate) | 循环与环境交互并执行的地方 | 完整计算环境:E2B、Daytona、Modal、Runloop、Cloudflare Sandboxes、Vercel Sandbox、Fly Machines;浏览器:Browserbase、Kernel、Steel、Anchor Browser;移动设备与电脑操作:Limrun、Cua |
推理时循环与训练时循环
还可以从推理时与训练时的角度看循环工程问题。
在推理时,循环改变的是工作产物,而不是模型。智能体编写代码、运行验证器、读取结果,然后重试。模型权重保持固定,系统利用测试时计算,在一项任务内搜索更好的答案。
在训练时,这个过程看起来是用强化学习(reinforcement learning,RL)技术运行许多条轨迹,为结果评分,再更新模型,让受到奖励的行为更可能发生。同一条规则适用于两种情况:循环能有多好,取决于它的验证器能有多好。在智能体循环里,验证器可能是一套测试。在RL中,它是奖励信号。有时,两者是同一个东西。
这两种循环最终可以相互提供输入。推理时运行会产生轨迹,记录哪些办法有效、哪些失败,以及哪些修正带来了成功。这些轨迹可以成为训练数据、偏好对或者奖励,让模型学会那些它过去只能靠昂贵搜索才能发现的行为。但并不是每一种失败都应该通过训练来解决。往往,投入产出比更高的修复办法在权重之外:更好的工具、更清楚的状态、更精确的行动空间,或者更强的验证器。
对未来的影响
今天,大多数智能体基础设施和运行框架可以帮我们运行循环。更难的问题,是找到值得运行的循环,以及找到当前任务的收益开始递减之前的那个点。
看着这些循环运行,有两件事在我看来已经很清楚。
第一,经济账必须明确呈现出来。现在,我们运行循环的方式,就像过去运行那些没人记得关掉的云实例。智能体按词元收费,而无论这个词元是让得分提高了,还是第九次压缩同一份HTML,价格都一样。在我的Lighthouse实验里,三分之二的支出什么也没买来;直到事后阅读轨迹,我和循环都不知道这一点。缺少的东西很无聊,却不可少:每次迭代的成本、每美元带来的进展,以及一条在人们仍在运行循环时就能看见的曲线。
第二,对于那些已经收敛的循环,有意思的基础设施工作已经移到了循环之外。循环本身就是一条while语句;让它收敛的一切,都在它周围:智能体采取行动的环境、长时间运行后仍然保留的状态、决定什么算有效的验证器,以及人可以介入的界面。我见过的每一个有效循环,都需要这样的技术栈才能构建出来,而真正形成差异的地方也在这个技术栈里。
那么,AI模型怎样知道自己的工作已经完成?目前,它不知道。预算耗尽时,或者我们设计的某个检查说“够了”时,它才停止;这两者都需要构建。真正重要的系统,不会是那些能够继续运行的系统。它们全都能继续。真正重要的系统,将是那些由构建者事先精确决定了“完成”要花多少钱、以及“完成”究竟意味着什么的系统。
原文披露
本通讯仅供参考,不应作为法律、商业、投资或税务建议的依据。此外,本内容不构成投资建议,也不供任何a16z基金的投资者或潜在投资者据此使用。本通讯可能链接其他网站,或包含从第三方来源获得的信息;a16z未独立核实这些信息,也不对其当前或持续的准确性作任何陈述。如果本内容包含第三方广告,a16z未审查这些广告,也不认可任何广告内容或其中相关的公司。本文提及、引用或描述的投资及投资组合公司,并不代表a16z管理的投资载体中的全部投资;完整投资清单见a16z投资清单。其他重要信息见a16z披露。
此文章由AI翻译。原文:Knowing When to Stop: The Art of Making a Loop Converge。
Footnotes
-
R. Schaeffer、J. Kazdan、J. Hughes、J. Juravsky、S. Price、A. Lynch、E. Jones、R. Kirk、A. Mirhoseini和S. Koyejo,How Do Large Language Monkeys Get Their Power (Laws)?,第42届国际机器学习大会论文集(ICML 2025,口头报告),PMLR 267:53132–53176。 ↩
-
Agentic Test-Time Scaling for WebAgents(CATTS),arXiv:2602.12276。样本数N从1到10:成功率由38.8%升至43.2%;N从10到20:使用两倍词元,多提高0.2个百分点。 ↩
-
When More Thinking Hurts,arXiv:2604.10739。每个新增推理词元的边际效用先趋平,再变为负值:得到更大预算的模型会放弃已经正确的答案。简单问题较早达到峰值,困难问题较晚;统一预算对两者都是错的。 ↩
-
所有代码和运行轨迹见goal-loop-traces仓库。 ↩