AI 智能体的持续学习
AI 智能体的持续学习
持续学习在 AI 领域常被简化为"更新模型权重"这一件事,但 Harrison Chase 在这篇文章中提出了一种更具工程实用性的观察视角:对于一个完整的 AI 智能体系统,学习可以在三个不同层面发生——模型层、框架层和上下文层。模型层涉及权重更新与灾难性遗忘这一尚未解决的研究难题;框架层通过分析运行轨迹来优化驱动智能体的代码和基础指令;而上下文层,也就是通常所说的记忆,则可以在智能体、用户或组织等不同粒度上进行持久的配置更新。文章特别指出,所有这些学习流程的核心驱动力都是"轨迹"——智能体执行路径的完整记录。对于正在构建或使用 AI 智能体的开发者而言,这个三维框架提供了一个非常实用的思维工具:当你希望系统随时间不断改进时,先问清楚——你要改变的到底是模型、是框架、还是上下文?答案不同,路径和成本也截然不同。
AI 智能体持续学习的三层架构
大多数关于 AI 持续学习(continual learning)的讨论都聚焦于一件事:更新模型权重。但对于 AI 智能体而言,学习可以发生在三个不同的层面:模型(model)、框架(harness)和上下文(context)。理解这一区别,会改变你对构建随时间不断改进的系统的思考方式。
智能体系统的三个主要层面是:
-
模型:模型权重本身。
-
框架:驱动模型并支撑智能体所有实例的框架。这指的是驱动智能体的代码,以及始终属于框架的指令或工具。
-
上下文:位于框架之外、可用于配置框架的额外上下文(指令、技能)。
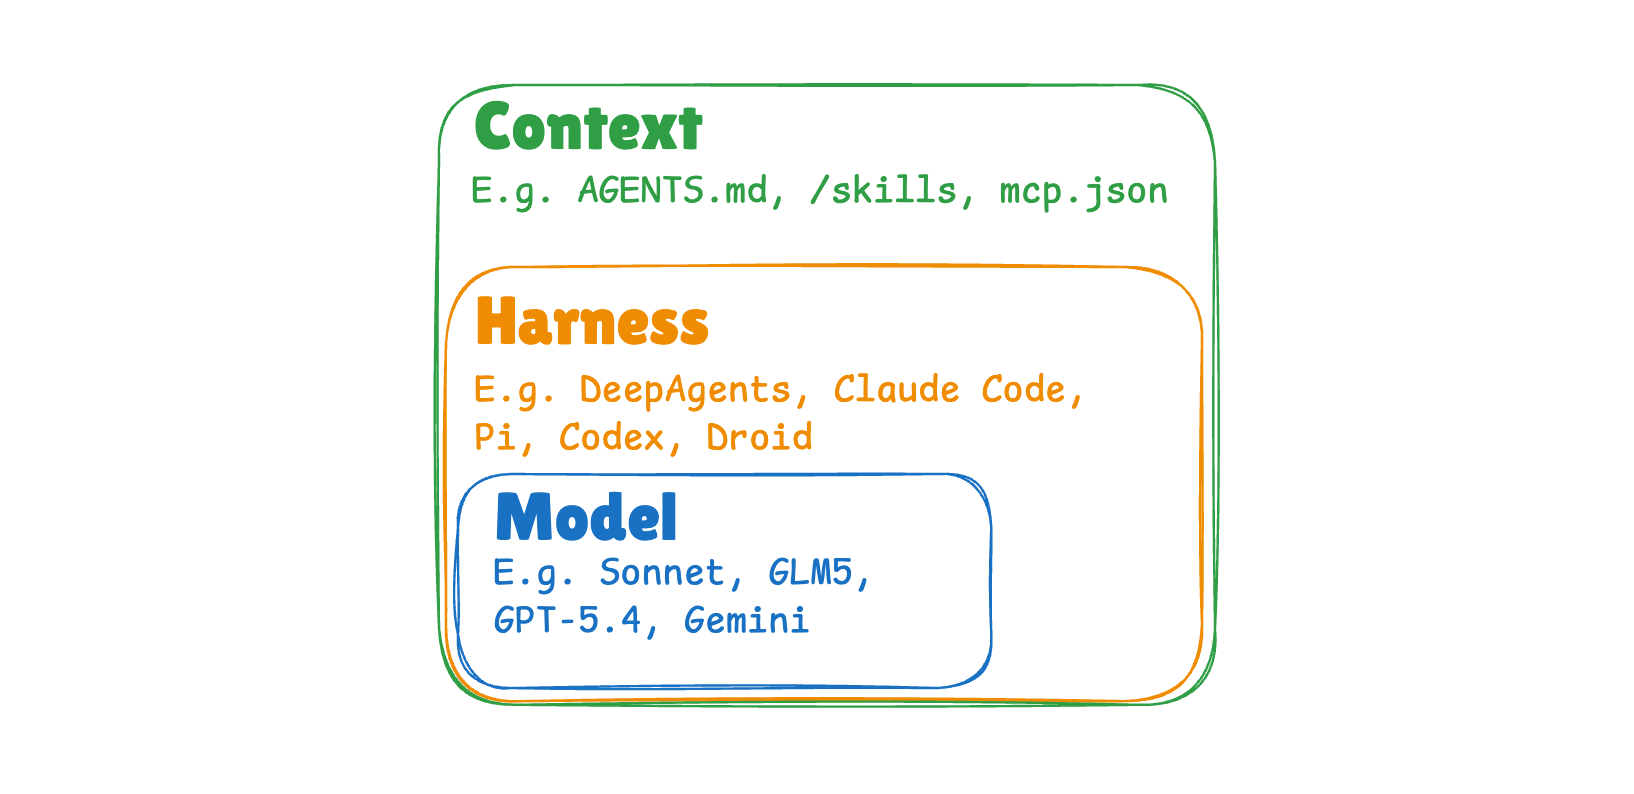
示例 #1:映射到 Claude Code 这样的编码智能体:
- 模型:claude-sonnet 等
- 框架:Claude Code
- 用户上下文:CLAUDE.md、/skills、mcp.json
示例 #2:映射到 OpenClaw:
- 模型:多种
- 框架:Pi + 其他脚手架
- 智能体上下文:SOUL.md、来自 clawhub 的技能
当我们谈论持续学习时,大多数人会立刻想到模型层。但事实上,一个 AI 系统可以在所有三个层面上进行"学习"。
模型层的持续学习
大多数人谈论持续学习时,最常见指的就是这一层面:更新模型权重。
更新模型权重的技术包括 SFT、RL(例如 GRPO)等。
这里的核心挑战是灾难性遗忘(catastrophic forgetting)——当模型在新数据或新任务上被更新时,它在之前已掌握的内容上往往会退化。这是一个尚未解决的研究问题。
当人们确实为某个特定的智能体系统训练模型时(例如,你可以将 OpenAI 的 codex 模型视为为其 Codex 智能体训练的),他们通常是为整个智能体系统进行训练。理论上,你可以在更细粒度上做这件事(例如,可以为每个用户配备一个 LORA),但在实践中,这通常是在智能体层级完成的。
框架层的持续学习
如前所述,框架指的是驱动智能体的代码,以及始终作为框架一部分的指令或工具。
随着框架越来越流行,已经有多篇论文探讨如何优化框架。
最近的一篇是 《元框架:模型框架的端到端优化》。
其核心思想是:智能体在一个循环中运行。首先在一组任务上运行智能体,然后进行评估。接着将所有日志存储到文件系统中。然后运行一个编码智能体来查看这些轨迹,并对框架代码提出修改建议。
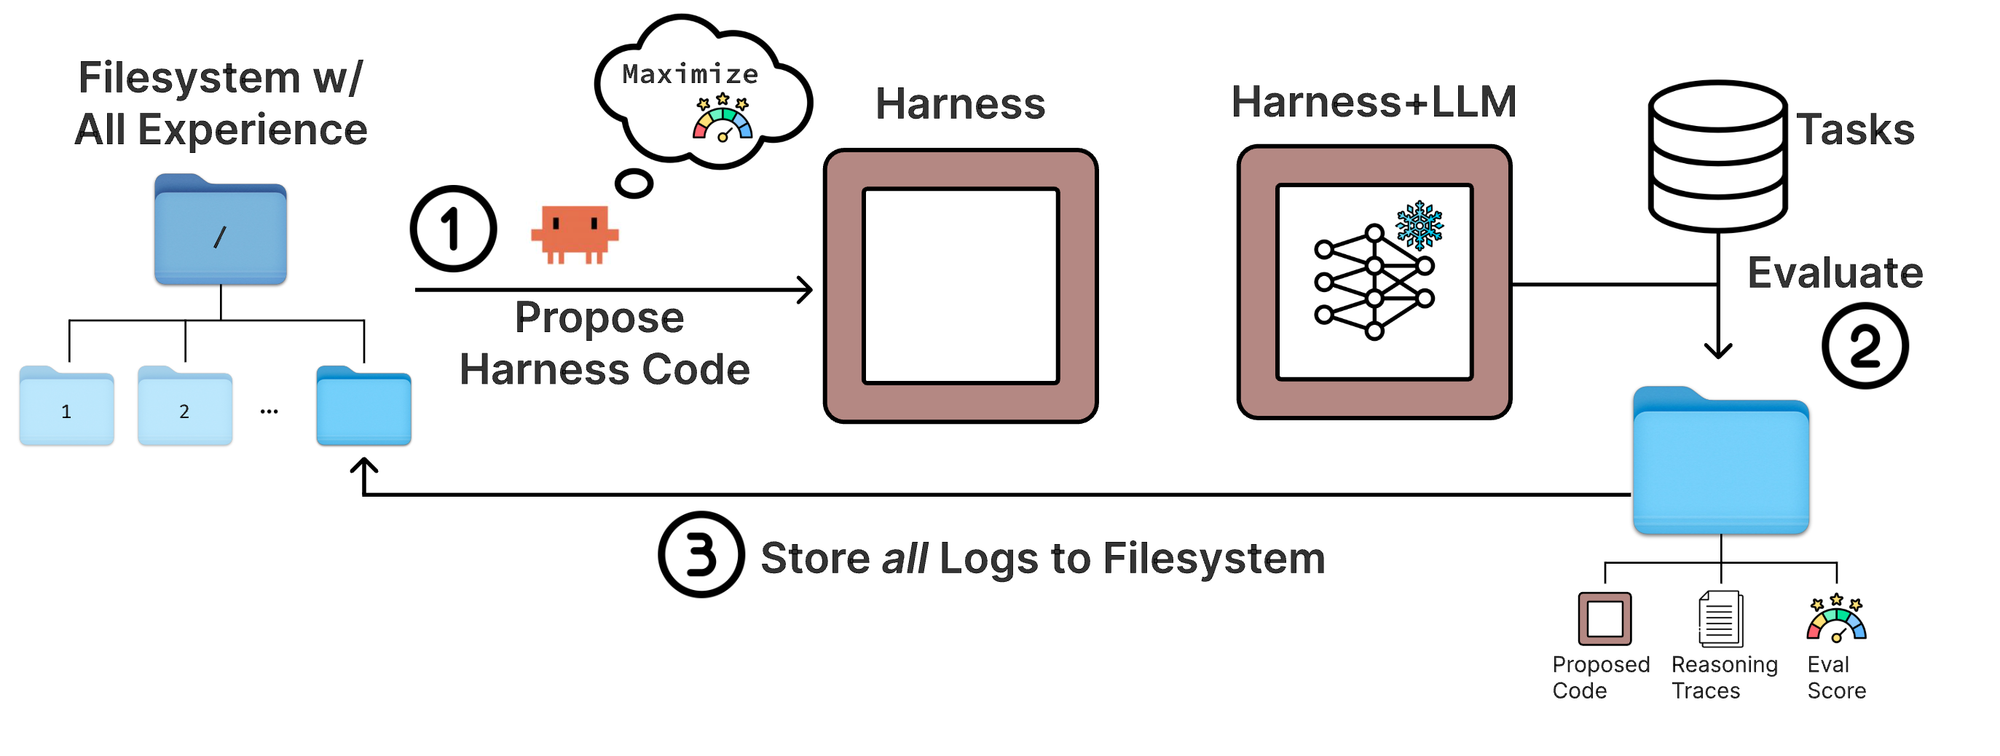
与模型的持续学习类似,这通常在智能体层级完成。理论上,你可以在更细粒度上做这件事(例如,为每个用户学习不同的代码框架)。
上下文层的持续学习
"上下文"位于框架之外,可用于配置框架。上下文包括指令、技能甚至工具等内容。这也常被称为记忆(memory)。
同一类型的上下文也存在于框架内部(例如,框架可能有基础系统提示词、技能)。其区别在于它是框架的一部分还是配置的一部分。
上下文的学习可以在多个不同层级上进行。
上下文的学习可以在智能体层级进行——智能体拥有持久的"记忆",并随时间更新自身的配置。一个很好的例子是 OpenClaw,它拥有自己的 SOUL.md,并随时间不断更新。
上下文的学习更常见的是在租户层级(用户、组织、团队等)进行。在这种情况下,每个租户拥有自己的上下文,并随时间更新。例如 Hex 的 Context Studio、Decagon 的 Duet、Sierra 的 Explorer。
你也可以组合使用!因此你可以拥有一个同时具备智能体层级上下文更新、用户层级上下文更新以及组织层级上下文更新的智能体。这些更新可以通过两种方式完成:
- 离线任务事后进行。与框架更新类似——遍历近期的大量轨迹以提取洞察并更新上下文。这就是 OpenClaw 所称的"梦境"(dreaming)。
- 在智能体运行的热路径中实时进行。智能体可以决定(或者用户可以提示它)在执行核心任务的同时更新其记忆。
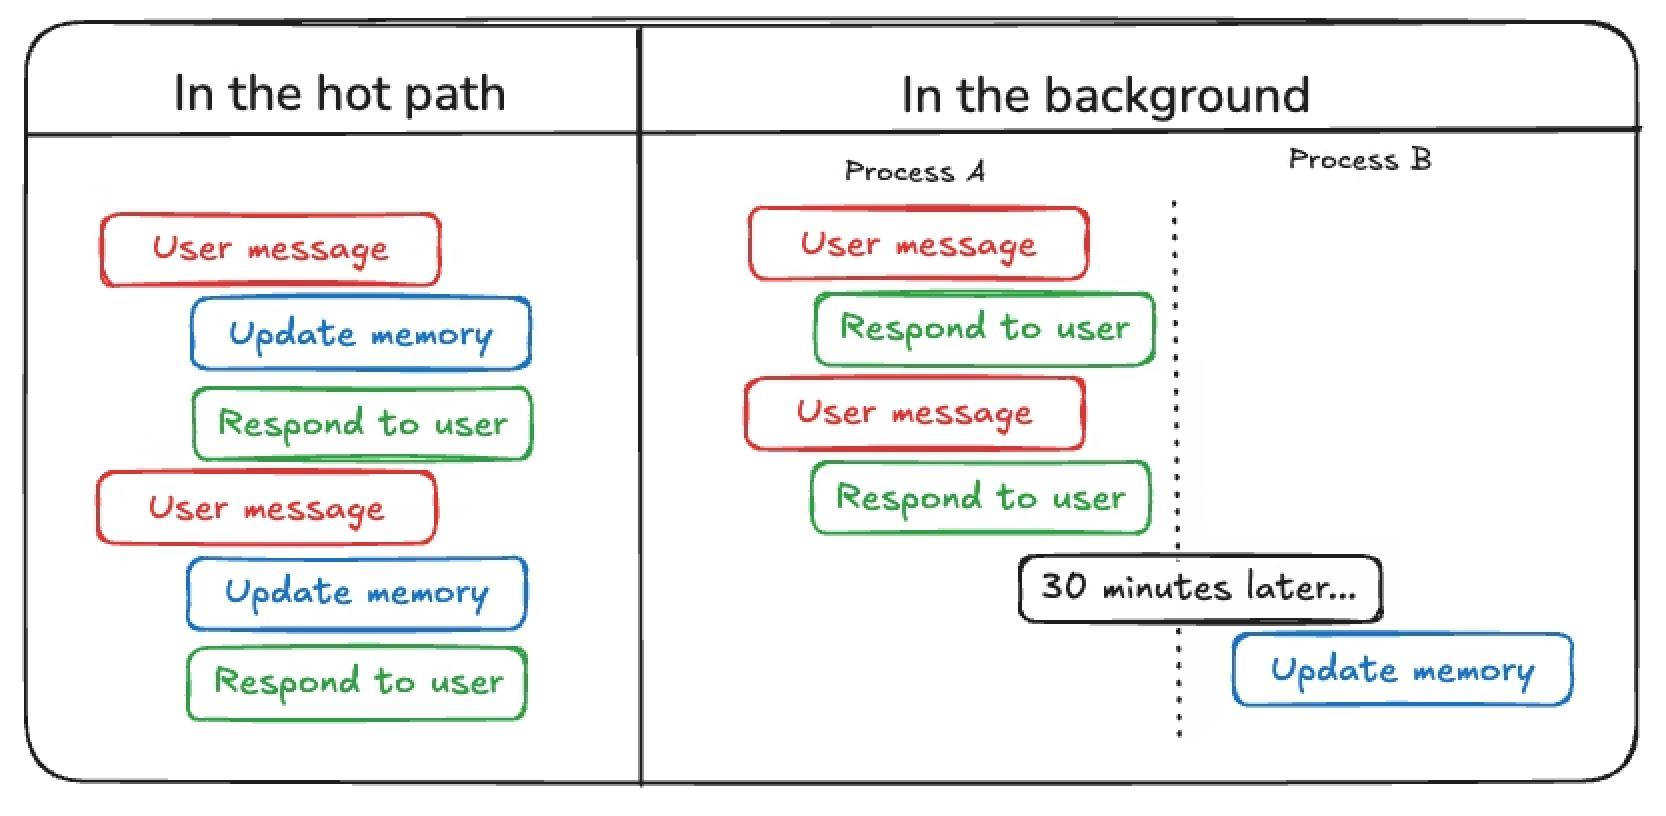
另一个需要考虑的维度是记忆更新的显式程度。是用户提示智能体去记住,还是智能体基于框架本身的核心指令自主记住?
对比
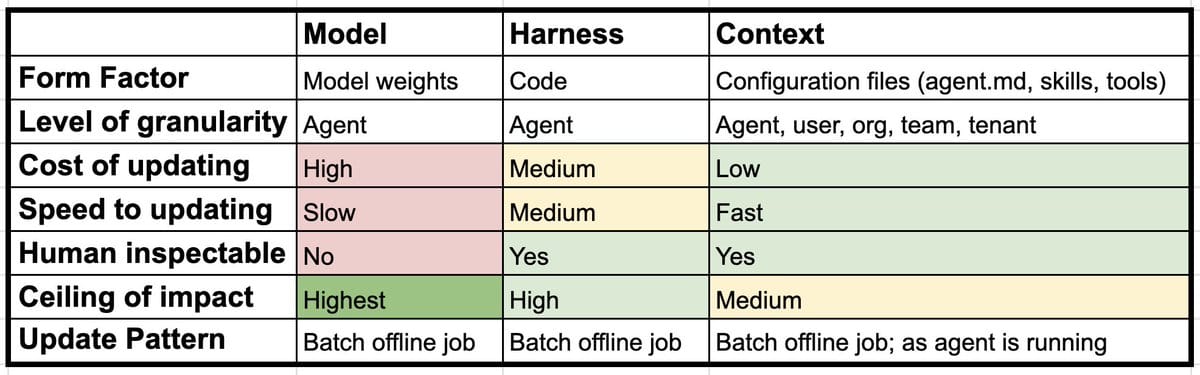
轨迹是核心
所有这些流程都由**轨迹(traces)**驱动——即智能体所做一切的完整执行路径。LangSmith 是我们的平台,其功能之一就是帮助收集轨迹。
然后你可以用多种不同的方式使用这些轨迹。
如果你想更新模型,可以收集轨迹,然后与 Prime Intellect 这样的团队合作来训练自己的模型。
如果你想改进框架,可以使用 LangSmith CLI 和 LangSmith Skills 让编码智能体访问这些轨迹。这种模式正是我们如何改进 Deep Agents——我们开源、模型无关的通用基础框架——在 terminal bench 上性能的方式。
如果你想随着时间的推移学习上下文(无论是在智能体、用户还是组织层面),那么你的智能体框架需要支持这一点。Deep Agents——我们选择的框架——以生产就绪的方式支持这一功能。请查阅相关文档,了解如何实现用户级记忆、后台学习等的示例。
**
术语表
| 原文 | 中文 |
|---|---|
| agent | 智能体 |
| catastrophic forgetting | 灾难性遗忘 |
| context | 上下文 |
| continual learning | 持续学习 |
| Deep Agents | Deep Agents |
| dreaming | 梦境 |
| GRPO | GRPO(Group Relative Policy Optimization) |
| harness | 框架 |
| hot path | 热路径 |
| LangSmith | LangSmith |
| LORA | LORA(Low-Rank Adaptation) |
| Meta-Harness | 元框架 |
| model weights | 模型权重 |
| RL | RL(Reinforcement Learning,强化学习) |
| SFT | SFT(Supervised Fine-Tuning,监督微调) |
| tenant | 租户 |
| terminal bench | terminal bench |
| traces | 轨迹 |
此文章由 AI 翻译