AI 智能体如何管理记忆、避免遗忘
即便是你技术栈中最复杂的 AI 智能体,每次处理消息时,也都是从一张白纸开始。
模型本身只能看到那一刻放在它面前的文本,对话的其余部分完全不在它的感知范围内。我们在与 Claude 或 ChatGPT 聊天时感受到的连续性,是外围平台代替模型实现的:平台会在每次调用时,把合适的上下文重新放进去。一旦理解了这个关键区别,智能体记忆这个领域就会成为一种与最初印象截然不同的工程问题。
本文将尝试理解这套架构是如何构建起来的:从迫使它出现的约束,一直讲到随之而来的取舍。
作者声明:本文依据多个来源公开分享的信息写成。如果发现不准确之处,请在原文评论区指出。
无状态
调用大语言模型(large language model,LLM)遵循一个简单的模式:系统发送提示词,模型返回响应,这次交互就到此结束。之后的每次调用,即使仅隔一毫秒,也都从完全空白的状态开始。这是所有商用 LLM 的 API 契约,也反映了 Transformer 如何处理请求。1
参见下图:
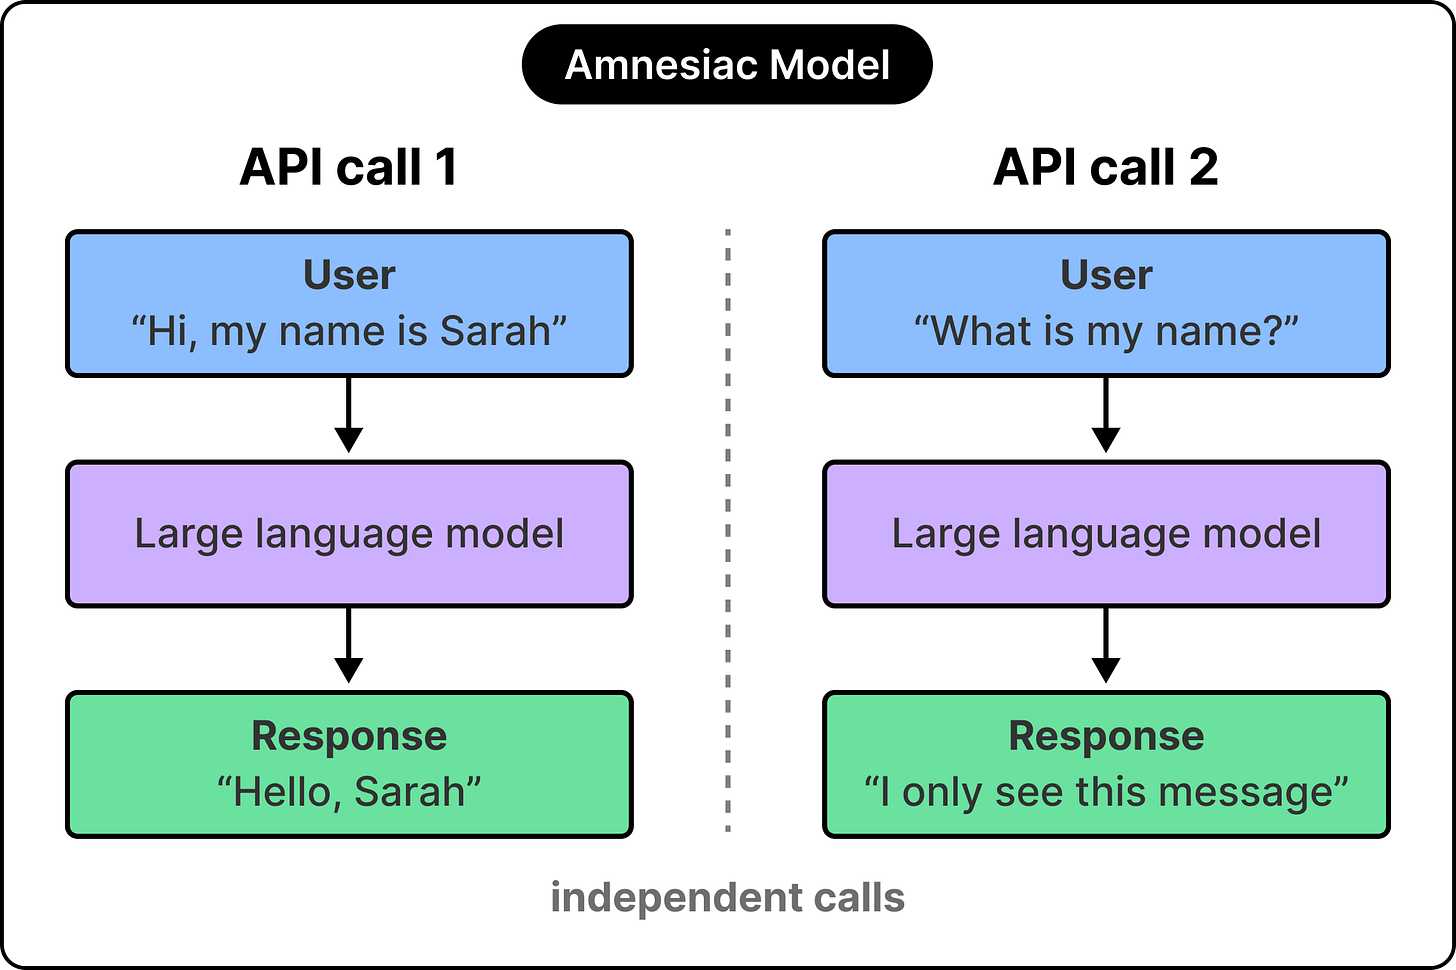
原文示意图:两次独立调用。第一次,用户说“你好,我叫 Sarah”,模型回答“你好,Sarah”;第二次,用户问“我叫什么名字?”,模型回答“我只能看到这条消息”。
当我们说“Claude 记得我们昨天的对话”时,描述的是产品的特性,而非模型本身的特性。平台代替模型把内容写下来,再在恰当的时刻读回提示词中,使模型能够推理,仿佛它一直在场。智能存在于模型内部,记忆则存在于模型外围的系统中。
如果模型本身就是这样工作的,下一个问题便是:我们能否在每次调用时,把所有内容都写进模型的视野,来解决记忆问题?理解这种方法如何失效,会让我们更清楚该怎么解决这个问题。
上下文
每次 API 调用都有一个上下文窗口(context window)。它基本上就是模型生成响应时读取的一块有边界的文本,其中包括系统提示词、用户当前的消息,以及开发者放进去的其他内容。模型能完整看到窗口内的内容,而窗口外的东西,对它来说就像放在另一台机器上一样。
参见下图:
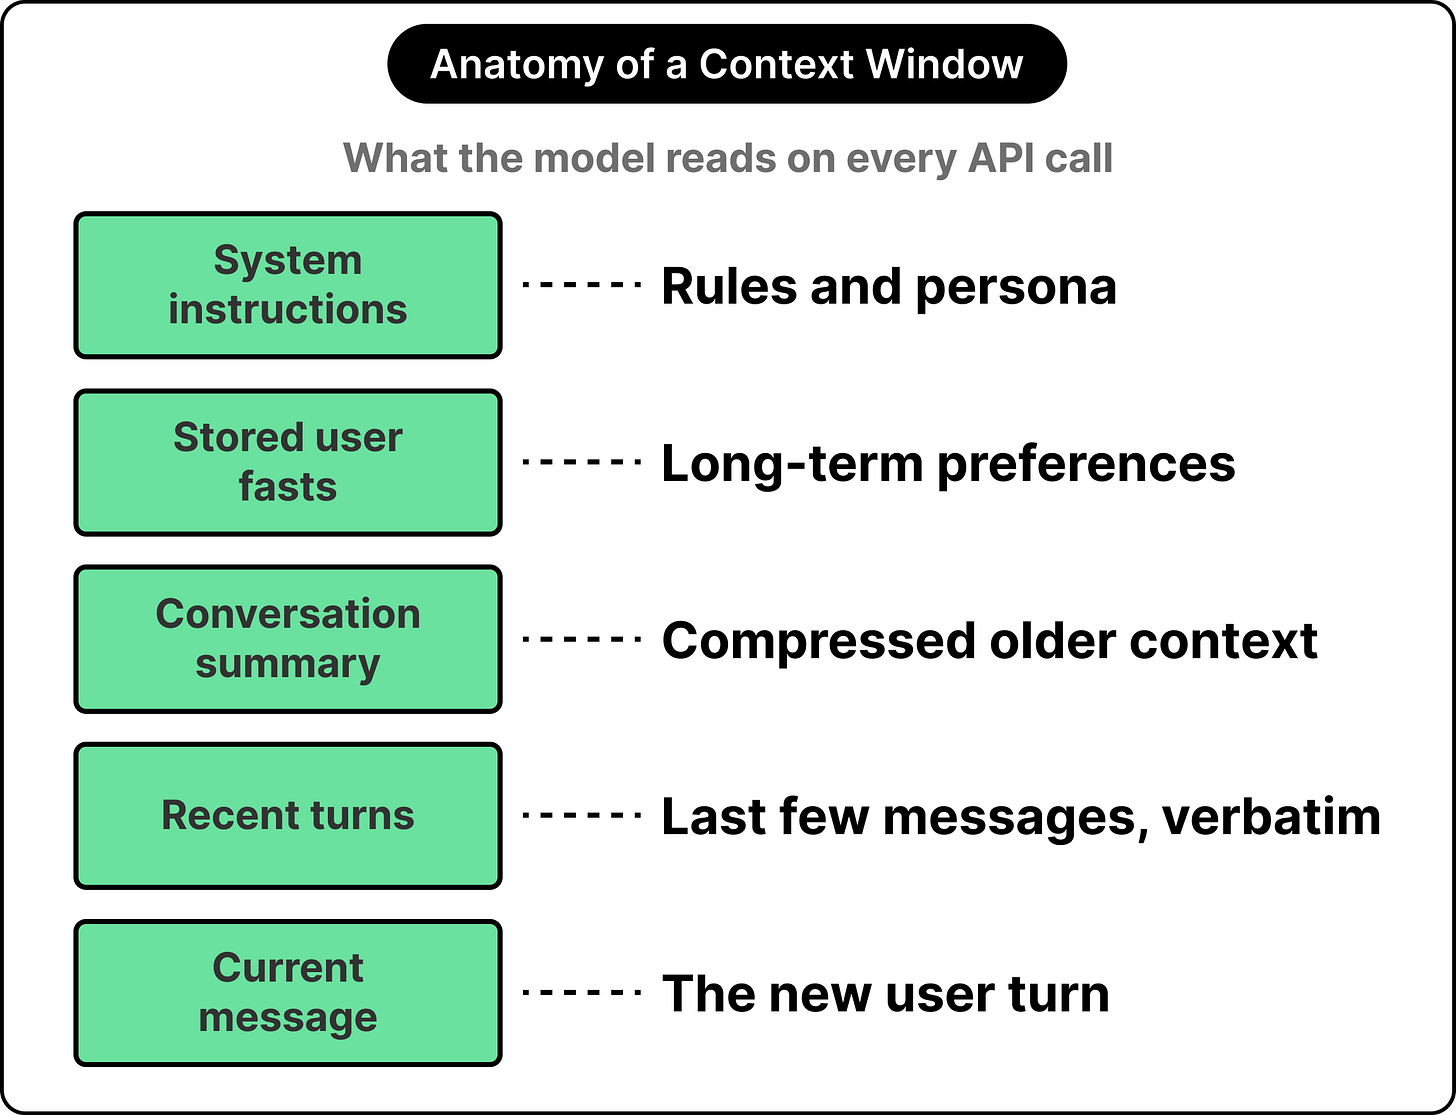
原文示意图:每次 API 调用时模型读取的内容。系统指令提供规则与角色设定;已存储的用户事实提供长期偏好;对话摘要压缩更早的上下文;近期轮次保留最近几条消息的原文;当前消息是用户的新一轮输入。
一种显而易见的记忆方法,是在每次调用时,把整个对话历史写进上下文窗口。聊天的前几轮,这种方法很好用。但对话变长之后,三个显著的问题会同时出现:
- 第一个问题是成本。上下文窗口中的每个 token,在每次调用中都会产生金钱和延迟成本,因此线性增长的对话会带来线性增长的账单。到第八十条消息时,系统可能每轮都要重新发送数万个 token,仅仅是为了维持连续性。
- 第二个问题是延迟。更大的上下文需要更长的处理时间。一个模型面对短提示词时两秒就能响应,面对填满大半个窗口的提示词时,可能需要十秒或十五秒。
- 第三个问题最违背直觉。模型的注意力会在长上下文中退化,放在长提示词中间的信息,不如放在开头或结尾的信息容易被可靠地回忆出来。研究者将其称为“中部遗失”(lost-in-the-middle)效应。
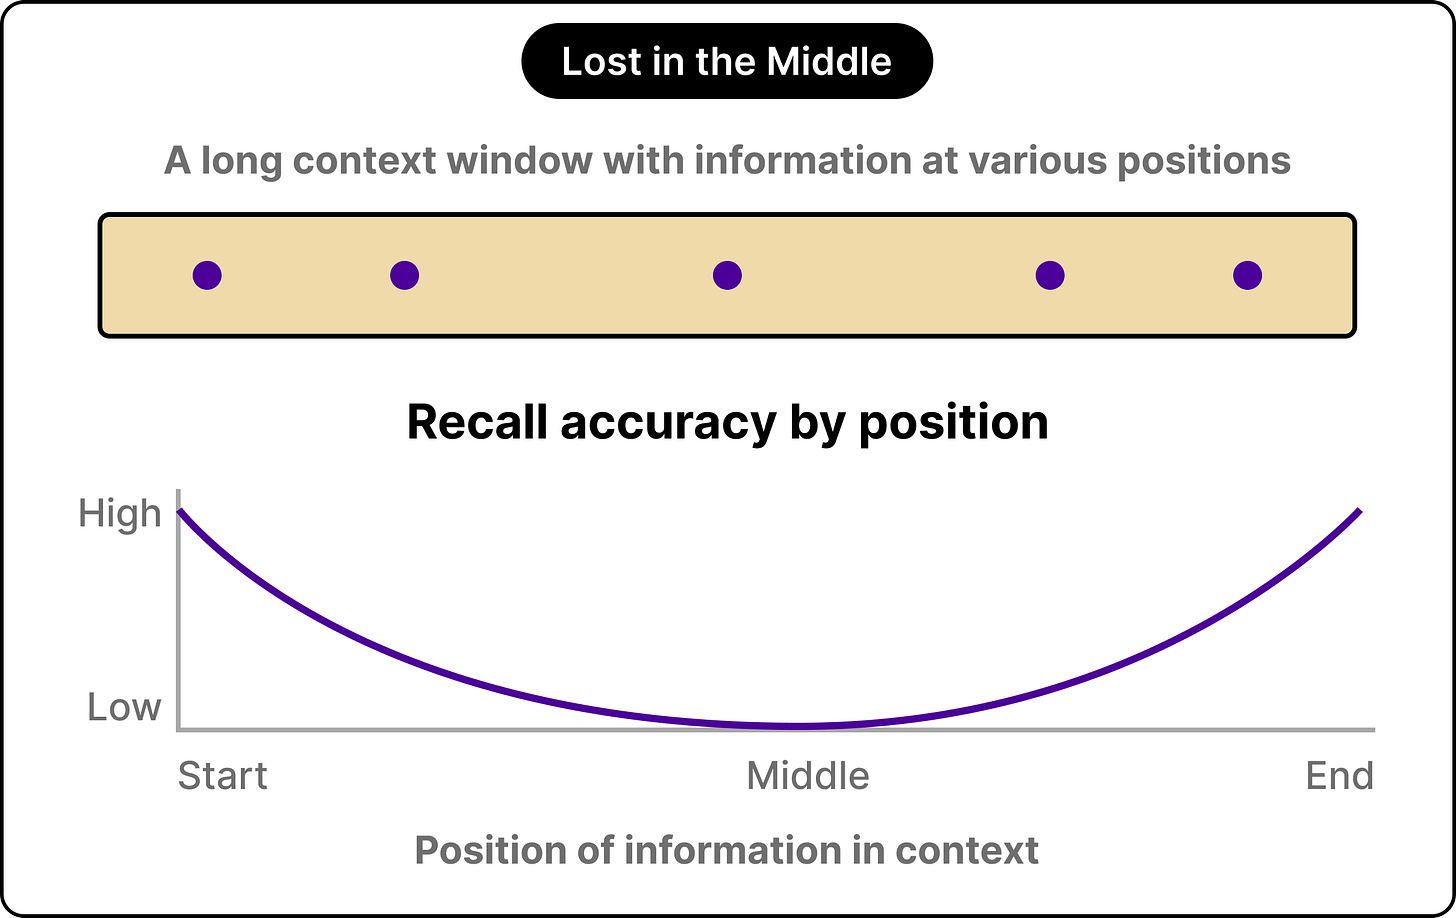
原文示意图:横轴是信息在上下文中的位置,从开头、中间到结尾;纵轴是回忆准确率,由低到高。曲线展示了作者所述的中部遗失现象,不包含具体测量数值。
更大的上下文窗口,让人感觉似乎能够彻底解决记忆问题。实际上,它只是扩大了房间,导航问题仍原封不动地存在。重要信息完全可能就在窗口里,却仍然被模型忽略。
既然仅靠更大的窗口不是合适的办法,我们就需要一种架构,决定任意时刻哪些内容应该进入窗口。
层级
真实的生产系统会把记忆组织成多个层级,每一层都在访问速度、总容量和每个 token 的成本之间作取舍。上下文窗口位于顶层,下面的存储逐层变慢、变大、变便宜。
它与操作系统内存的类比显而易见。现代智能体记忆系统大量借鉴了操作系统在高速 RAM 和较慢磁盘之间进行分页的方式,根据相关性的升降,把信息移入更高或更低的层级。
典型的四层结构,顶层是上下文窗口:速度快,容量严格受限,在大规模使用时每个 token 的成本都很高。下面是短期记忆或会话记忆,保存尚未被摘要或移出的近期活动。再下面是长期存储,跨会话保存持久事实、嵌入向量(embeddings)和结构化摘要。最底层是冷归档,用于保存很少访问、但需要留待审计或将来参考的材料。
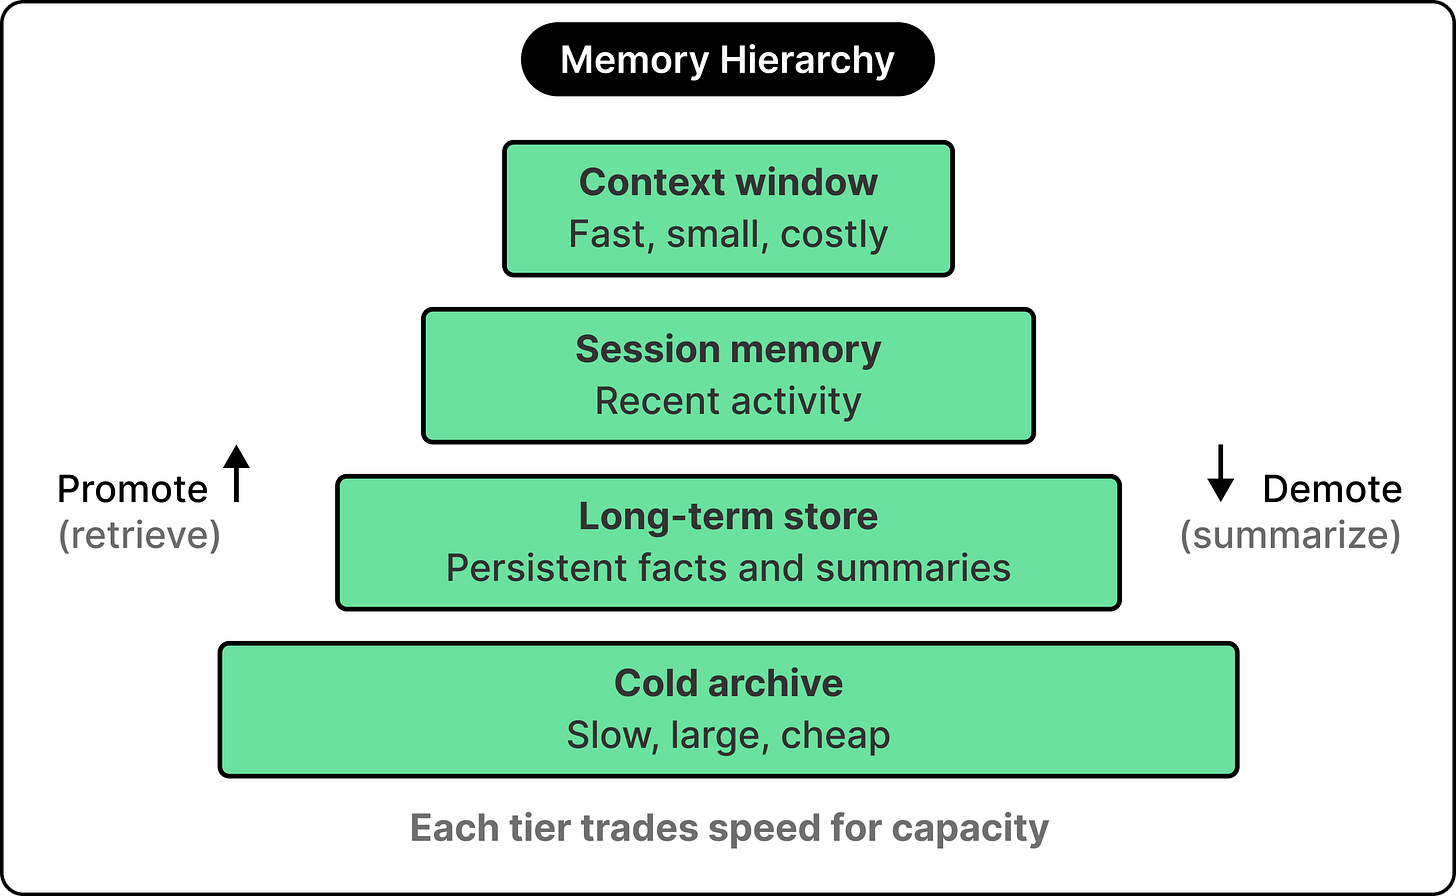
原文示意图:向上提升信息对应检索,向下降级信息对应摘要。上下文窗口快、小、昂贵;会话记忆保存近期活动;长期存储保存持久事实与摘要;冷归档慢、大、便宜。每一层都在速度与容量之间取舍。
智能体工作时,信息会在这个层级结构中上下移动。三个会话之前提到的事实,可能存放在长期存储中;一旦它变得相关,系统就会将其检索出来,重新提升到上下文窗口中。反过来,会话结束时,上下文窗口里最有用的部分会被概括成摘要,写入较低层级。
ChatGPT 的记忆功能使用了这个思路的一个简单版本。已存储的用户事实和近期对话的摘要,会被加在每个新提示词的前面,而当前会话占据工作层。精妙之处在于一开始决定什么内容值得提升为长期记忆,而不是读取时进行复杂的检索。2
层级结构描述的是记忆存放在哪里。我们存储哪些类型的记忆,则是另一个问题,按照不同的维度来组织。
类型
这个领域借鉴认知科学的概念,并将其用于语言模型智能体,逐渐形成了四种功能性记忆类别:
- 工作记忆(working memory) 保存当前任务的实时上下文窗口中的内容。例如,智能体正在帮助我们调试一个函数,那么函数代码和近期消息就属于工作记忆。任务一结束,工作记忆便清空。
- 情景记忆(episodic memory) 保存特定过往交互的记录,并带有时间锚点。例如,“三天前,这位用户问了新工程师入职的问题,我们讨论了清单模板”,就是一条情景记忆,记录了一个特定事件及其上下文。
- 语义记忆(semantic memory) 存储不依赖任何特定交互的事实与知识。“Adam 喜欢 Python 多于 JavaScript”“他的团队使用 GitHub Actions 进行持续集成(CI)”之类的信息,就是语义记忆。它们跨会话保存,在相关时发挥作用。
- 程序性记忆(procedural memory) 记录学会的做事方法。如果智能体发现,这位用户喜欢把状态更新分成三个部分,那么这个偏好就会成为程序性记忆;下次用户要求状态更新时,智能体会自动采用这种格式。
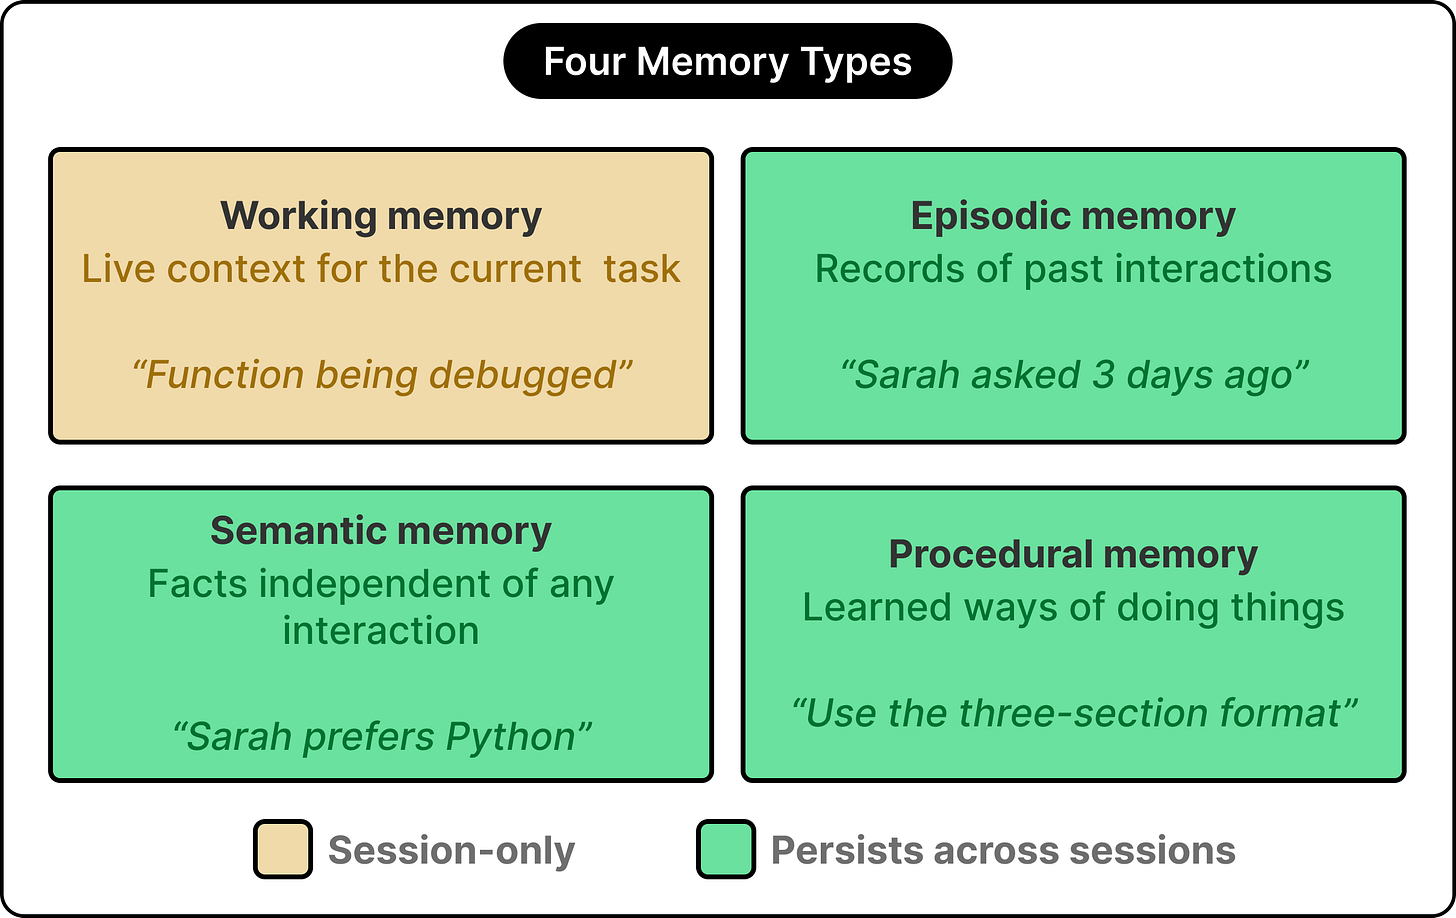
原文示意图:工作记忆是当前任务的实时上下文,例如“正在调试的函数”,只存在于当前会话;情景记忆记录过往交互,例如“Sarah 三天前提问过”;语义记忆保存独立于交互的事实,例如“Sarah 偏好 Python”;程序性记忆记录学会的做事方法,例如“采用三部分格式”。后三者跨会话保存。
这四种类型与上一节的层级结构是正交的。
一条语义记忆可能实际存放在长期存储中,一旦与当前任务相关,就被取进上下文窗口。大多数生产环境中的智能体至少实现了其中三种类型,组合取决于智能体要做什么。客服智能体大量依赖情景记忆和语义记忆,编程智能体则更多依赖程序性记忆。恰当的组合是一项设计选择,并没有固定公式。
这一切仍然留下了一个重要问题。
智能体究竟如何在每一轮中决定,检索什么、把什么放进模型的视野?
检索
存储或许可以看作智能体记忆比较容易的那一半。把一条事实写进数据库,或者在向量存储中为一段摘要建立索引,都是已经解决、拥有成熟工具的问题。更难的一半是检索:在每个新轮次中,决定哪些内容应该进入模型的感知范围。
检索之所以难,在于它需要判断相关性,而相关性会随着消息改变。例如,用户在询问新项目时,对 Python 的偏好很重要;当用户询问披萨食谱时,这个偏好的重要性就降低了。好的检索系统,会恰好在相关内容有用时把它提取出来,让其余内容安静地留在存储中。
参见下图:
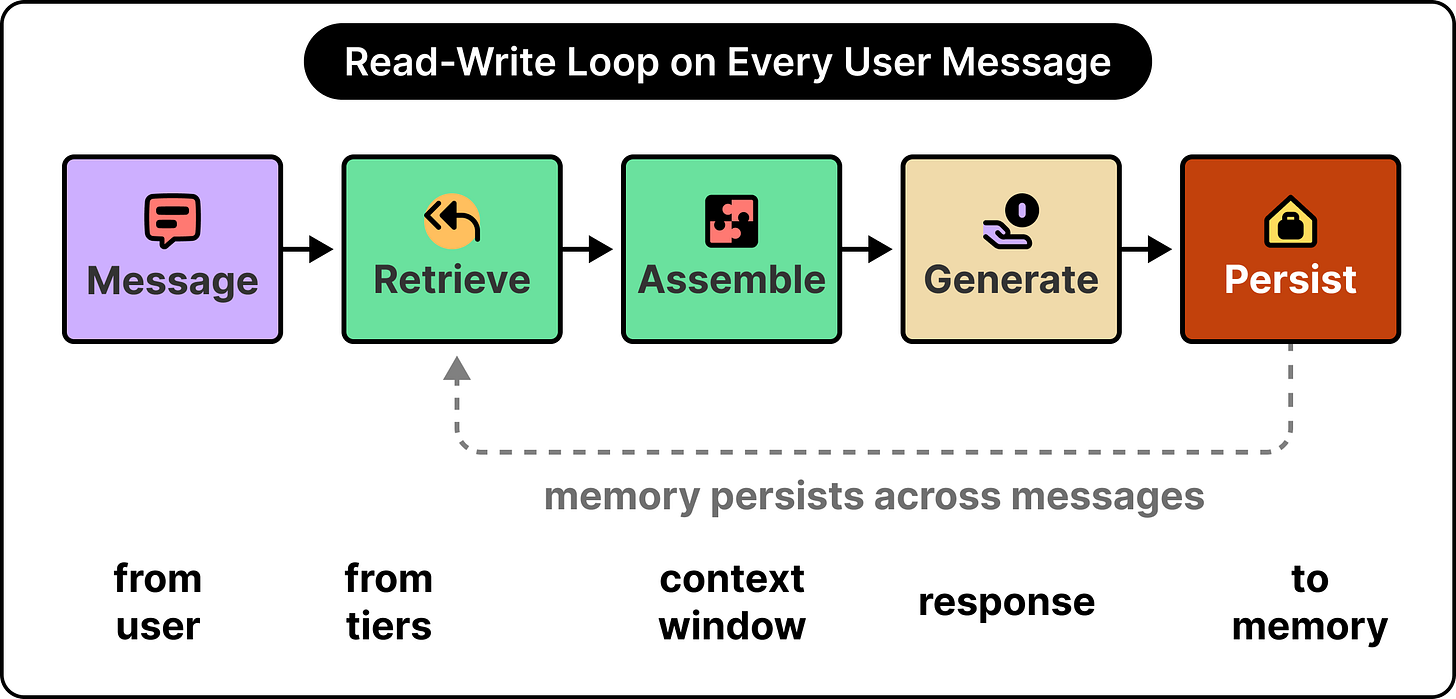
原文示意图:用户消息进入系统,从各层记忆中检索内容,组装上下文窗口,生成响应,再将内容持久化到记忆中。记忆在消息之间保留。
每条用户消息都会运行这个完整循环。
用户发送一条消息后,系统会综合关键词搜索、语义相似度和新近程度信号,从各个记忆层级检索相关条目。它会有意识地安排顺序,组装上下文窗口,通常把最重要的材料放在模型注意力最强的开头和结尾附近。模型运行并返回响应,之后,系统会把这次新交互的一部分写回记忆中,通常写成摘要,有时还会附上衰减分数,使其重要性随时间降低。
考虑两个智能体,就能明白检索为什么如此重要。
第一个智能体有一个完美记录过往交互的数据库,但配套的检索系统经常挑错记录。第二个智能体的记忆存储是空的,只依据用户在当前会话中告诉它的内容工作。第二个往往表现得更好,因为它知道自己能依赖哪些信息;第一个则自信地提取过期或无关的信息,再把它们当作确凿事实来推理。
换句话说,生产环境中的记忆故障,通常是披着记忆外衣的检索故障。
取舍
上述记忆架构涉及几项需要工程团队谨慎处理的取舍,其中四项尤其重要:
- 新近程度与相关性: 我们应该从记忆中检索最新的条目,还是语义最相近的条目?大多数系统两者兼用,如何把它们混合好,是一个持续存在的工程难题。过度偏重新近程度,会让智能体忘记有用的旧上下文;过度偏重相关性,则会让智能体执着于一个匹配度很高、却已过期的结果。
- 摘要与保真度: 把旧上下文压缩成摘要,可以节省 token,让一切更便宜、更快。但压缩是有损的,而且损失并不均匀。姓名、日期和明确承诺会在摘要中被抹平,整体主题则得以保留。精确细节已经悄然消失,智能体却仍然保持自信。
- 过期信息: 六个月前还成立的事实,今天可能已经错了,系统却仍然自信地使用它。例如,用户可能在 2024 年告诉智能体“我是素食者”,但到 2026 年已经重新开始吃荤。记忆系统只能用粗略的启发式方法猜测现实已经改变,于是它继续满怀信心地提供旧事实。高度相关的记忆如何处理过期问题,仍是一个开放的研究问题。
- 记忆污染(memory poisoning): 长期记忆也是一个长期存在的攻击面。六个月前被写入存储的一条隐蔽恶意指令,会一直留在那里,影响每次检索,直到有人注意到。让记忆有用的同一种特性——持久性——也会在内容错误或具有恶意时,让记忆变得危险。
当智能体需要跨会话的连续性,或者执行上下文不断累积的长期任务时,记忆系统是有意义的。对于一次性任务,它增加的复杂性会超出任务本身的需要。
结论
本文的五个核心观点如下:
- 模型是无状态的。每次 API 调用都从空白状态开始,我们观察到的连续性来自外围系统,而非模型本身。
- 上下文窗口是模型唯一的感知界面。把所有内容都写进去,会因为成本、延迟,以及长提示词中注意力退化而失效。
- 真实系统会把记忆组织成多个层级,上下文窗口位于顶层,下面的存储逐层变慢、变大、变便宜。
- 不同种类的信息,需要不同种类的记忆。工作记忆、情景记忆、语义记忆和程序性记忆,各自承担不同作用。
- 这个领域的主要工程问题是检索:每一轮,哪些内容值得进入模型的感知范围?这需要在过期信息、摘要损失和安全问题之间作取舍。
这一切带来的实践启示很简单。
下次我们看到一个标为“记忆”的产品功能,或者读到某个智能体“能够跨会话记住信息”时,恰当的问题应当从“模型能记住这个吗?”转向“这个模型外围的记忆架构究竟做了什么,又接受了哪些取舍?”
参考资料
- 《中部遗失:语言模型如何利用长上下文》(Lost in the Middle: How Language Models Use Long Contexts)
- 《MemGPT:迈向作为操作系统的大语言模型》(MemGPT: Towards LLMs as Operating Systems)
- 《语言智能体的认知架构》(Cognitive Architectures for Language Agents)
- 《ChatGPT 的记忆功能与新控制选项》(Memory and new controls for ChatGPT)
本文由 AI 翻译。