构建能在生产环境中运行的 AI 智能体:最佳实践
在演示中表现良好的 AI 智能体(AI agents),与能经受真实生产流量考验的智能体之间,始终存在差距。
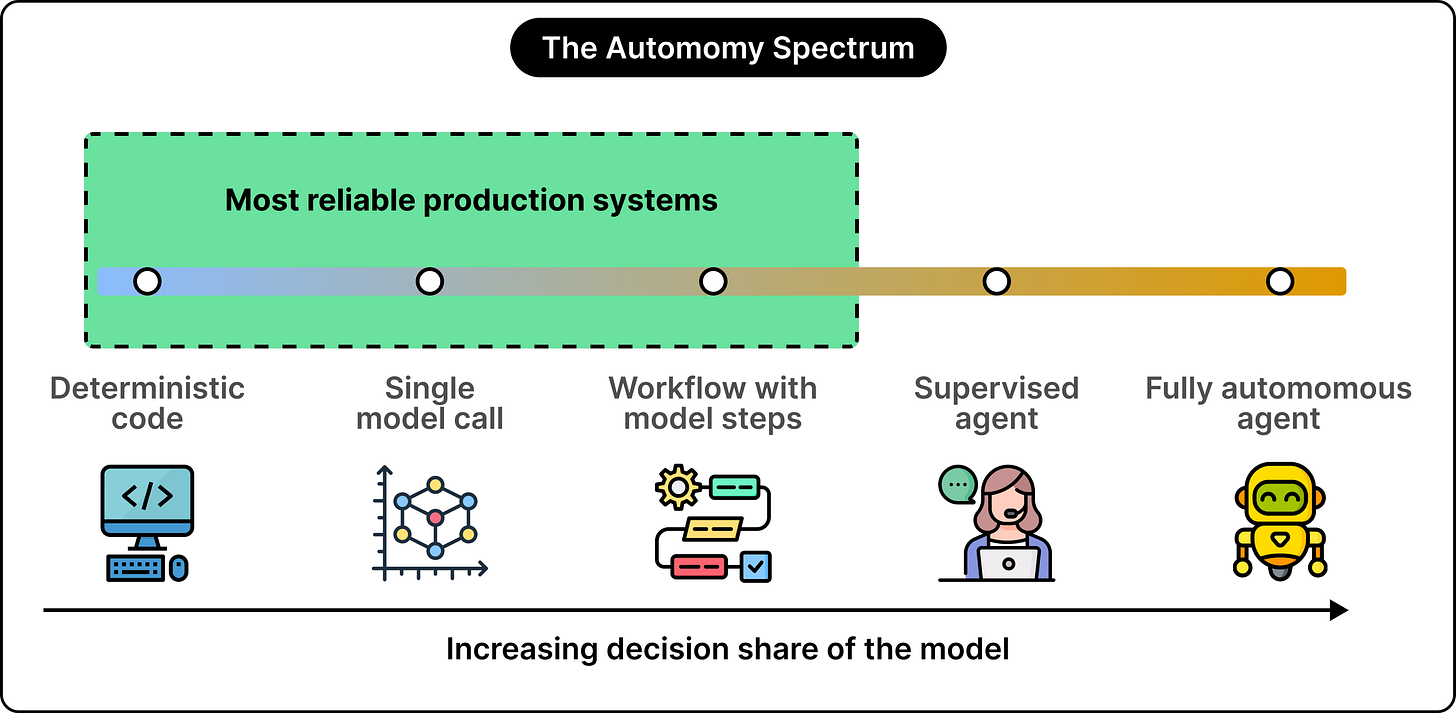
这是因为,处理真实客户工作负载的系统,对语言模型的依赖往往远低于演示给人的印象。系统的大部分行为通过传统的确定性代码(deterministic code)运行,只在少数特定的决策点调用模型。可靠的智能体与脆弱的智能体之间的差别,往往归结为一系列工程决策:哪些地方把控制权交给模型,哪些地方限制模型。
那么,怎样才能构建在生产环境中可靠运行的智能体?有没有最佳实践?
2011 年,Heroku 的联合创始人发布了《十二要素应用》(The Twelve-Factor App),提出了一套构建可可靠部署、扩展的 Web 服务的原则。这份文档影响了一代工程师思考软件的方式。
后来,AI 领域也出现了一项类似的尝试,即广为传播的《十二要素智能体》(Twelve-Factor Agents)原则。这些原则旨在让语言模型应用足够稳健,能够用于生产环境。此后,具体做法一直在演变,Anthropic、Cognition 和 Intercom 等公司的团队也加入了各自的经验。
本文尝试把这些共同思考整理成一组数量更少的实践,并解释每一项背后的理由,而不是要求大家记住一张编号清单。这些实践分为四个领域,最后再讨论权衡。我们将介绍:
- 上下文如何控制模型在每次调用中看到的内容?
- 控制流如何把循环及其停止条件保留在确定性代码中?
- 状态如何把记忆保存在软件中,同时让模型保持无状态?
- 职责范围如何让每个智能体保持专注,并处于监督之下?
读到最后,本文将建立一个生产环境智能体的实用定义,并让你清楚哪些决策最为关键。
免责声明:本文依据多个来源公开分享的细节撰写,参考资料见文末。如果发现任何不准确之处,请留言指出。
循环
先从任何人都能构建的最简单智能体讲起,因为它揭示了其他一切改进所围绕的结构。
智能体的核心是一个循环(loop)。模型接收一些上下文(context),也就是截至当前已发生事项的持续记录,然后就下一步行动返回一个决策。这个决策以结构化输出(structured output)的形式给出。它是机器可读的数据,例如 JSON,而不是自由形式的文字,因此普通代码可以读取它并据此采取行动。模型外围的代码执行所请求的步骤,把结果追加到上下文中,再把所有内容交回模型,供它做出下一个决策。循环持续进行,直到模型发出工作已完成的信号。
理解模型作用的一种有用方式,是把它看成每次调用都重新开始的函数。
在每次调用中,模型只看到提供给它的上下文,做出一个决策,并在响应的那一刻丢弃一切。上下文窗口(context window),也就是模型在某次调用中读取的那一组文本,充当了整个系统的全部记忆。
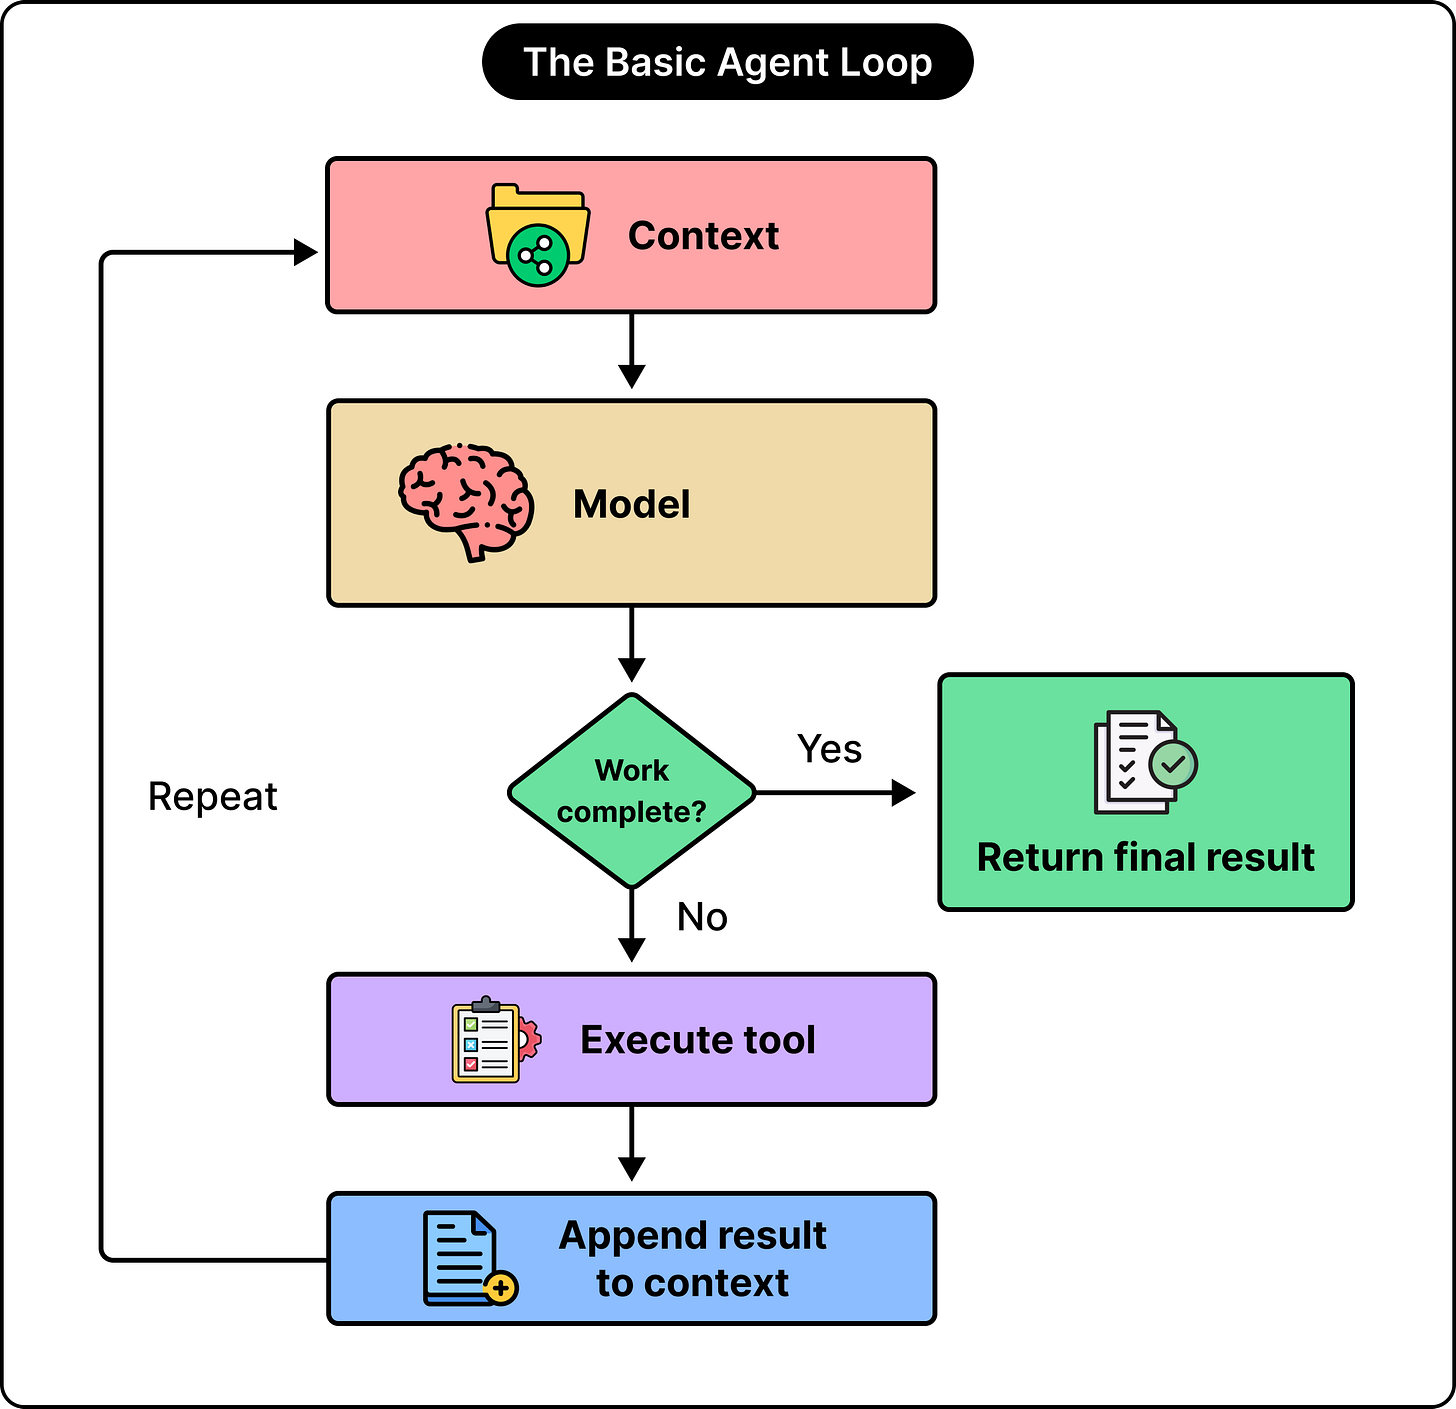
这种设计的吸引力很明显。开发者描述一个目标,提供一组工具,模型就自行确定操作顺序。由于模型负责决策,这种设计所需的分支逻辑更少。这种版本的智能体在演示环境中可以表现得相当不错。然而,真实流量到来后,麻烦就开始了。
失效模式
上一节介绍的设计在生产条件下会失效,而且这些失效往往遵循一些可预测的模式:
- 复合误差在串联步骤中不断相乘。
- 自信却错误的输出到达用户手中。
- 循环运行的时间超过预期。
- 当计划只存在于模型内部时,状态会丢失。
我们再稍微详细地理解一下这些情况。
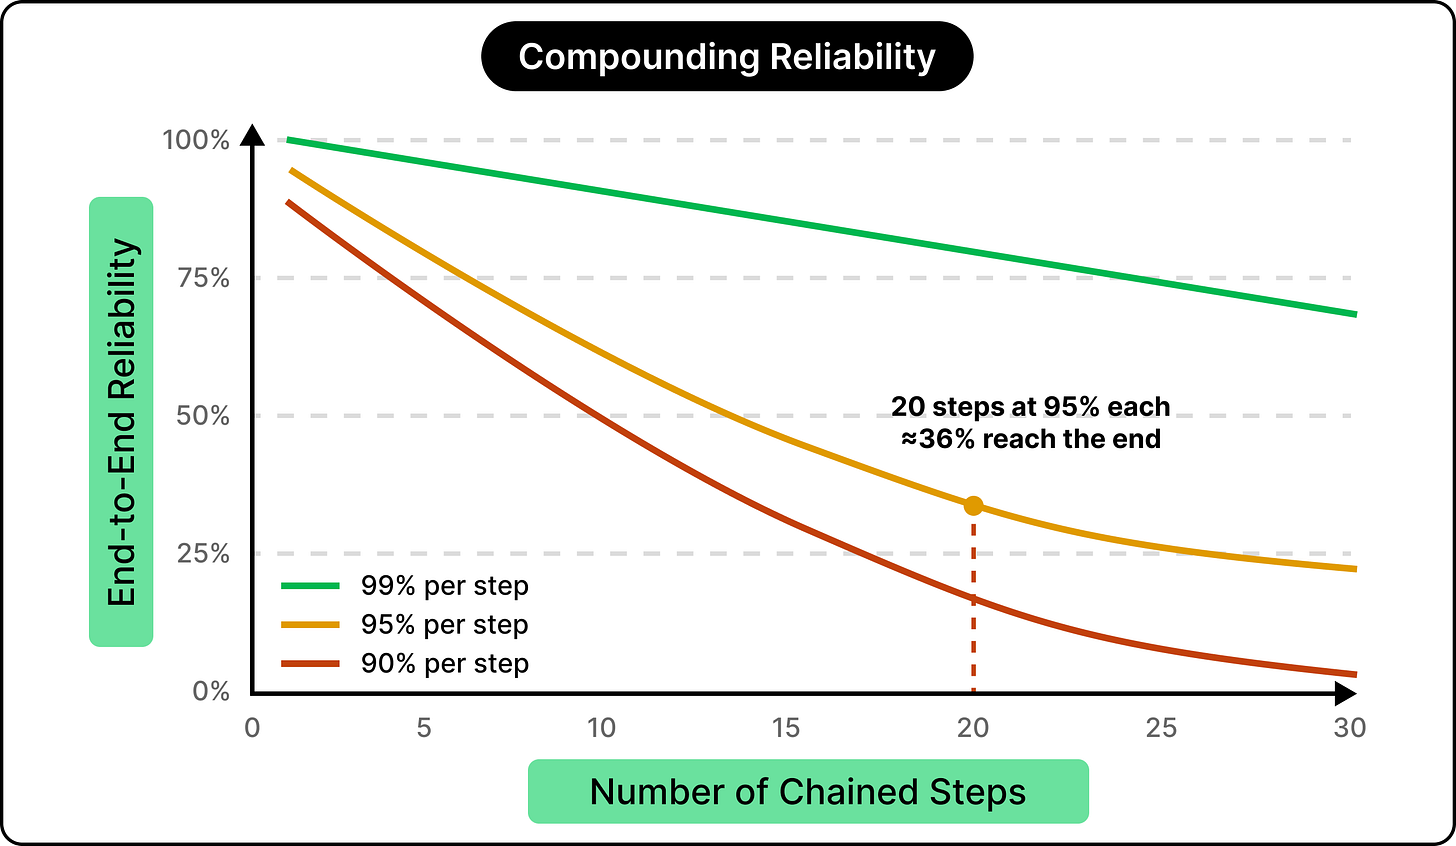
第一种模式是复合误差(compounding error)。每次模型调用都有一定概率做出错误决策,而一个不受约束的智能体会把许多次调用串在一起。假设每一步的正确率是 95%,听起来很可靠。但连续执行二十个这样的步骤,全部成功的概率就会降到大约三分之一。这里的数学关系是乘法,因此单独看起来不错的可靠性,在长链条中会迅速下降。这解释了为什么生产团队会加入如此多的防护措施(guardrails)。
第二种模式是自信却错误的输出到达用户手中。2025 年,编程工具 Cursor 的客服智能体向客户宣称,一份订阅只能在一台设备上使用;公司后来证实这条规则是它编造的,随后出现了一波取消订阅潮。更早一年的一个案例中,Air Canada 的聊天机器人编造了一项丧亲优惠票价政策,仲裁庭裁定航空公司承担责任,并责令其兑现该政策。研究给出的幻觉率(hallucination rate),即模型生成貌似可信却不真实的陈述的比例,即使在受控环境中也介于 3% 至 27% 之间。直接与客户交谈的智能体,会把这个比例转化为重大的业务风险。
最后两种模式更难察觉,但代价同样高昂。
停止条件不够严格的循环,可能运行得远超预期,每一轮都在消耗 token 和资金。最后,当计划只存在于模型的上下文中时,一次崩溃或一项长时间运行的任务,就可能丢失整条工作线索。
每一种失效都指向一项具体实践。下面把这些实践归入四个领域,从输入开始。
上下文
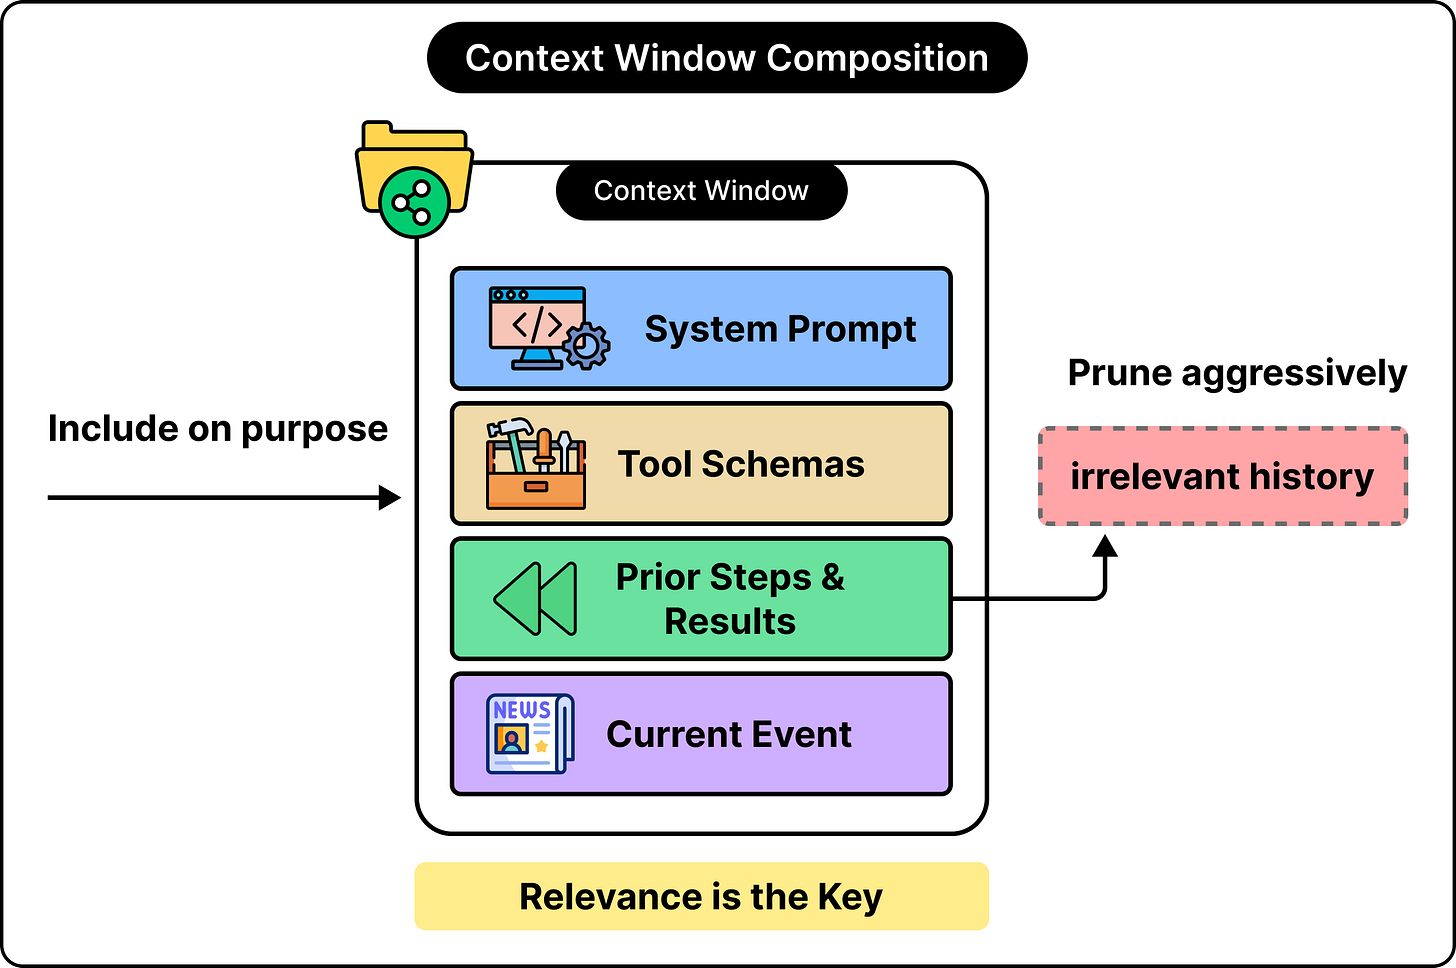
上下文窗口就是模型在某次调用中知道的一切,因此控制其中的内容,是提高可靠性的第一项、也是作用最大的一项手段。这里的大部分工作,可以由三个习惯完成。
第一个习惯是掌控自己的提示词(prompts)。提示词是发给模型的指令文本,应当像其他源代码一样对待,也就是进行版本控制、审查和测试。许多智能体框架自动生成提示词,并把它们隐藏起来。这很方便,直到行为发生变化,而原因却难以定位。把提示词保留在应用自己的代码库中,可以让其效果具有可复现性。
第二个习惯是掌控上下文窗口本身。每次调用的内容都是经过有意选择的,而这一选择的分量比乍看之下更重。与把大量松散相关的历史记录交给模型相比,给同一个模型提供聚焦、相关的上下文,表现会更好。随着窗口被作用有限的材料填满,质量会下降。因此,有意识地裁剪,主动删除超出当前步骤所需的内容,可以维持模型的准确性。换句话说,几乎每次调用中,相关性都比数量更有价值。
第三个习惯与工具有关。工具(tool)其实就是模型可以请求调用的函数,以明确的名称和输入模式(schema)加以描述。当这些描述准确时,模型会选择正确的工具,并正确填写参数。当描述含糊时,模型更容易选错。把工具定义当作需要认真完成的接口设计,会立即带来回报。
围绕这些习惯,已经形成了一门称为上下文工程(context engineering)的实践,它本身就是一个很大的话题。不过,核心思想依然简单:每一次都要有意识地决定模型看到什么。
控制流
只有当外围代码决定何时运行模型、何时结束循环时,掌控输入才有意义。在可靠的智能体中,控制流(control flow)属于模型外围的确定性代码,模型只在少数选定的时刻被征询。
把整体流程想象成普通代码:一系列步骤、条件分支,以及对外部系统的调用。在这个流程中的两三个位置,如果一个决策确实需要判断,系统就调用模型。其他所有地方都由普通的确定性逻辑完成,因为它的运行成本更低,输出可预测,而且容易测试。
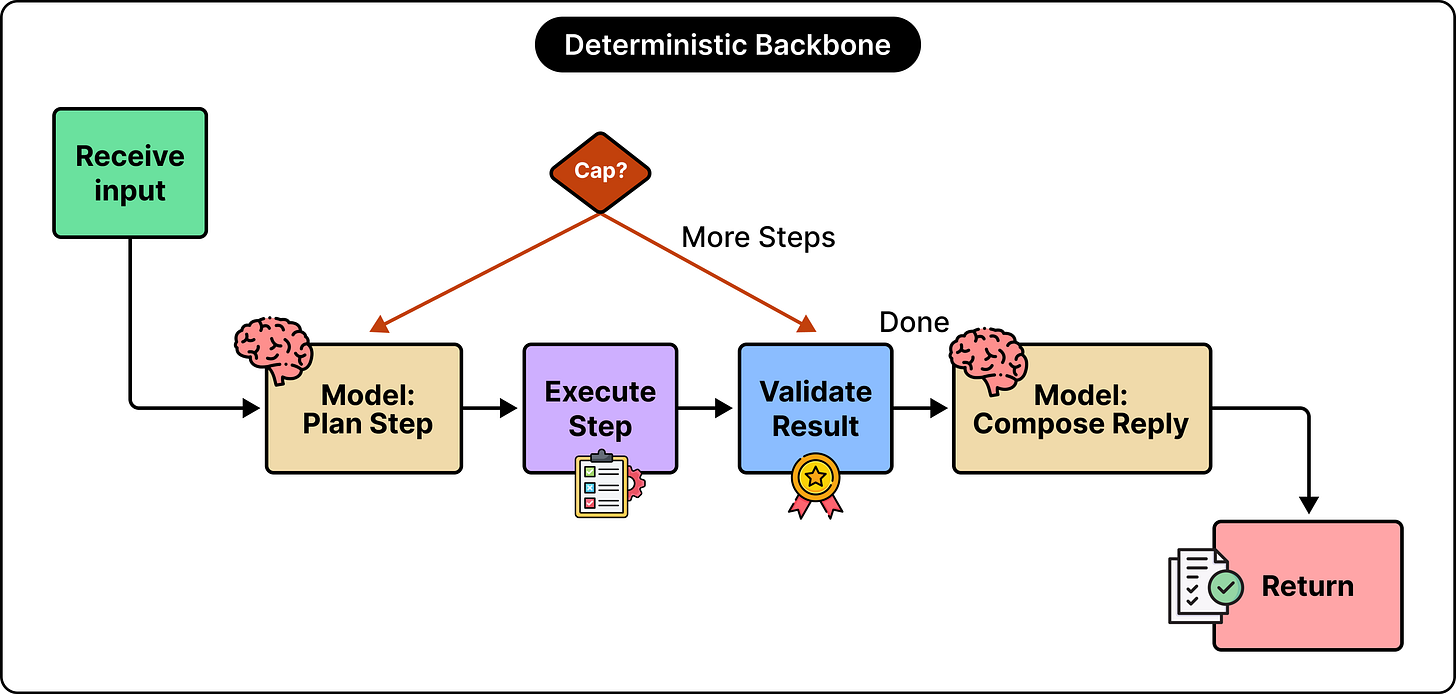
两条实用规则能让它奏效:
- 第一,每个循环都需要一个退出机制(escape hatch),也就是强制它停止的硬限制。迭代次数上限、超时和明确的完成条件共同保证:即使模型会无限继续,智能体也会停止。
- 第二,有意识地调用模型。模型应当用在需要开放式推理的问题上;凡是能够预先规定的事情,都由普通代码处理。
Intercom 的客服产品展示了这种模式如何大规模应用。
它较新的 Procedures 功能允许智能体用自然语言推理,同时由外围系统提供确定性控制,包括用于决策点的条件步骤、保证相同输入始终产生相同输出的小段代码,以及在敏感操作之前让智能体暂停、等待人工批准的检查点。
概括来说,从能够解决问题的最简单版本开始,只在更简单的逻辑不足以胜任的地方增加由模型驱动的自主性,是有益的。
状态
当外围代码掌控循环后,自然会出现一个问题:智能体的记忆存在哪里?
答案是让模型保持无状态(stateless),并把状态(state)保存在应用能够控制的软件中。
回想一下,模型每次调用都重新开始,只读取提供给它的上下文。当我们把这一属性当作一个特性来使用时,它就会变得强大。应用存储工作的真实状态、截至当前的对话、计划和进度,并在每次调用时据此重建上下文。由于状态存在可序列化存储(serializable storage)中,也就是系统能够保存并重新加载的形式,智能体就可以在任务进行到一半时暂停,稍后恢复;也可以在崩溃之后,通过加载已保存的状态并继续执行,顺利恢复。
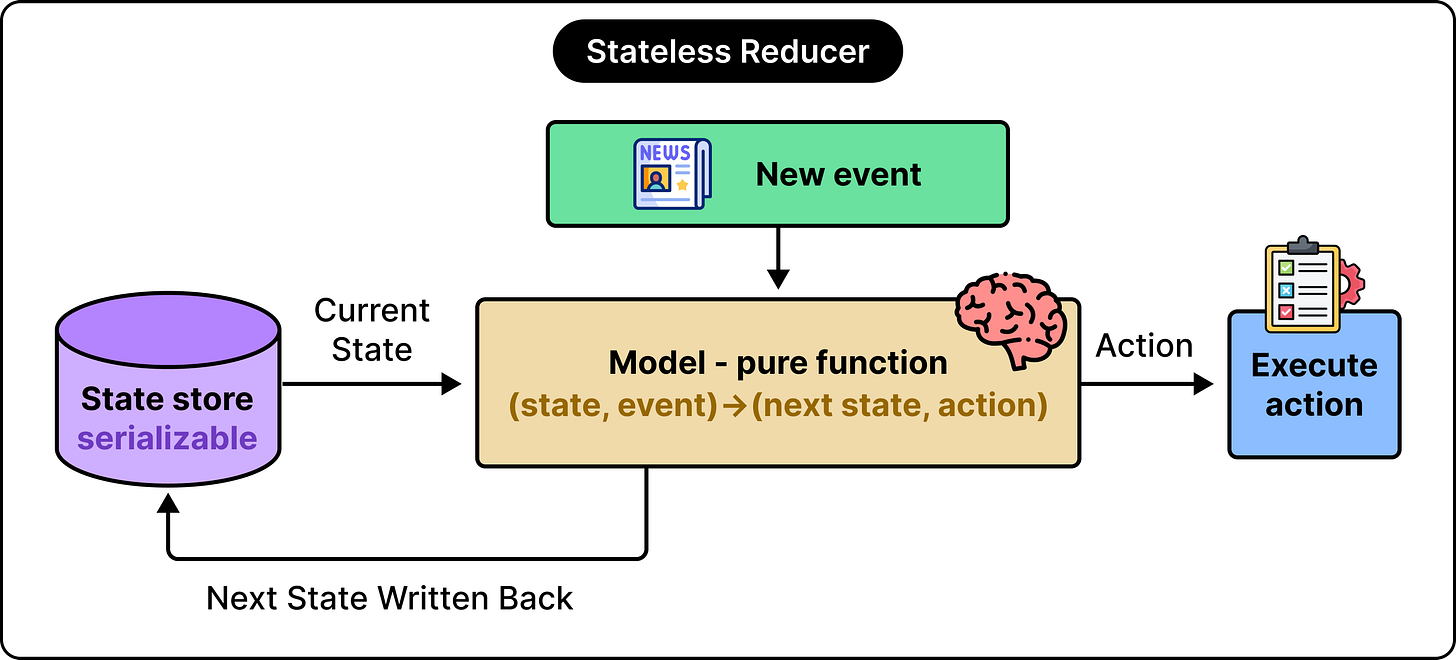
这一习惯还能让两种状态保持一致。一种是模型对正在发生什么的认识,另一种是应用记录的真实情况(ground truth),例如数据库中的实际内容。让二者一致,可以避免模型根据过时或不准确的当前状态认知采取行动。
这也有助于扩展。
当状态完全位于模型之外时,服务的任何运行实例都可以接手任何请求,因为所需的一切都可以通过上下文获得。这样就能在负载均衡器(load balancer)后运行多个副本,处理多得多的流量。
这里有一种清晰的模型理解方式:把它当作一个函数,接收当前状态和一个新事件,然后返回下一个状态以及待执行的行动。相同的输入会产生相同的结果,这让整个系统更容易测试,也更值得信任。1
职责范围
掌控输入、循环和状态之后,仍然有一个决策尚未解决:一个智能体应该尝试完成多少事情?较好的答案是,让小而专注的智能体在监督下工作,而不是要求一个职责宽泛的智能体包办一切。
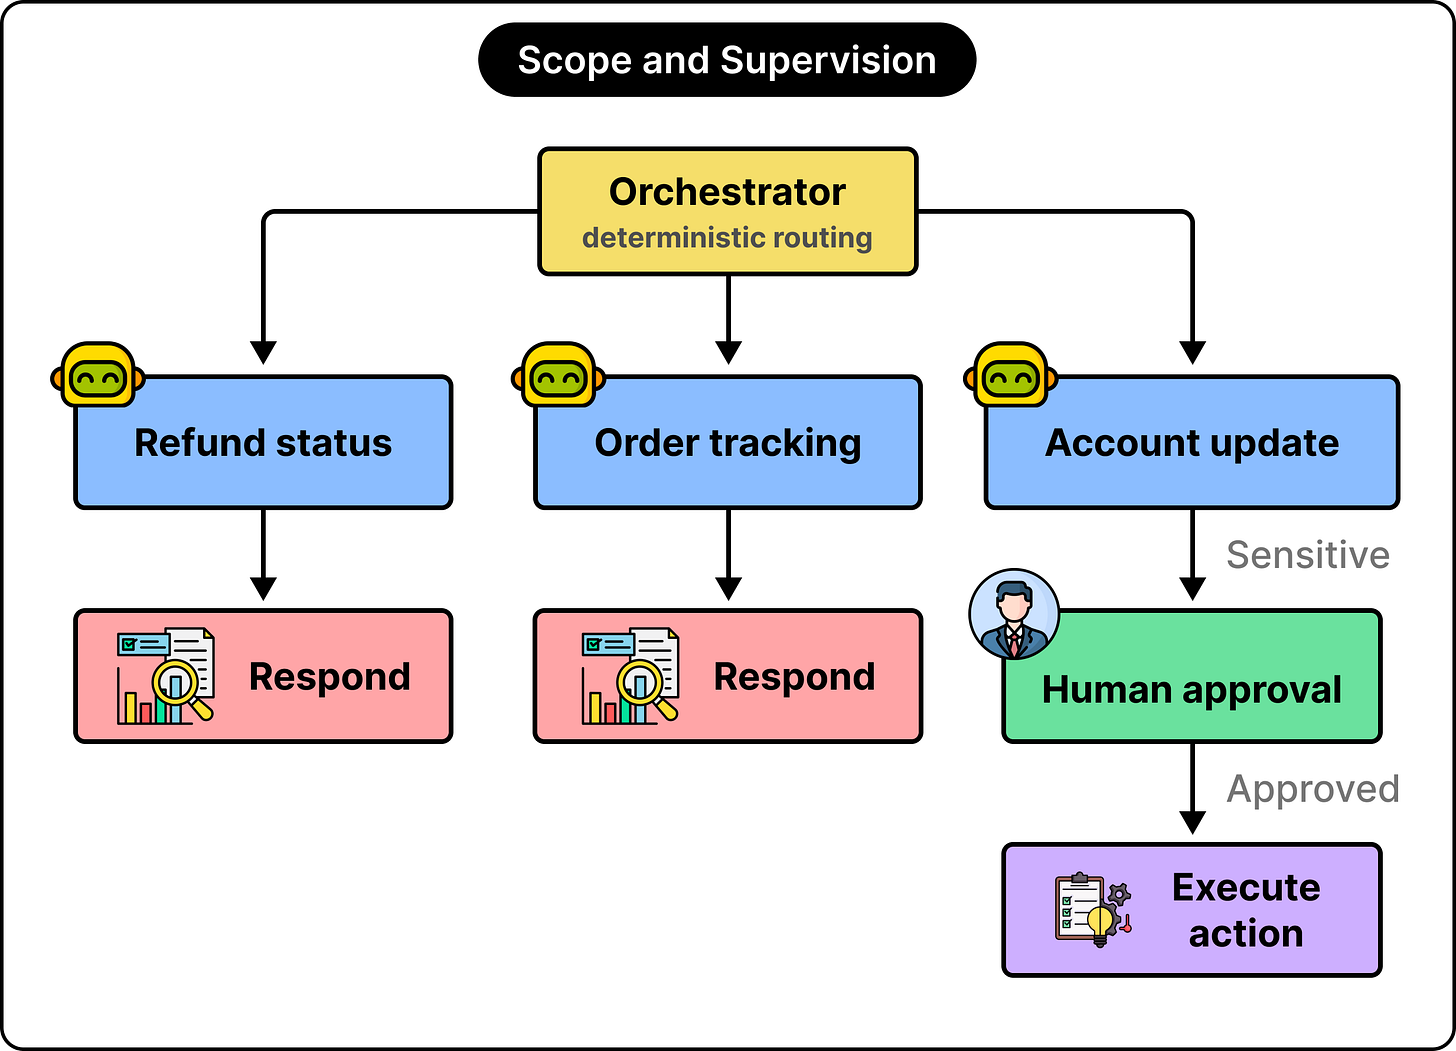
只有一项明确定义的工作的专用智能体,可能发生故障的范围更小。它更容易测试,更容易理解,也更容易在行为异常时修复。当一项任务跨越几种不同的工作时,可以在确定性编排(deterministic orchestration)下组合多个职责单一的智能体。由外围代码决定哪个智能体何时运行,而不是给一个通用智能体分配一长串职责。
Klarna 的客服助手展示了这种做法的好处。它在第一个月处理了大约 230 万次对话,其中大多数遵循可预测的路径,例如查询退款状态或跟踪订单。这些工作可以由结构化逻辑很好地处理,把模型留给确实需要它的情况。
监督是职责范围的另一半。
人工接手(human handoff)值得被设计成一个一等步骤。当行动敏感、置信度较低,或者客户要求与真人交流时,系统会有意识地进入这一步。Intercom 直接内置了这一机制,只要继续下去风险更高,就会自动把对话交给人工。把人的参与作为一条预先规划的路径,并准备好向接手者说明情况所需的状态,会使它成为系统的一项优势,而不是出了问题的迹象。
权衡
到目前为止,介绍的都是如今行之有效的实践。但也存在分歧和一些悬而未决的问题。
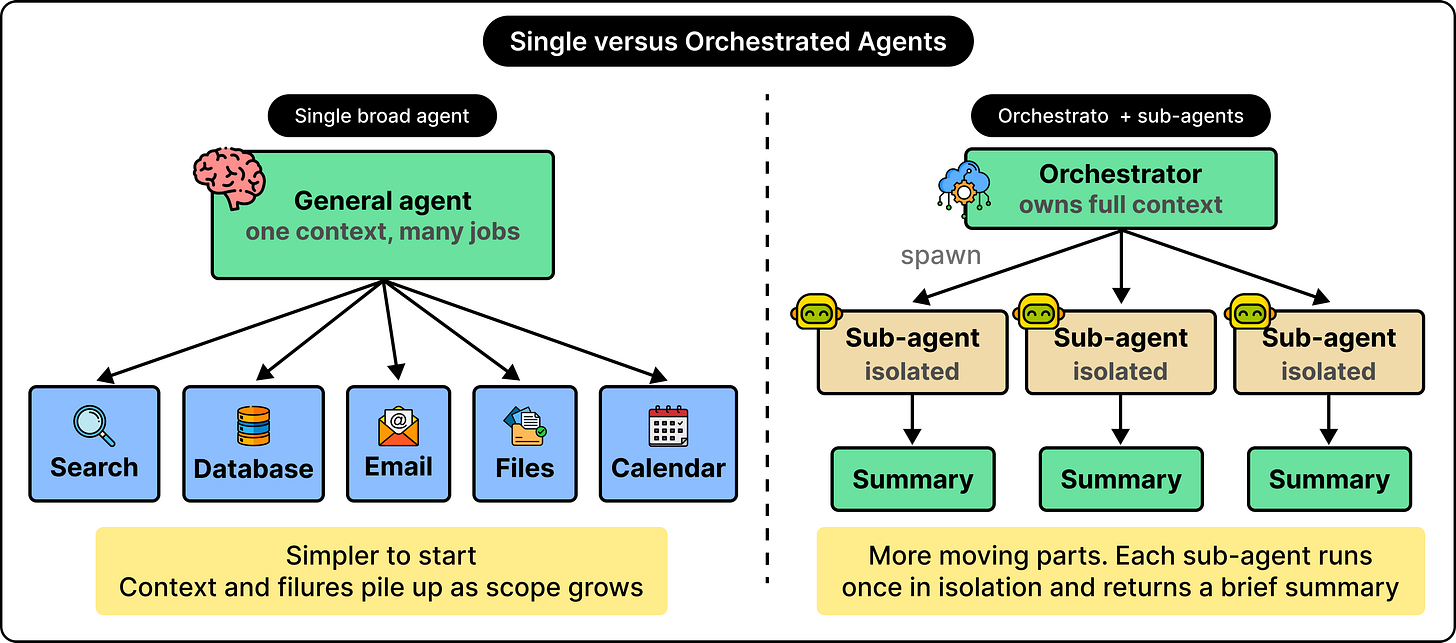
主要的争论涉及单智能体与多智能体。
2025 年 6 月,编程智能体 Devin 背后的团队提出反对多智能体设计的观点,因为并行的子智能体(sub-agents)会各自做出独立决策,随后相互冲突。一天后,Anthropic 介绍了自己的多智能体研究系统。该系统使用的 token 大约是单智能体方法的十五倍,在某些研究任务上的得分则高出约 90%。2
接下来的几个月里,这种表面上的矛盾逐渐归结为一种共同模式。由单一编排器(orchestrator)掌控完整上下文,并创建隔离、短生命周期的子智能体,每个子智能体完成一项任务后返回一份摘要。这里应当理解的经验是:小而专注的智能体在严格编排下表现最好,而彼此直接交流的子智能体往往会产生相互冲突的结果。
更深层的问题来自 Rich Sutton 所说的“苦涩的教训”(The Bitter Lesson)。这一观察认为,依赖更多计算的通用方法,随着时间推移往往会超越人工精心设计的方法。放到这里,它提醒我们:为了弥补当前模型不足而搭建的部分支撑结构,会随着模型改善而变得多余。这在一定程度上是正确的,也是反对过度工程化最有力的论据。
反过来看,其中几个问题无论模型有多强,都会持续存在。有限的上下文窗口、让文档第 5 页的一个数值与第 800 页的同一数值保持一致的需要、安全暂停并恢复的要求,这些问题即使模型变好也依然存在。
成本是每项决策的另一个考量。自主性和多智能体设计会消耗更多 token,有时要多得多,因此只有任务的价值足以支持这笔费用时,才值得采用它们。
结论
把生产环境智能体归结到本质,它主要是确定性软件,在少数有意选定的位置调用语言模型。设计决策就在于选择这些位置,并限制模型自行决定多少事情。
我们从最简单的智能体及其可预测的失效出发,逐步得到了这个定义,每种失效都由一项实践加以应对:
- 控制模型看到的内容。
- 掌控循环,并给它设置硬停止条件。
- 把状态保存在软件中,同时让模型保持无状态。
- 让每个智能体保持专注,并处于监督之下。
围绕这些实践,也存在真实的权衡,包括关于多智能体尚无定论的争论,以及模型持续改善后,部分工作会逐渐退出的事实。稳妥的做法是,从能解决问题的最简单设计开始,衡量它的不足,并且只在自主性提供明确价值的地方,赋予模型更多自主权。
参考资料
- 十二要素应用(The Twelve-Factor App)
- 十二要素智能体 — HumanLayer
- Anthropic — 构建有效的智能体
- Anthropic — 我们如何构建多智能体研究系统
- Cognition — 不要构建多智能体
- Intercom — Fin 3 有哪些新变化
- Rich Sutton — 苦涩的教训
- Cursor 客服机器人事件 — eWeek
- Air Canada 聊天机器人裁决 — AI Business
此文章由 AI 翻译
Footnotes
-
译者校注:这是原作者对无状态接口和外部状态管理的架构表述。Anthropic的工程报告指出,即便提示相同,智能体在不同运行中仍可能作出不同决策。文中“控制流”一节的确定性则明确指外围的小段代码。 ↩
-
译者校注:Anthropic原报告的比较基准是普通聊天:单智能体通常约用4倍token,多智能体系统约用15倍token。上述“单智能体方法的十五倍”保留ByteByteGo原述,原始报告没有给出这一比较结果。 ↩