HN 热点简报 · 2026-11-09
整理:henri
本期关注开发者从 Claude Code 转向 Pi 的使用经历、在 64GB 内存的纯 CPU 机器上运行大型稀疏模型,以及多代理并行工作带来的注意力负担。系统工具方面,一台十美元的 OpenStick 被用来运行家用服务,Outlook 的邮件认证要求和 Dux 桌面套件也引起讨论。行业话题包括高盛对编码代理的使用限制、OpenAI 新一轮融资和特斯拉的新品表现;另有长文讨论写作如何帮助思考,以及消费级脑电设备的数据使用与知情同意。
AI 编程工具
从 Claude Code 转向 Pi
长期使用 Claude Code 的开发者 Caleb(Salesforce)在博文里说明,自己因一连串小摩擦终于把主力编码代理运行框架(harness)换成开源的 Pi。他抱怨:仓库里要在 CLAUDE.md 与 AGENTS.md 之间复制内容或建立软链接;VS Code 里一次只能有一个会话「连上」编辑器选区,开第二个标签就收不到高亮上下文,相关问题报告自 2025 年底起就被当作不相关的重复报告关闭;官方 GUI 扩展虽支持多标签,但大量斜杠命令无法使用、没有自定义状态栏,子代理输出还按时间线混进主对话。他统计 Claude Code 今年已有约 244 次发布,超过四分之三改了系统提示或工具描述,默认 Bash 工具说明近 3000 token,整体仍比 Pi 繁重得多。他承认 Anthropic 做了开创性产品,也在自己决定后一天宣布支持 AGENTS.md——但对他来说已经太晚;Pi 更稳定、更极简、也更好扩展。
HN 讨论把「Anthropic 为留住他才支持 AGENTS.md」读成玩笑,作者本人也现身承认并不出名。主线很快转向开源 harness:有人说无法忍受Anthropic 官方客户端闭源与「不情愿才跟进标准」;也有人对比 Codex CLI 的授权与控制力,称离不开 Pi 的 /tree 等能力。另一些评论强调亚洲开源模型把替代方案推到「日常可用」,美国两家仍领先但不再是唯一选择。总体情绪是:仍认可 Claude Code 的能力,对产品愿景与稳定性失望的人正在认真试开源路线。
llama-modchip:64GB 内存、零 GPU 跑 284B DeepSeek
开源项目 llama-modchip(Apache 2.0)为 ggml/llama.cpp 添加补丁,让稀疏 MoE 尽量只靠系统内存推理。标杆配置是 DeepSeek-V4-Flash:总参数量为 284.33B,每次激活约 13.17B;经 Fractal 量化后占用约 56.56 GiB(平均每个权重约 1.71 位),在 64GB 内存的 Linux 机器上,进程驻留内存峰值 VmRSS 约为 57.61 GiB,无需使用交换空间;16 核 Zen 5 上预填充约 44 tok/s,生成约 9.1–14.7 tok/s(配合 Stockfish-PVS 草稿模型)。较小的 Nemotron-3.5-30B-A3B 可在 16–32GB 机器上跑到约 25–60 tok/s。技术点包括多级寄存器/缓存分块、SwiGLU-H2 尺度匹配,以及约 13ms 的 /dev/shm KV 槽恢复,方便代理恢复长会话。
HN 评论首先关注量化位数与质量。有人认为低于 4/5 bit 通常「很烂」;也有人反问:和同容量能跑的别的模型比呢?经验帖称 32–64GB 内存是本地模型真正好用的门槛,但过低量化常靠速度唬人。另有人引用 DeepSeek 某些 2-bit 量化在部分基准上接近 FP8,同时提醒要看完整的 KL 散度和质量曲线,不能只看精选分数。使用 128GB 内存苹果 M 系列电脑的人说「能跑」不等于「坐在桌前舒服」,更适合整夜闭环任务。争论的实质是:极限塞进大 MoE 的工程乐趣,与日常交互所需的质量之间的落差。
 github.com/synchopate/llama-modchipllama-modchip
如何对抗「AI 脑疲劳」
Sergey Kuhne 描述终端里同时开 Claude Code / Codex 多标签后的典型崩溃:第一个任务还在跑就开第二个,澄清与旁支各自再开标签,最后在二十来个上下文间跳转,忘了从哪开始、要到哪结束。他的实验是把待办工作组织成 git 仓库里的优先队列:每张工单对应一个放在仓库旁的 Markdown 文件,看板状态随提交保存为快照;代理按周期调研、实现人类已标记为可以开发的工单、跑测试与浏览器检查,敏感改动走分支并先问人,从不直接部署生产。所有等待人类决定的事项汇入「owner inbox」,脚本按优先级列出;阅读界面则是一个根据 git 内容重建的 Claude artifact 单页应用。核心纪律是:一次只取一项、加载上下文、做决定,再关闭工单,把上下文存回队列——关单本身就是在清空脑内 RAM。
HN 一边共鸣「代理思考时可以休息,就像以前等编译一样」的 xkcd 梗,一边有人批评文章本身像 AI 灌水。实用派分享说,自己的瓶颈也在测试、编译与 UI 操作上,这些环节不会随着模型加速而消失;有人用语音创建任务、再让模型连环追问澄清。反对「同时开二十个代理」的人建议:代理在跑时去做别的喜欢的事,不要接着再开一个代理。还有老程序员坦言现在怕面试手写题,「AI 脑疲劳」并不夸张。讨论把个人工作流实验,扩成了「如何在代理时代保留判断力与节奏」的集体诉苦。
sergeykuhne.comHow I'm fighting the AI Brain Fry系统与桌面
十美元 OpenStick 上的微型家用实验室
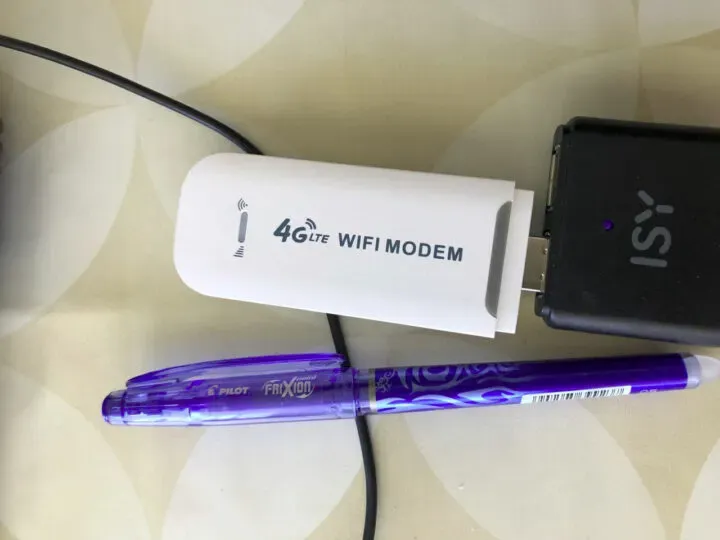
Bosscher 买了一台含运费约 10 美元的 OpenStick:约 512MB 内存、四核 1GHz Cortex-A53、4GB eMMC、Wi-Fi、4G/GPS,被动散热无声。刷上 Debian 后用 systemd 与 Podman,跑了一堆「吃内存很少」的服务:CastSponsorSkip 跳过 Cast 上的赞助段落;自行修改的 AdGuard Home 占用约 40MB 内存,用于过滤 DNS 查询(自称可挡约 60% 查询);Zeroclaw AI 代理运行框架空闲时的驻留内存约为 3MB,可经 Telegram 查询日志与磁盘情况;Cloudflare Tunnel、Beszel 监控、Dozzle、Gatus、Fusion RSS、Shiori 书签归档、Diun 容器更新提醒等。他把 Zeroclaw 的权限限制在这台机器上,接受「虽然给了代理 root shell,但影响范围只限于这台小机器」的权衡。
HN 分数极高,气氛偏怀旧与「小机器能做事」。有人推荐 WireGuard 卸载网关流量;也有人质疑为何要 4G 月费、以及 OpenStick 项目页面是否过时。安全讨论围绕「给代理根权限」:有人建议只给只读用户,也有人强调自己动手才能校验代理输出。另有人联想到青少年从垃圾桶捡电脑组装的故事。大家交换了不少低成本自建服务的清单。
blog.bosscher.chWhat I run on my $10 USD OpenStick homelab
Outlook.com 开始拒收无 DMARC 域名的部分邮件
MailRoute CEO Thomas A. Johnson 写道:自 2026-11-05 起,微软消费级邮箱服务(outlook.com / hotmail / live / msn)对未发布 DMARC 记录的域名,开始以 550 5.7.1 Message lacks SPF/DKIM/DMARC Auth Records 拒收部分邮件。这与 2025 年 5 月起针对每天发送 5000 封以上邮件的批量发件规则不同:小发件人也会中招,微软未发公告,且只拒收部分邮件,容易误以为是偶发故障。常见的修复方法是添加一条 _dmarc TXT:v=DMARC1; p=none。作者强调 DMARC 仍需 SPF 或 DKIM 与 From 域对齐;通过 MailRoute 发送邮件的用户往往只差这一条记录。
HN 上系统管理员与小站长共鸣强烈:有人刚撞上这种「时通时不通」的退信。讨论提醒 p=none 只是起步,要进一步防止伪造,还需要采用 quarantine 或 reject 策略;也有人吐槽大厂静默改规则。
 mailroute.netOutlook.com Is Quietly Rejecting Email from Domains Without DMARC
Dux:面向 niri/Hyprland/Sway 等的开源 Wayland 桌面套件
Dux Labs 展示免费开源的现代 Wayland 桌面套件:Dux Modular Shell(动态主题与动画)、键盘优先的文件管理器 Dux Files、系统监控 Dux GOP、基于 greetd 的登录界面 Dux Greeter、快速搜索与日历等,并宣称支持 niri、Hyprland、Sway、labwc 等。站点提供基于 Fedora 的不可变发行版 Zirconium,以及 MiracleWM 的 Fedora Spin。主题引擎 dank16 可为 GTK/Qt、终端与编辑器生成匹配的 16 色浅色/深色方案。项目靠捐赠维持。
HN 对「又一个漂亮的 Wayland shell」既兴奋又谨慎:有人喜欢接近 Windows 2000 时代的效率手感,也有人对 curl | sh 安装方式不安,希望最终进发行版并被充分审阅。GNOME 用户则讨论安全与生态之间的取舍。分数中等,但评论主要围绕产品体验展开:桌面 Linux 用户仍在寻找「开箱即用又好看」的组合。
 duxlabs.devDux
企业与产品
高盛收回银行家与交易员的 Claude Code
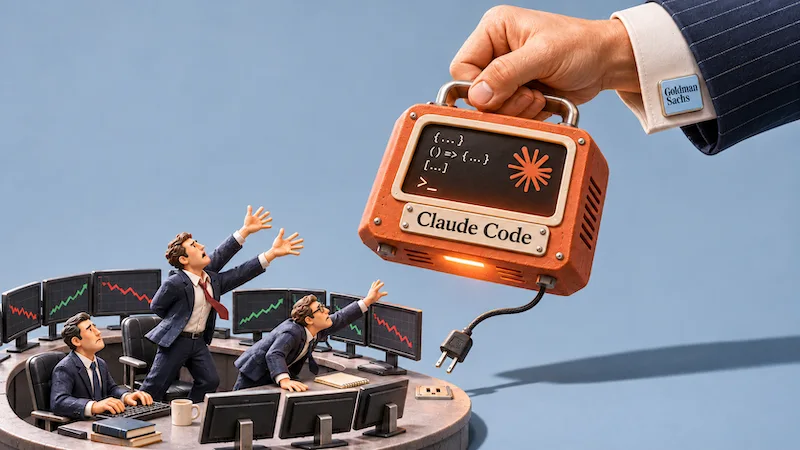
State of AI 转述彭博消息称,高盛 10 月更新内部指引,把 Anthropic 的 Claude Code 与微软 GitHub 的编码能力限制给工程师;跨交易、量化与工程的 Strats 仍可使用。交易员与银行家此前用这些代理监控客户流向、建模仓位并生成材料,有人对此感到沮丧。讽刺的是,CIO Marco Argenti 7 月还在赞扬非技术员工的「vibe coding」,并把原型交给约 1.2 万名工程师打磨;4 月香港银行家也曾因合同地域限制失去 Claude。文章指出:代理在交易桌写未审代码会绕过评审、测试与部署,也可能破坏信息隔离墙;按 token 计费的成本也是考量之一。高盛仍是 Anthropic IPO 的联席主承销商之一,后台由 Anthropic 工程师协助建设的代理仍由工程团队运行。
HN 首先有人指出 State of AI 站点可疑、原文更宜看彭博。讨论焦点是:监管行业限制非工程师跑代理是否合理。支持者强调未审代码与信息墙已足够构成理由;反对者与挖苦者说工程师自己也在「看不懂就上线」,所谓 agentic engineering 若真成熟就该人人可用。也有评论用「红皇后竞赛」比喻:别人都在用时,停用本身就是劣势,就像当年纽约为交易铺光纤省几毫秒。还有人讨论员工用公司工具出事后的责任归属。整体上,社区更关心「谁有权写代码、谁必须审查」,对投行八卦本身的关注反倒有限。
 www.thestateofai.comGoldman Sachs Is Pulling Claude Code From Its Bankers and Traders
OpenAI 以约 1.25 万亿美元估值完成首笔 110 亿美元融资
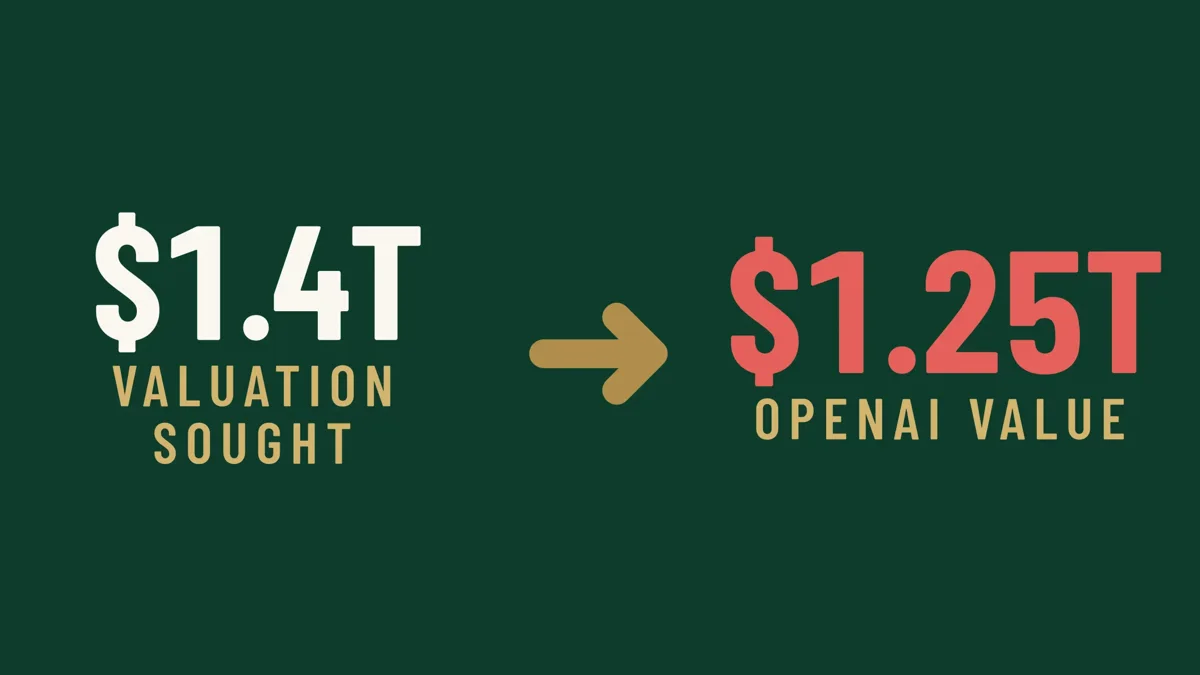
24/7 Wall St. 报道,知情人士称约 110 亿美元已在 11 月 6 日前后打入 OpenAI,对应约 1.25 万亿美元的投前估值,由 CFO Sarah Friar 在电视采访中确认;软银与阿布扎比 MGX 参与。媒体曾传公司想以 1.4–1.5 万亿美元募资 300 亿美元以上,Friar 否认更高数字出自公司。本轮估值较 3 月大额融资时约 8520 亿美元的估值高出约 47%,但第二笔最高约 90 亿美元的融资尚未完成。Friar 称三季度业务环比增长约 70%,企业业务翻倍,ChatGPT 周活跃用户约 12 亿,广告业务年化规模约 10 亿美元。文章强调这对微软(OpenAI 股权公允价值波动)与英伟达(实验室融资能力支撑算力订单)含义不同。
HN 把讨论拉到「万亿俱乐部」:有人列出约 14 家市值过万亿的公司,质疑私人实验室估值是否合理;也有人说若相信「数字神」叙事则仍算便宜。怀疑者称仍是软银、MGX 等同一批人互相抬估值以便退出;乐观者则谈广告与购物推荐能否挑战谷歌广告帝国。另有人拿市值总和对比美国 GDP,随即被指出市值与 GDP 量纲不同。同期的 Anthropic 上市预期也被拿来对照:两边私人估值都在随 AI 股票回调而下修。
 247wallst.comOpenAI Just Raised $11 Billion at a $1.25 Trillion Valuation
斯特劳贝尔卸任后的特斯拉新品困境
CleanTechnica 作者梳理:JB Straubel 2019 年 7 月卸任 CTO 后,特斯拉难以指出真正成功的新产品。Model Y 在其卸任前夕揭幕,可视为他经手的最后大型项目;此后 Cybertruck 预订神话破灭——有评论汇总称,公司按年产约 12.5 万辆的规模投入生产设备,但三年约卖出 7 万辆;研发投入约 20 亿美元,毛利约 1 亿美元,项目净亏约 19 亿美元,且售价约翻倍,续航约减半。Semi 长期推迟,更便宜的量产小车未真正推出,Cybercab 才刚进入生产。作者猜测 Cybertruck 方向是否导致分歧,并承认斯特劳贝尔仍在董事会、许多内情未知;他认为,「卸任后没有对标 Model 3/Y 的成功新品」是可以观察到的情况。
HN 对因果归因很谨慎:有人说特斯拉已不再把自己当车企,估值押在 Robotaxi 与 Optimus;也有人认为缺的是能约束马斯克科幻冲动的产品领导力。讨论延伸到责任保险、FSD 叙事与「停止讲故事则股价回落至车企」的警告。支持 Cybercab 的人要再等结果;怀疑者觉得自 Straubel 离开后的发布节奏本身就说明了问题。
 cleantechnica.comTesla Hasn't Had a Successful New Product Launch Since JB Straubel Stepped Down As CTO
思考与脑科学
写作是一种思考工具
分布式系统研究者 Murat Demirbas 回顾:中学时靠思维导图笔记才读得进长文;读博时读到 Manuel Blum 给学生的劝告:有限自动机与图灵机的差别在于后者有纸笔,没有书写,你就像降级成了有限自动机。他把写作比作借助外部存储的计算(out-of-core computing):写同行评议时才发现自己其实只懂六成;2018 年一篇随手对比 Paxos 与中本聪共识的短文,后来长成正式论文。面对 LLM,他警告:模型读过文献却读不到你半成形的直觉;一上来就和模型聊天,就丢掉了自己书写和思考的机会。亚马逊六页备忘录曾是「写清楚才能想清楚」的象征,如今用模型就能轻易生成六页文字,写出备忘录便不再足以说明作者自己已经想清楚。他给出五条:先自由地写下想法,再认真编辑,保持简明,不以迎合观众为目的,并把写作排进日程。
HN 几乎是一场文具与方法分享会:方格本、多色圆珠笔、把服务/托管/外部 API 用颜色区分的纸上架构图,以及「设计在纸上完成再交给 Claude」的设想。有人坚持复杂产品流程仍需要静态推敲,不能全靠 LLM 原型;也有人用数位板折中。Lamport 那句「不写就只是以为自己在想」被反复引用。这些讨论给出了保留自主写作和思考的日常做法。
muratbuffalo.blogspot.comWriting as a thinking tool消费级脑电头带:用户数据被拿去训练「大脑基础模型」
《科学》与普利策中心联合调查写到,Interaxon 的 Muse 头带用户 Adnan Jinnah 用设备改善睡眠,却不知道自己的脑电等信号可能被用于训练公司的「brain foundation model」;公司称已用约 5 万小时经过去标识处理的用户脑电图(EEG)数据训练模型,并在《科学》指出后才更新隐私政策明确告知。调查审阅了全球 57 家消费神经科技公司的隐私政策:多家未明确披露脑数据用途;多家正在竞赛式构建大脑基础模型;几乎都允许向第三方共享去标识数据或应要求向执法机关提供。专家强调脑信号不同于心率,UNESCO/OECD 与联合国秘书长报告也警告神经科技对人权的风险。智利曾判决 Emotiv 删除参议员数据;美科罗拉多、加州等已把神经数据列为敏感信息。
HN 评论中既有夸大的理解,也有科普纠正:有人把「脑波」误解成可远程影响他人的武器,被纠正为监测而非发射。严肃评论则赞同「应单独明确同意」,并对去标识后仍难以撤回的训练数据感到不安。也有人认为消费 EEG 质量有限、读心尚远,但同意知情权不可少。帖子把「可穿戴健康」讨论推进到神经权利立法议程。
www.science.orgWearable device makers are harvesting brain data to train AI—without telling users