Ahmad Osman:为什么本地 AI 正在追赶
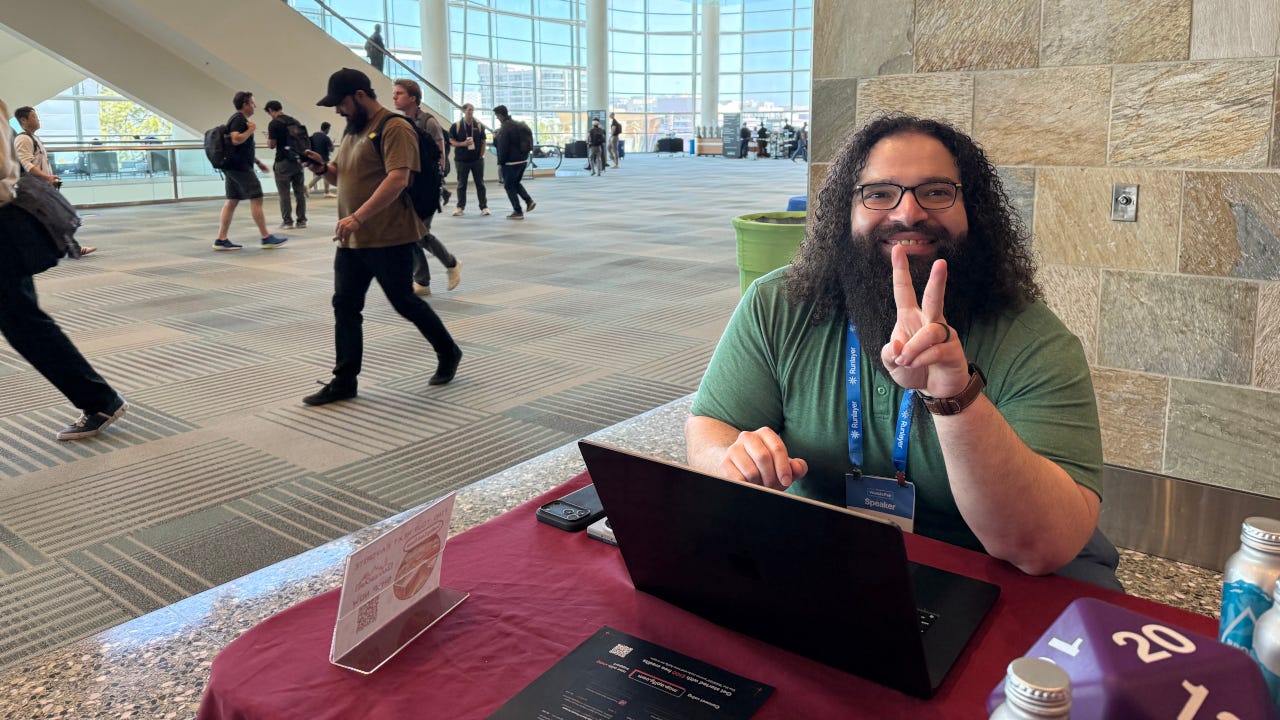
Ahmad Osman 在当天的 AI Engineer World's Fair 现场。
Ahmad Osman 很早就开始倡导本地 AI,也就是在自己的电脑、工作站或专用硬件上运行模型,远早于它成为今年 AI Engineer World's Fair 的重要主题。他也是 Osmantic 的创始人,这家公司正在构建用于部署和运行本地 AI 系统的开源软件。
AIEWF 上浮现的一个主题是,开源大语言模型正在成为大型专有前沿模型越来越可信的替代选择。由于大多数本地 AI 系统依赖开放模型,这种变化加强了 Osman 一直提出的主张。正如他对 Latent Space 所说:“开源模型与封闭前沿模型之间的差距一直在缩小。”
Osman 在名为 Open Source AI Must Win 的网站上更明确地提出这一主张。他写道:“无需请求许可,就能研究、构建、修复、部署、审计、适配、教授、保存和运行智能系统的能力,具有关乎存续的重要性。”
在 AIEWF,Osman 主持了一个分两场进行的工作坊,介绍本地大语言模型和工作站智能体。这些活动展示了这个领域的发展有多快:从在手机和笔记本电脑上运行模型,到专用 GPU 工作站和企业基础设施。
对 Osman 工作坊感兴趣的人,也不只是硬件爱好者。参与者既包括考虑购买第一台具备 AI 能力的电脑的学生,也包括思考模型路由、私有基础设施和公司数据控制权的企业高管。
在下面的问答中,Osman 解释了为什么本地 AI 正受到更多关注,模型和硬件格局发生了怎样的变化,以及为什么他预计更多开发者和企业将开始把本地 AI 当作严肃的基础设施。
让人们实际感受到本地 AI
Latent Space: 能概括一下工作坊的内容,以及参与者希望了解什么吗?
Ahmad Osman: 工作坊分为两场,报名需求超过了场地容量。很遗憾,有些人没能参加。
我带来了一个我们为演示本地 AI 准备的网站。它基本上是一个硬件竞技场,让人们比较 DGX Spark、AMD Strix Halo 机器和其他设备。你可以让它们相互较量,或者与前沿云端模型比较,亲自观察性能、输出质量、速度和延迟。
主要想法,是让本地 AI 显得真实可用。有些人对它的认识仍停留在 2022 年,当时模型的能力要弱得多。但此后,一切都有了显著改善。
它与前沿模型仍有差距,可能落后四到八个月,但本地模型和开放模型正在追赶。我们希望人们亲自与这些系统交互,而不是只听关于它们的理论论证。
演示背后的软件是开源的,可以在 GitHub 上获取。第二场工作坊进一步介绍了如何搭建,并展示了完整系统的实际运行。
模型只是系统的一部分
Latent Space: 当人们把本地 AI 仅仅理解为在自己的机器上运行模型时,忽略了什么?
Osman: 人们对 ChatGPT 或 Claude Code 这类产品有一个很大的误解。它们在模型和智能体周围配备了完整的基础设施。它们并不只是一个东西。
我的一个朋友买了一块 RTX 5090,想在本地运行 Qwen 3.5。他把 Claude Code 连接到这个模型,让它改变 GPU 的 RGB 灯光,但没有成功。随后,他使用托管的 Claude Code 服务,就成功了。
我问他,有没有给本地模型提供互联网搜索权限。他没有。模型的训练数据有一个截止日期,而他需要的软件和文档,在那之后已经发生了变化。
我们给本地系统提供一个搜索端点后,它就能完成这个任务了。
重点就在这里:使用托管智能体时,你使用的不只有模型,还有围绕它的搜索、工具、基础设施和其他服务。
通过我们的开源部署系统,我们试图提供完整体验,从聊天界面和文档导入,到智能体、运行框架(harness)和搜索工具。本地 AI 生态系统一直缺少这样一个端到端的层。
学生、爱好者和企业都感兴趣
Latent Space: 谁参加了工作坊?主要是硬件爱好者,还是想构建隐私应用的人?
Osman: 参与者的范围非常广。
第二场工作坊结束时,一个学生问我,上大学前应该买什么硬件。一位英特尔高管问,怎样让软件以某种特定方式在 Windows 上运行,来改善用户体验。
有些人是爱好者。其他人提出的问题则非常关注企业场景。共同点是,他们都想运行自己能够控制的东西,无论是 MacBook 上的一个模型、家中的一块 GPU,还是一套高端企业硬件的专用集群。
有人问企业模型路由、数据收集、调用轨迹、智能体沙箱和延迟。还有人问我家里有多少块 GPU。答案是 22 块 RTX 3090。
兴趣范围之广让我惊讶。这是我的第一个 AI 工作坊,我很幸运,能够连续举办两场。
你可能不需要购买 GPU
Latent Space: 开发者需要出去买 GPU,才能尝试本地 AI 吗?
Osman: 这取决于你想使用的模型大小。
你可以在 MacBook 上运行一个四位量化的 Qwen 模型。在另一个极端,一个非常大的、达到前沿水平的开放模型,可能需要多块 RTX Pro 6000 GPU。
但更广泛的趋势是,模型正在变得高效得多。在现代手机上,你现在可以运行一个模型,其表现超过了人们仅在几年前使用的云端系统,而且不需要占用设备的全部内存。
这说明,在相对短的时间内,模型效率已经取得了很大进步。
模型与硬件一起进步
Latent Space: 进步主要来自更好的软件和模型,还是也来自硬件?
Osman: 模型已经有了巨大的改善。
架构正在变得更高效,许多小的改进会叠加。一旦前沿实验室证明某项能力是可行的,开源生态系统就能从这个结果反向探索,找到更高效地复现它的方法。
我们正在看到,拥有数百亿参数的模型,能达到以前需要大得多的系统才能达到的表现。其中一些模型可以运行在 2020 年发布的 RTX 3090 上。两年前,要在这样的硬件上达到这种能力水平,并不现实。
这仍然是一个很新的领域,我们不知道它最终会是什么样。但我们知道,这些系统会继续改善。
混合式 AI 与自主可控 AI 的兴起
Latent Space: 你预计会有更多应用把本地 AI 与云端 AI 结合起来吗?
Osman: 会。边缘模型会变得更普及,而且这不只关系到消费者。
企业越来越意识到,它们所依赖的模型,可能不会总以相同的形式向它们提供。提供商可以改变质量、价格、访问权限或政策。
这会促使企业转向专用硬件,并确保自己掌握算力。硬件不一定要放在企业自己的场所。公司可以使用由自己控制、放在托管机房中的专用硬件。
好处是,模型的质量不会意外改变,访问权限不能被随便取消,而且公司能保留对知识产权、数据、隐私和合规义务的控制。
开源模型也在继续缩小与前沿专有系统的差距。我们已经看到从 Llama、Mistral、Qwen、DeepSeek、GLM 到 Kimi 的快速发展。每一代都在缩小差距。
专用模型可能才是真正的机会
Latent Space: 你认为这会把企业带向哪里?
Osman: 一段时间以来,我一直相信,对于许多商业用例,更小、更专用的模型代表着未来。
企业可能从通用模型开始,收集员工使用过程中的调用轨迹、消息和反馈。随着时间推移,这些数据可以支持一个更专用的模型,针对公司的具体工作进行调整。
这可以改善表现、降低成本,让系统对业务更有用。
我也认为,开源模型公司可能会越来越多地通过针对微调、强化学习或专门商业部署的许可来获得收入。
随着更多公司不再完全依赖云端 API,并确保自己拥有算力,这些实验室会有动力继续发布强大的开放模型,同时在企业针对专有用例适配模型时获取价值。
更广泛的方向,是走向更大的自主权:让公司和个人控制自己的模型、算力和数据,同时继续受益于开源生态系统的快速进步。