算力紧缺之后是什么?
算力紧缺之后是什么?
算力,正在成为人工智能发展最硬核的瓶颈。Martin Alderson 延续他对 AI 算力危机的系列探讨,在这篇文章中点明了当前局势的荒诞性:OpenAI 和 Anthropic 公开承认算力不足,GitHub 提交量三个月内年化增长 14 倍,AI 公司的需求远超供给,以至于不得不靠限制用户使用来勉强维持运转。但问题的根源不在于 GPU 芯片本身,而在于物理世界的节奏跟不上数字世界的野心——GB200 的全液冷方案在千兆瓦级数据中心中几乎是从零开始,熟练工人和高端管道组件双双短缺,Stargate 项目甚至卷入地缘政治漩涡。更底层的 DRAM 制造约束,让供给侧的改善只能以年为单位缓慢推进。作者断言,未来 18 到 24 个月将被算力短缺所定义。这篇文章的价值在于,它把我们对 AI 发展的宏大想象拉回到物理现实的冰冷约束中,让人重新思考:当需求呈指数级增长而供给只有线性改善时,这场算力争夺战将如何重塑整个行业的格局?
我认为,鉴于 OpenAI 和 Anthropic 现在都公开承认自己(非常?)缺乏算力,现在正是延续我之前两篇文章——《即将到来的人工智能算力危机》和《人工智能算力危机到来了吗?》——相同主题的好时机。
使用量正在爆炸式增长
我偶然看到了 GitHub COO 发的一条非常有趣的推文,它充分凸显了世界正在经历的变革规模:
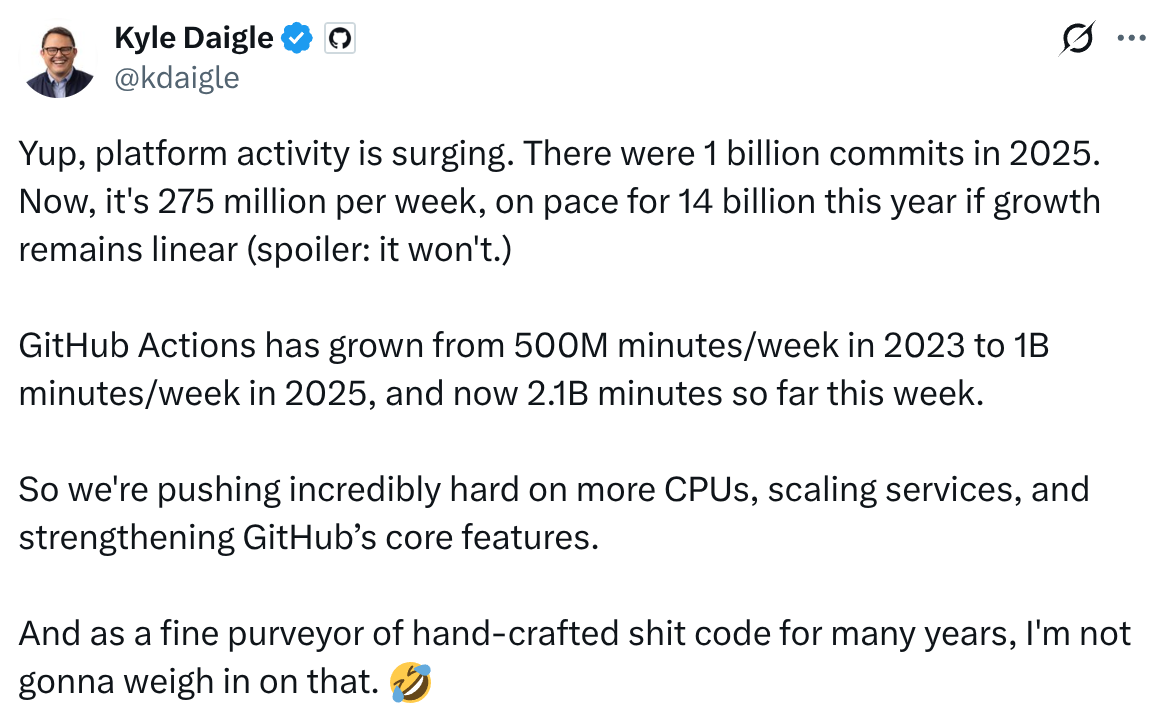
这张图显示,GitHub 在过去 3 个月内(!)的提交数年化增长约 14 倍。提交数量是推理(inference)需求的一个粗略代理指标——但即使只作为方向性参考,如果我们假设增长的大部分来自编码智能体(coding agents)进入主流,那么它也指向推理算力需求的急剧增长。
实际上,这很可能是一个巨大的低估——许多刚接触"氛围编程"(vibe coding)的人不太可能快速掌握 Git(Hub)——分布式源码管理对非工程师来说相当令人困惑(至少对我来说,作为一名工程师,完全熟练掌握它也花了我比愿意承认更久的时间)。
此外,这还不包括所有不太可能触及 GitHub 的 Cowork 使用量。
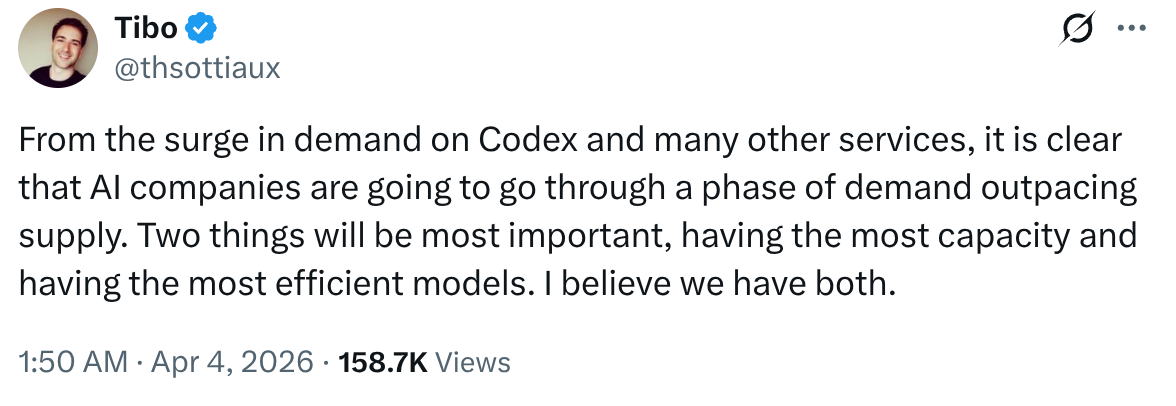
OpenAI 的 Thibault Sottiaux(Codex 团队负责人)最近也发推称,AI 公司正在经历需求超过供给的阶段:
一直有传言说——而且在我看来,考虑到视频生成对算力的巨大需求,这极有可能——Sora 被关闭是为了释放算力用于其他任务。
所有 AI 公司都强烈感受到这一点。更糟糕的是,这还会产生多米诺骨牌效应——当 Claude Code 开始收紧使用限制或遭遇算力相关宕机时,人们就会转向 Codex 或 OpenCode 等替代品,从而给它们带来更大的压力。
到底发生了什么?
正如我在之前的文章中所说,我认为所有人都看错了那些 OpenAI、Anthropic、Microsoft 等在 2025 年左右签下的"疯狂"算力交易——它们当时的签约频率之高,仿佛再不签就要过时了。
签署 1000 亿美元的"承诺"来购买大量 GPU 容量,并不意味着这些容量就凭空出现了。需要浇筑混凝土,需要接通电力,需要订购天然气轮机1,还需要制造、上架和组网 GPU。所有这些产品都供不应求,所需的劳动力也同样短缺。
我认为值得强调但经常被忽视的一个关键点是 GB200(NVIDIA 的最新芯片)的部署过程有多么困难。与 NVIDIA 前几代 GPU 不同,GB200 系列采用全液冷方案——而非此前的风冷。
在千兆瓦(gigawatt)规模下,液冷技术在数据中心中以前几乎没有真正实现过。据我所知,这一过程异常痛苦。液冷显著提高了功率密度(power density/m²),这使得所需的电气工程更加困难——再加上熟练劳动力的实际短缺2来进行管道连接——甚至各种高端管道组件的短缺,导致大部分(全部?)GB200 的部署严重滞后于计划。
虽然这些问题无疑会得到解决——供应链也会在交付液冷部件方面积累经验和速度——但这无疑给短期到中期内可用的算力带来了更大压力。
更糟糕的是,Stargate 在阿联酋正在建设的 1GW 数据中心,如今已成为当前美伊冲突中地缘政治紧张局势的一枚棋子——伊朗政府发布了一段以该工地为特色的视频。
我在之前关于这个主题的文章中谈到的长期问题,是 DRAM 制造的硬约束。虽然 SK 海力士最近与 ASML 签署了一项价值 80 亿美元的协议,用于采购更多 EUV 生产设备,但预计至少还需要几年才能投入使用。事实上,我注意到 Sundar Pichai 最近在 Stripe 播客的亮相中,特别指出内存是一个重大约束。
虽然像 TurboQuant 这样的近期创新通过 KV 缓存压缩在降低内存需求方面极具前景,但考虑到 AI 使用量的增长速度,这充其量只能赢得短暂的喘息空间。
接下来会发生什么?
我认为未来 18-24 个月将由算力短缺所定义。当需求呈指数级增长而供给端只有线性增长时,市场将变得相当动荡——至少可以说是如此。
裂缝已经显现。Anthropic 的可用性如今以"一个九"的可靠性闻名,而且似乎没有任何改善的迹象。我并不羡慕那些试图在部署新模型和效率策略的同时,努力扩展这些系统的 SRE 团队所承受的压力。
我们已经看到 Anthropic 在 Claude 订阅方面推出了越来越严厉的措施——从大幅削减"高峰时段"的使用限制,到现在甚至禁止从第三方智能体框架(agent harnesses)使用 claude -p——毫无疑问是为了减少需求。
问题是,如果我在文章开头的猜测是正确的,即 Anthropic 的推理需求环比增长约 10 倍,那么仅靠禁止第三方使用产品能做的也十分有限——第一方使用很快就会把这部分容量吃光。
而基于时间的配给制——尽管在平抑高峰和低谷方面极为有效——也只能做到一定程度。最终你会设置足够高的激励,以至于 24/7 全天候满负荷运转。这并不是说他们在这一领域没有更多可以(也将会)做的事情,但当面临这样的需求增长时,这终究无法让你达到稳定状态。
这样一来,实际上只剩下一个杠杆可以拉动——价格。我在之前的文章中对于大幅提价曾犹豫不决,因为在这个万亿美元级别的竞赛中,获取市场份额对每个参与者都至关重要,但如果所有 AI 提供商都缺乏算力,那么我认为涉及的博弈论发生了变化。
但这其中的悖论在于,随着模型越来越好——关于 OpenAI 和 Anthropic 新模型"Spud"和"Mythos"的传闻也指向这个方向——用户对价格的敏感度反而降低了。虽然当 ChatGPT 首次推出 Pro 订阅时,每月 200 美元对于你能从中获得的价值来说似乎贵得离谱,但我认为我每月 200 美元的 Anthropic 订阅是目前最划算的交易之一,如果必要的话我可能愿意支付更多——即使使用当前的模型。
据我所知,我们正处于一个完全未知的领域。我最近读了很多关于 19 世纪末/20 世纪初欧洲和北美最初电气化的资料,但类比很快就失效了——需求增长要陡峭得多,而供给问题则远没有那么集中。
所以,我们即将发现人们究竟愿意为随时可用的智能支付多少。我的猜测是远比大多数人所预期的要多——这对整个行业来说是极其利好的,同时在短期内对用户来说也将是极其痛苦的。3
从根本上说,我相信对接近或超越人类认知的机器存在近乎无限的需求,即使这种能力在不同领域分布不均。供给最终会跟上。但正是这个"最终"会让人痛苦。
术语表
| 原文 | 中文 |
|---|---|
| agent harnesses | 智能体框架 |
| coding agents | 编码智能体 |
| DRAM | DRAM |
| EUV | EUV |
| GB200 | GB200 |
| gigawatt | 千兆瓦 |
| inference | 推理 |
| KV cache compression | KV 缓存压缩 |
| power density | 功率密度 |
| vibe coding | 氛围编程 |
此文章由 AI 翻译